Melhores modelos generativos de IA de código aberto para jogos (2026)
Última atualização: setembro de 2026.
A questão da IA generativa é a seguinte. Durante anos, os melhores modelos ficaram atrás de chaves de API e preços imprevisíveis. Você montava seu fluxo de trabalho em torno de uma ferramenta, acostumava-se a ela e então acordava com um e-mail informando que os preços haviam mudado. Ou pior: a empresa havia mudado completamente de rumo.
Isso mudou no fim de 2024. Tencent, Alibaba e DeepSeek começaram a lançar modelos que você pode realmente baixar. Modelos que rivalizam com as alternativas fechadas. E, de repente, criadores passaram a ter opções que não dependem do modelo de negócios de terceiros.
E se você pudesse gerar vídeos, assets 3D, músicas e vozes usando apenas modelos sob seu controle? É nesse ponto que estamos agora. Este guia mostra o que é real, o que funciona e o que você pode começar a usar hoje.
Geração de vídeo
Durante anos, geração de vídeo era sinônimo de Runway ou Pika: plataformas fechadas, assinaturas e limites sobre o que você podia fazer com o resultado. Agora? Você pode executar modelos comparáveis no seu próprio hardware.
Geração de texto para vídeo do HunyuanVideo, com saída em 720p pelo principal modelo de vídeo de código aberto
| Modelo | Organização | Parâmetros | Especificações | Hardware | Custo |
|---|---|---|---|---|---|
| HunyuanVideo | Tencent | 13B | 720p, texto+imagem | 80GB | ~$0.20 |
| HunyuanVideo-1.5 | Tencent | 8.3B | 480p-1080p, texto+imagem | 14GB | ~$0.05 |
| Mochi 1 | Genmo | 10B | 480p@30fps | 12GB+ | ~$0.10 |
| LTX-Video | Lightricks | — | 768x512, tempo real | 12GB | ~$0.02 |
| LTX-2 / LTX-2.5 | Lightricks | 19B (2) / 22B (2.5) | 4K, áudio sincronizado, múltiplas tomadas na versão 2.5 | Alto desempenho | ~$0.30 |
| Wan 2.1 | Alibaba | 1.3-14B | 480p-720p | 8GB+ | ~$0.03 |
| Wan 2.2 | Alibaba | 27B MoE (14B ativos) | 720p, MoE | 8GB+ | ~$0.03 |
| CogVideoX1.5-5B | Tsinghua | 5B | 1360x768@16fps, até 10s | 12GB | ~$0.04 |
| SkyReels-V3 | Skywork | 14-19B | Guiado por áudio, referência para vídeo, V2V | Alto desempenho | ~$0.10 |
| MiniMax H3 | MiniMax | 33B | 2K, 4-15s, áudio estéreo, até 9 imagens de referência | Alto desempenho | sem benchmark |
| Step-Video-T2V | StepFun | 30B | Maior T2V aberto, 204 quadros | Alto desempenho | ~$0.15 |
| Open-Sora 2.0 | HPC-AI | 11B | Integração com Flux | Alto desempenho | ~$0.20 |
Pesos: HunyuanVideo ↗ · Mochi 1 ↗ · Wan 2.1 ↗ · Open-Sora ↗
Veja amostras: Galeria do HunyuanVideo ↗ · Exemplos do Mochi ↗ · Amostras do CogVideoX ↗
O que isso significa para criadores
O HunyuanVideo supera o Runway Gen-3 em avaliações profissionais e é totalmente aberto. O porém? Você precisa de hardware parrudo. Uma A100 ou H100 com 80GB de VRAM. Para a maioria de nós, isso significa alugar GPUs na nuvem quando necessário.
O HunyuanVideo-1.5 mudou a equação do hardware. A Tencent o lançou em novembro de 2025 como um modelo aberto de 8.3B parâmetros que roda em uma GPU de uso doméstico com 14GB, oferecendo texto para vídeo e imagem para vídeo em 480p/720p, além de upscaling opcional para 1080p. Um novo mecanismo de atenção seletiva e por blocos deslizantes (Selective and Sliding Tile Attention, SSTA) proporciona uma velocidade de inferência cerca de duas vezes maior que a do HunyuanVideo original. Se você queria a qualidade do HunyuanVideo, mas não conseguia justificar uma placa de 80GB, esta é a versão que realmente pode rodar em casa.
O Mochi 1 é aquele que você realmente consegue executar. Uma GPU de 12GB — estamos falando de uma RTX 3060 — dá conta tranquilamente. O resultado é genuinamente criativo, com uma qualidade artística distinta. Não chega exatamente à fidelidade do HunyuanVideo, mas o processo está sob seu controle.
É com o LTX-2 que as coisas ficam interessantes para jogos. Ele é o primeiro modelo aberto a gerar áudio sincronizado com vídeo. Imagine cutscenes em que o som simplesmente... combina. Sem sincronização na pós-produção. A Lightricks disponibilizou como código aberto os pesos completos e o código de inferência e treinamento em janeiro de 2026, com saída 4K nativa de até 50fps e áudio sincronizado em vídeos de até 20 segundos. Uma ressalva sobre a licença: os pesos abertos do LTX-2 são gratuitos para uso acadêmico e, no caso de uso comercial, apenas para empresas com receita anual inferior a $10 milhões. Portanto, confira esse limite antes de construir um negócio em torno dele. Em setembro de 2026, o checkpoint atual é o LTX-2.5, um modelo de 22B que acrescenta geração nativa com múltiplas tomadas (várias tomadas conectadas com o mesmo personagem e visual), um decodificador de vídeo por difusão no lugar da reconstrução VAE simples e um codificador de texto Gemma 4 12B para prompts mais longos. Tudo isso continua sob a Licença Comunitária LTX-2.x, com o mesmo limite de receita de $10 milhões e a exigência de um contrato pago acima dele.
O SkyReels-V3 (Skywork, janeiro de 2026) é a nova linha aberta que merece destaque. Trata-se de um modelo multimodal unificado que realiza geração de vídeo guiada por áudio, referência para vídeo e vídeo para vídeo em variantes de 14B e 19B. Por isso, é uma opção robusta quando você precisa usar um personagem ou uma imagem de referência para orientar a tomada. O Step-Video-T2V (StepFun) é o maior modelo aberto de texto para vídeo, com 30B, e é distribuído sob uma licença MIT simples — vale conhecê-lo se uma licença permissiva for mais importante para você do que rodar o modelo em uma GPU pequena.
O MiniMax H3 (Hailuo 3.0) é a novidade mais recente entre os modelos abertos e merece atenção para cutscenes orientadas por referências. A MiniMax o lançou como API em 31 de julho de 2026 e publicou os pesos básicos de 33B no Hugging Face em agosto, com dois checkpoints: FL2VA para geração a partir do primeiro e do último quadro e Ref2VA, que aceita até 9 imagens, 3 clipes de vídeo e 3 clipes de áudio como referência (12 arquivos no total) e gera de 4 a 15 segundos em resolução de até 2K, com áudio estéreo nativo. A licença é a MiniMax H3 Community License, e o cartão do modelo solicita que usuários dos EUA, da UE, do Reino Unido e da Coreia do Sul preencham primeiro um formulário de inscrição. Portanto, não é uma solução pronta para uso em qualquer estúdio.
O Wan 2.1 roda em um notebook gamer. Uma GPU de 8GB funciona com as variantes menores. Se você sempre quis criar protótipos com geração de vídeo, mas não conseguia justificar o hardware, este é o caminho.
O Wan 2.2 (Alibaba, julho de 2025) é o primeiro modelo de vídeo de código aberto baseado em uma arquitetura Mixture-of-Experts: são 27B parâmetros no total, com apenas 14B ativos por etapa. Ele é distribuído nas versões texto para vídeo (T2V-A14B), imagem para vídeo (I2V-A14B) e em uma variante híbrida de 5B que roda em GPUs de uso doméstico, todas sob a licença Apache 2.0 para uso comercial.
Uma ressalva importante: o Wan 2.2 ainda é a última versão aberta do Wan. As versões mais recentes — Wan 2.5 (setembro de 2025), 2.6 (dezembro de 2025), 2.7 (abril de 2026) e agora Wan 3.0 (agosto de 2026, com clipes em tomada única de 30 segundos, resolução de até 1080p e entradas de referência, segundo o Alibaba Cloud Model Studio) — adicionaram áudio sincronizado, 1080p e controle mais preciso dos quadros, mas estão disponíveis apenas por API, sem pesos públicos. Em setembro de 2026, a organização Wan-AI no Hugging Face ainda só oferece versões até a 2.2, independentemente do que aleguem os sites de afiliados. Se a hospedagem própria for importante para você, a versão 2.2 é o limite. O LTX-2.5 é o modelo aberto indicado quando você precisa de 4K e áudio sincronizado.
O fluxo de trabalho que faz sentido: Mochi 1 ou Wan 2.1 para criar protótipos localmente. HunyuanVideo-1.5 ou LTX-2.5 em GPUs na nuvem quando você precisar de qualidade final.
Geração de imagens
É aqui que o código aberto já venceu. Os modelos que você pode baixar hoje realmente competem com o Midjourney. Não são “quase tão bons”; são de fato competitivos.
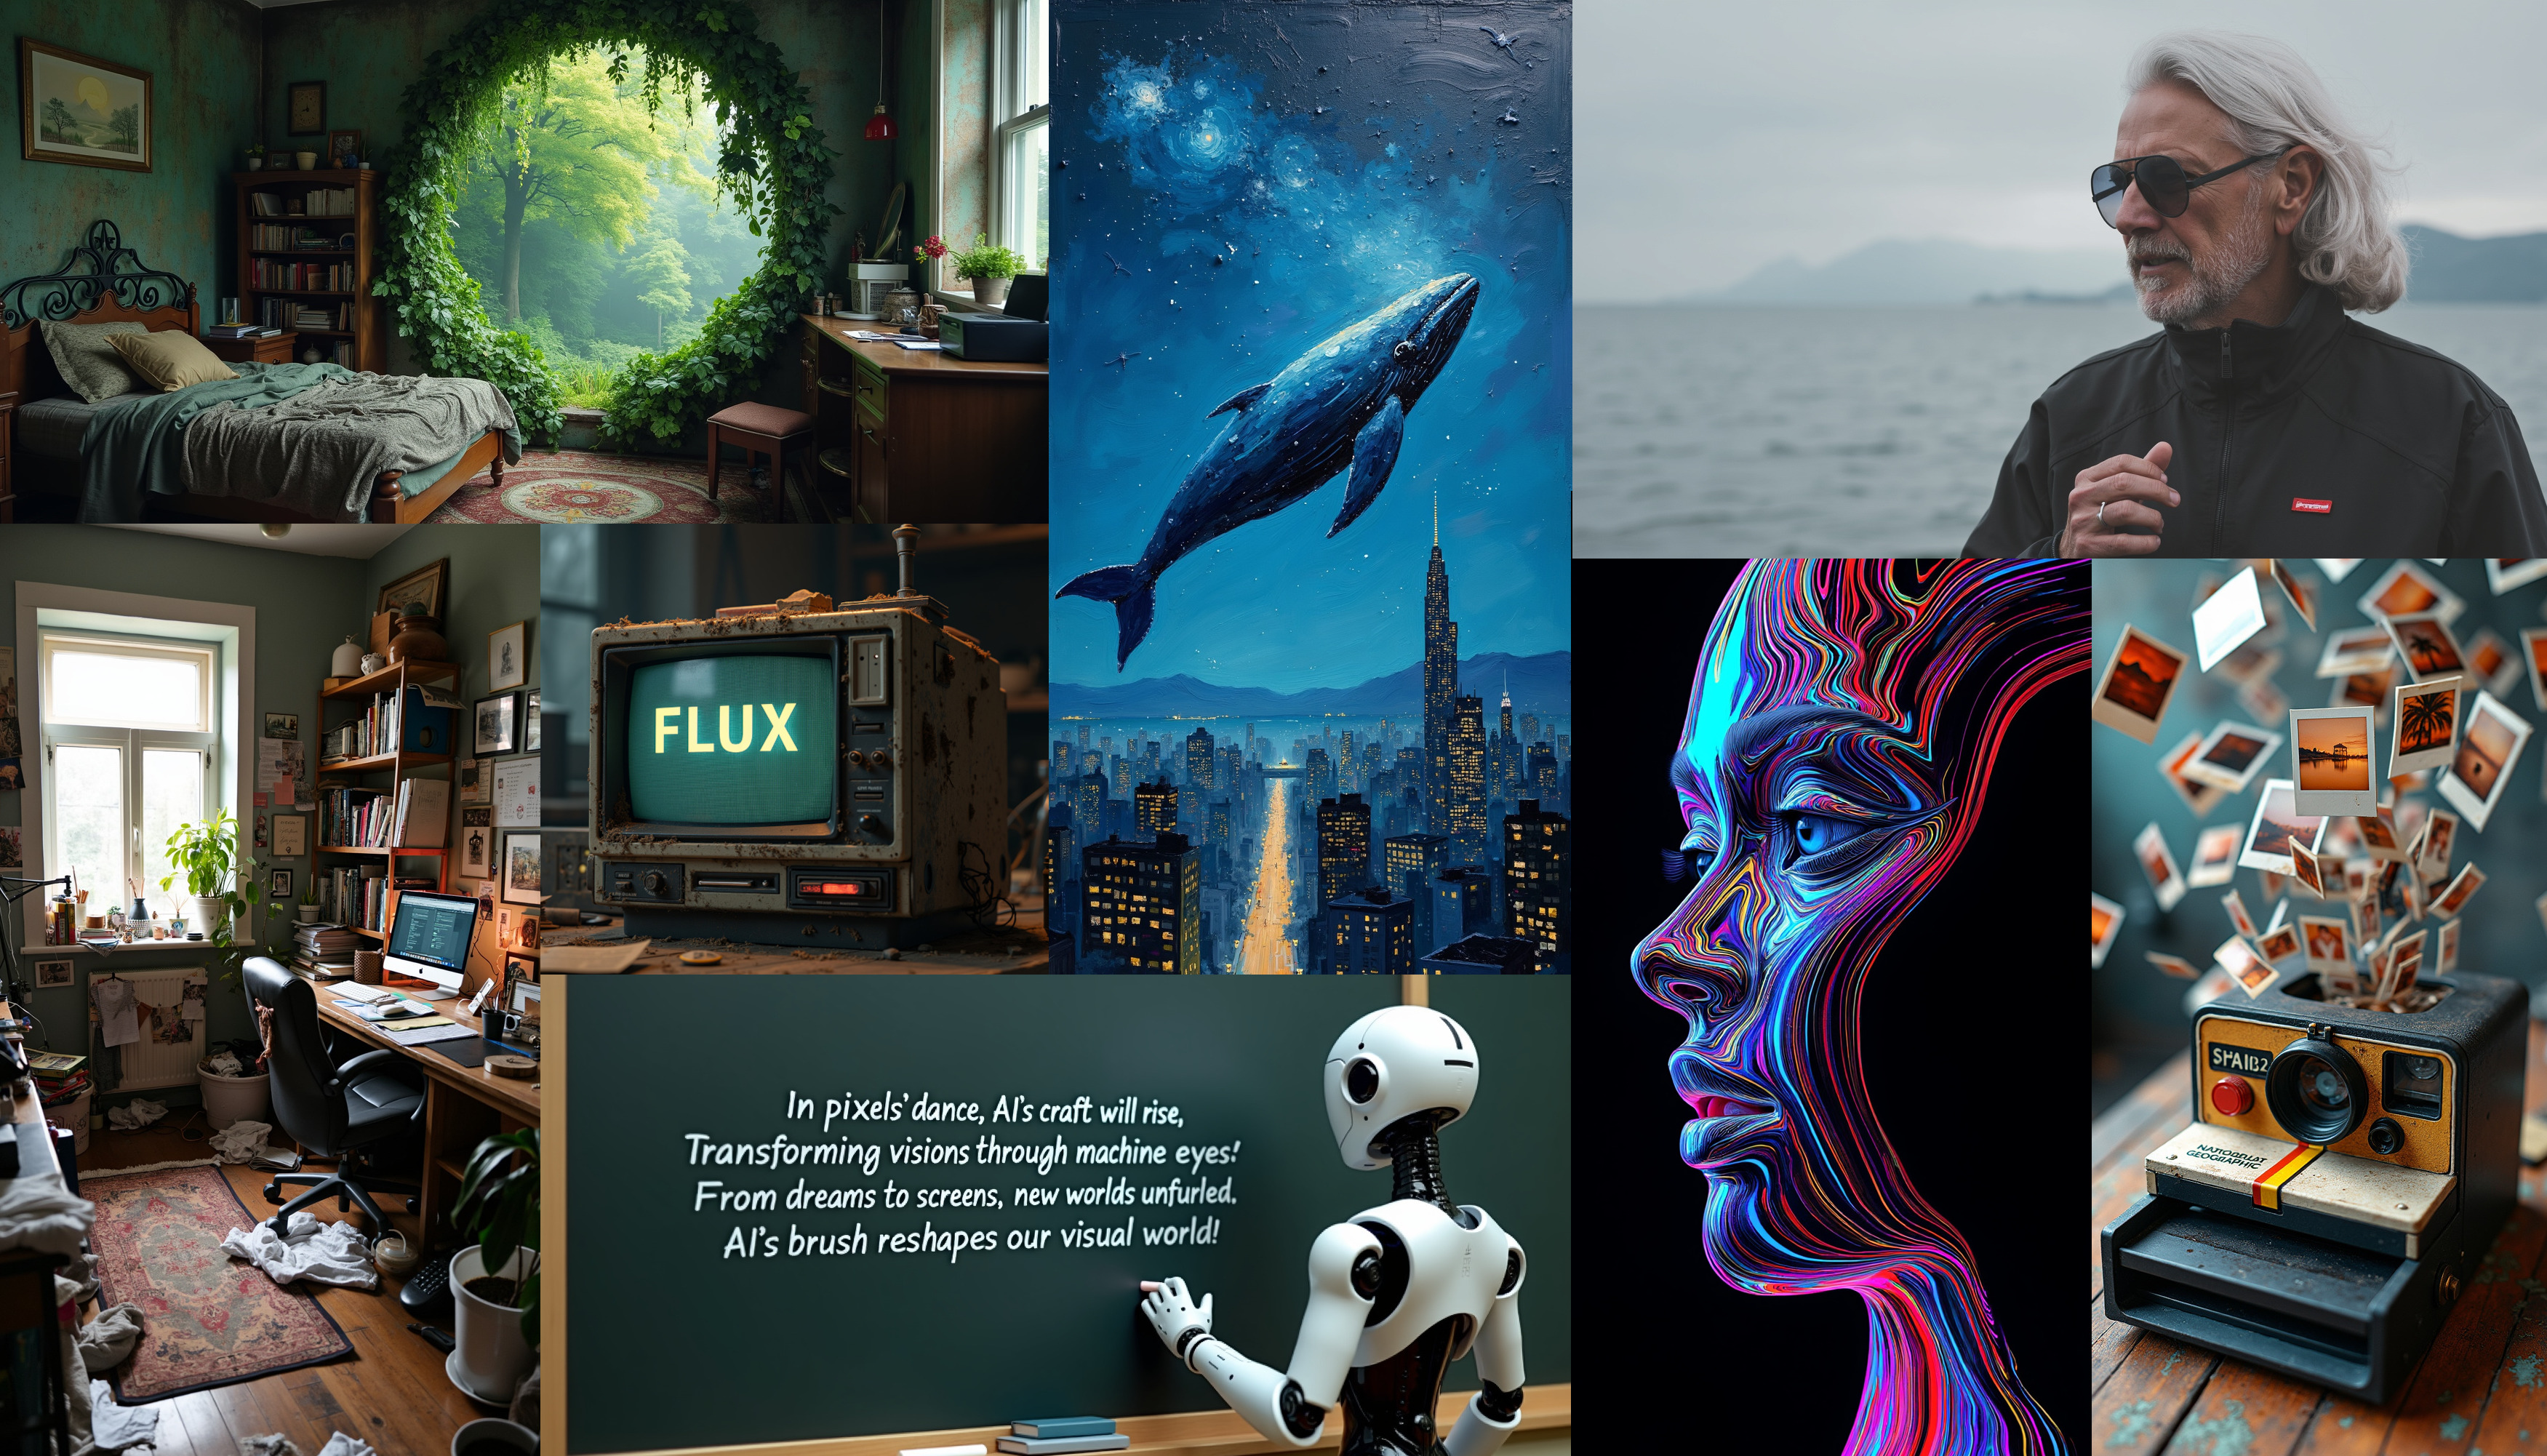 Amostras do FLUX.1, com qualidade fotorrealista, produzidas por um modelo licenciado sob Apache 2.0
| Modelo | Organização | Lançamento | Parâmetros | Principal recurso | Licença | Custo/imagem |
|---|---|---|---|---|---|---|
| FLUX.1 [schnell] | Black Forest Labs | ago. de 2024 | 12B | Geração em 4 etapas, rápida | Apache 2.0 | ~$0.001 |
| FLUX.1 [dev] | Black Forest Labs | ago. de 2024 | 12B | Qualidade próxima à Pro | Não comercial | ~$0.002 |
| SD 3.5 Large | Stability AI | out. de 2024 | 8B | Renderização de texto, estilos variados | Licença Stability | ~$0.002 |
| SD 3.5 Large Turbo | Stability AI | out. de 2024 | 8B | 4 etapas, rápida | Licença Stability | ~$0.001 |
| HiDream-I1 | HiDream.ai | abr. de 2025 | 17B | Alta qualidade, variantes Full/Dev/Fast | MIT | ~$0.002 |
| CogView4 | Tsinghua / Zhipu | mar. de 2025 | 6B | Texto nativo em chinês, até 2048px | Apache 2.0 | ~$0.002 |
| Qwen-Image | Alibaba | ago. de 2025 | 20B | Renderização e edição de texto líderes da categoria | Apache 2.0 | ~$0.002 |
| FLUX.2 | Black Forest Labs | nov. de 2025 | 32B | Texto+edição, 4MP, múltiplas referências | dev: Não comercial / klein 4B: Apache 2.0 | ~$0.003 |
| Ideogram 4.0 | Ideogram | jun. de 2026 | 9.3B | Design, renderização de texto, controle de layout por JSON | Não comercial | ~$0.002 |
Teste-os diretamente: Demonstração do FLUX.1 schnell ↗ · Demonstração do SD 3.5 Large ↗ · GitHub (FLUX) ↗
Veja amostras: Galeria do FLUX ↗ · Galeria de LoRAs do FLUX ↗ · Exemplos no Replicate ↗
Para criar assets de jogos
O FLUX.1 [schnell] é o modelo que você precisa conhecer. A licença Apache 2.0 significa que você pode lançar jogos comerciais sem se preocupar com complicações de licenciamento. Ele gera em apenas 4 etapas, permitindo iterar rapidamente. Descreva o que você quer, veja o resultado, ajuste e repita.
O SD 3.5 Large finalmente lida corretamente com a renderização de texto. As versões anteriores deformavam qualquer texto que você tentasse incluir. Isso é importante para mockups de UI, placas dentro do jogo, telas de título e qualquer situação em que você precise de palavras legíveis nas imagens.
O FLUX.2 (Black Forest Labs, novembro de 2025) é o sucessor maior: um modelo de 32B que realiza geração de texto para imagem e edição de imagens em um único checkpoint, com grande consistência de personagens e estilos usando múltiplas referências, além de renderização confiável de texto em resoluções de até 4 megapixels. O FLUX.2 [dev] de pesos abertos usa uma licença não comercial, mas o FLUX.2 [klein] com destilação de tamanho (janeiro de 2026) distribui sua versão de 4B sob a licença Apache 2.0, gera em menos de um segundo e roda com cerca de 8GB de VRAM. Assim, ainda há uma opção adequada para uso comercial ao lançar arte para jogos. Baixe especificamente o klein 4B: o klein 9B, que é maior, continua sob a licença não comercial do FLUX. Pipelines quantizados permitem executar o [dev] em GPUs de 18-24GB. A próxima geração da Black Forest Labs, FLUX 3, é um modelo conjunto de imagem, vídeo e áudio anunciado em 23 de julho de 2026. Em setembro de 2026, ele está disponível apenas via API: a geração de vídeo com áudio sincronizado entrou em prévia em 4 de agosto, e o FLUX 3 Dev com pesos abertos está “planejado para o fim de 2026”, segundo as notas de versão da BFL. Até que seja lançado, o klein 4B continua sendo o FLUX adequado para uso comercial.
Há mais duas opções abertas que vale a pena conhecer. O Chroma1-HD (8.9B, Apache 2.0) é um derivado totalmente aberto do FLUX.1-schnell, sendo a opção adequada para uso comercial se você quer a qualidade da família FLUX sem a licença do [dev]. O OmniGen2 (Apache 2.0) é um modelo unificado que reúne texto para imagem e edição baseada em instruções. É o caminho mais rápido ao iterar sobre um asset existente (“faça a espada brilhar em azul”), em vez de gerar do zero.
O Qwen-Image (Alibaba, agosto de 2025) é o modelo aberto indicado quando sua arte precisa de texto legível, como placas, UI, pôsteres ou etiquetas de itens. É um modelo de 20B sob a licença Apache 2.0, com renderização de texto líder da categoria e uma robusta variante de edição baseada em instruções. Portanto, é adequado para uso comercial e excepcionalmente bom justamente no aspecto em que a maioria dos modelos de imagem ainda tropeça. A atualização de dezembro de 2025, Qwen-Image-2512, melhorou o realismo humano e o layout de texto, mantendo a licença Apache 2.0. Portanto, use esse checkpoint se for hospedar o modelo por conta própria. O Qwen-Image-2.0 mais recente (fevereiro de 2026) está disponível apenas por API e, em setembro de 2026, o repositório QwenLM ainda lista o Qwen-Image-2512 e o Qwen-Image-Edit-2511 como os checkpoints mais recentes com pesos públicos. Ideogram 4.0 (junho de 2026) é o primeiro lançamento com pesos abertos da Ideogram: um transformer de difusão com 9,3 bilhões de parâmetros criado para trabalhos de design, com excelente renderização de textos multilíngues e controle explícito de layout e cores por meio de prompts JSON estruturados. Um porém antes de adotá-lo: o código de inferência usa a licença Apache 2.0, mas os pesos estão sob uma licença não comercial. Portanto, ele serve para pesquisa e prototipagem, a menos que você adquira a licença comercial.
O ecossistema em torno do Stable Diffusion continua incomparável. ControlNet para composições precisas. Inpainting para correções. Ajuste fino com LoRA para estilos personalizados. O FLUX está diminuindo a diferença, mas, se você precisa de personalização profunda hoje, a maturidade das ferramentas do SD oferece mais recursos.
Eu pensaria assim: para texturas e sprites, qualquer um dos dois funciona. Para arte conceitual com requisitos específicos de estilo, SD 3.5 com LoRAs. Para máxima qualidade em um lançamento comercial, FLUX schnell.
Geração 3D
Se você já passou oito horas modelando um objeto que aparece no seu jogo por três segundos, esta seção é para você. A geração 3D deixou de ser uma “pesquisa interessante” e se tornou uma ferramenta real de produção há algum tempo. Em 2026, os modelos abertos estão realmente bons. Você pode transformar um esboço em uma malha texturizada em menos de um minuto.
Esta página aborda os modelos abertos que você pode hospedar por conta própria. Se você está escolhendo uma ferramenta em vez de um modelo, nosso guia de melhores geradores de modelos 3D com IA compara as opções hospedadas (Meshy, Tripo, Rodin e Hi3D) com as abertas, incluindo preços e direitos de uso comercial de cada uma.
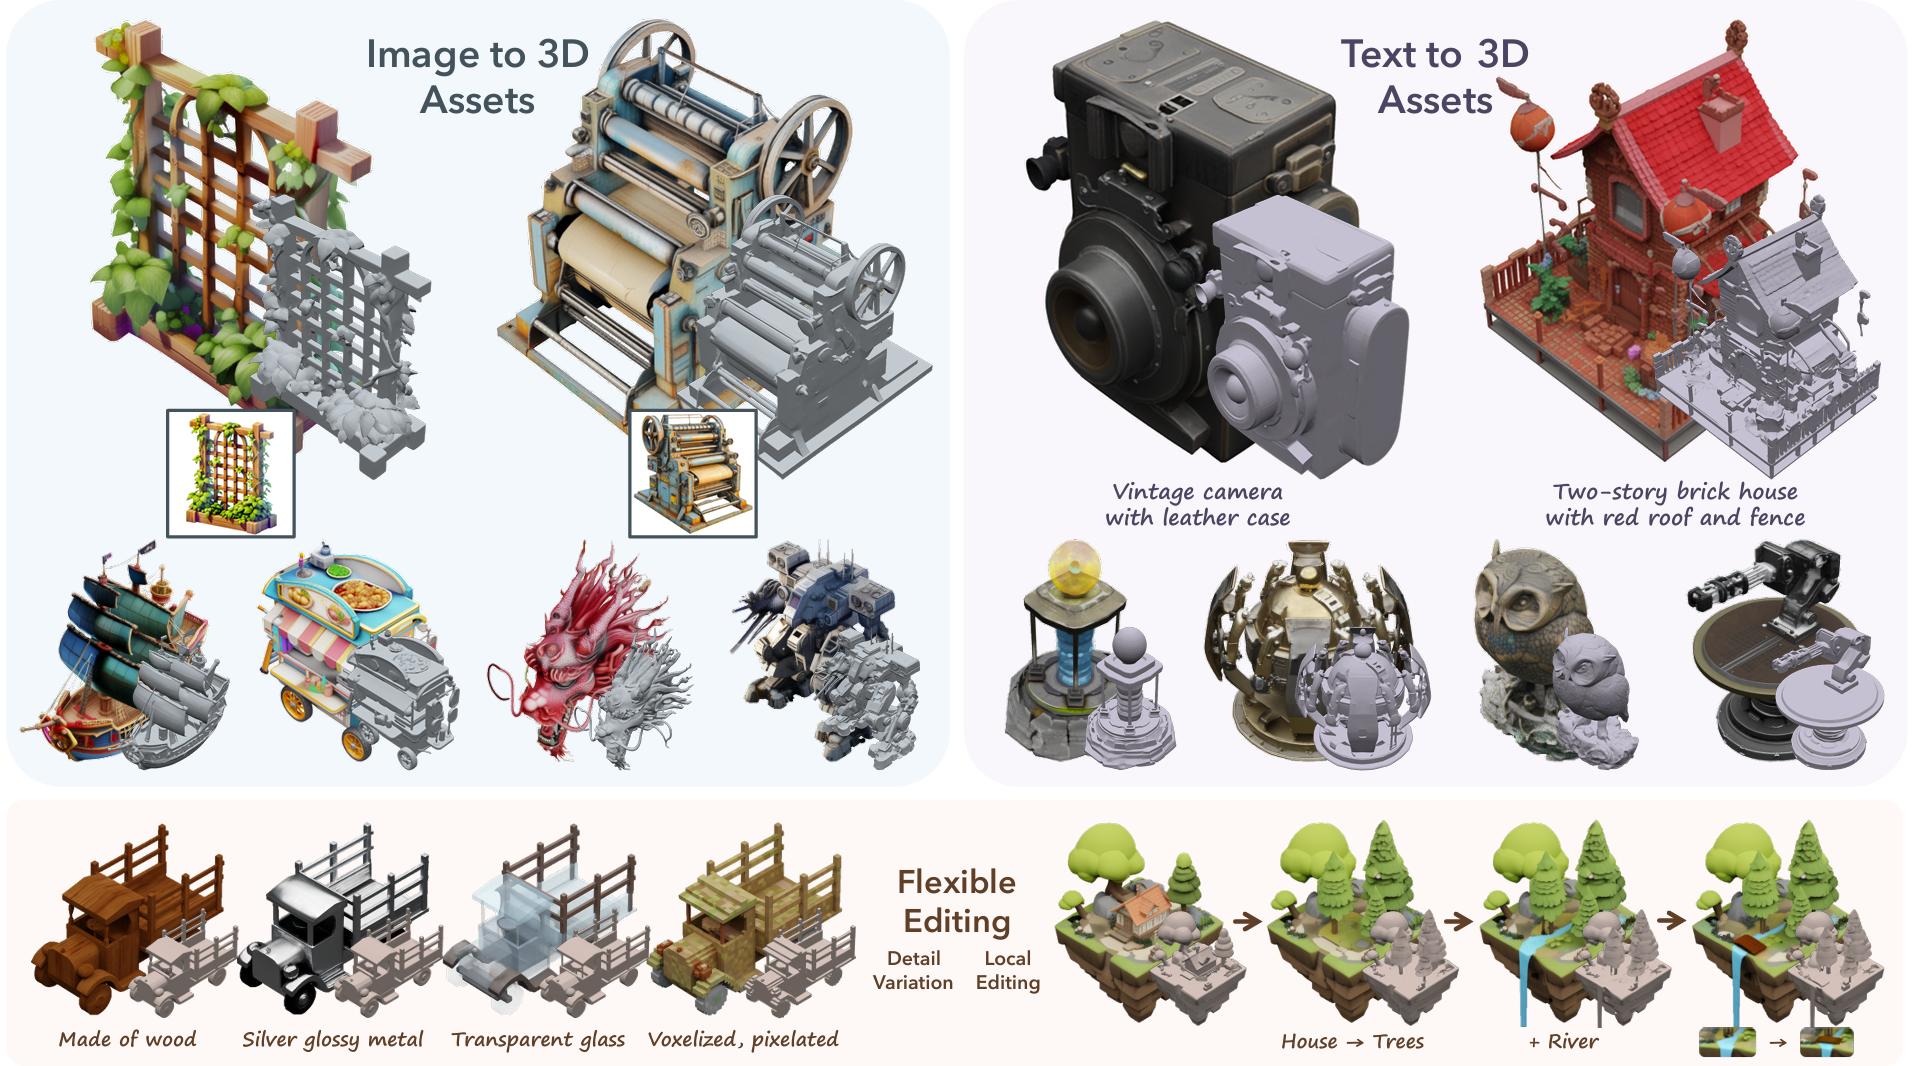 O TRELLIS gera malhas 3D texturizadas com materiais PBR a partir de imagens únicas
| Modelo | Organização | Lançamento | Principal recurso | Saída | Custo/malha |
|---|---|---|---|---|---|
| TRELLIS.2-4B | Microsoft | dez. de 2025 | 4 bilhões de parâmetros, PBR nativo, até 1536³ | Malha texturizada com normais | ~$0.03 |
| Hunyuan3D 2.1 | Tencent | jun. de 2025 | PBR para produção, pesos completos + código de treinamento | Malha texturizada de alta fidelidade | ~$0.05 |
| SAM 3D | Meta | nov. de 2025 | De uma única imagem para 3D (objetos + corpo humano) | Malha a partir de uma foto | ~$0.02 |
| Stable Fast 3D | Stability AI | ago. de 2024 | Uma imagem → malha em ~0,5 s | Malha texturizada rápida | ~$0.001 |
| TripoSG | VAST-AI | mar. de 2025 | Geração de formas com fluxo retificado e 1,5 bilhão de parâmetros | Malha de alta qualidade | ~$0.01 |
| TripoSR | Stability / Tripo | 2024 | Reconstrução rápida a partir de uma única imagem | Malha (sem textura) | ~$0.001 |
| UniRig | Tsinghua / Tripo | 2025 | Rig automático: esqueleto + pesos de skinning | Malha com rig e pronta para animação | ~$0.01 |
Experimente diretamente: demonstração do TRELLIS.2 ↗ · demonstração do Hunyuan3D ↗ · demonstração do InstantMesh ↗
Veja amostras: página do projeto TRELLIS.2 ↗ · galeria do 3D AI Studio ↗
Um fluxo de trabalho que realmente funciona
A abordagem que está funcionando para criadores atualmente combina vários modelos em sequência. Comece com uma imagem, gerada ou fotografada, tanto faz. Passe-a pelo Stable Zero123 ou Wonder3D para obter várias vistas. Envie essas vistas ao InstantMesh ou TripoSR para gerar a malha. Depois, use o TRELLIS.2 ou Hunyuan3D para criar materiais adequados.
O TRELLIS.2, da Microsoft, é o novo líder na criação de assets prontos para produção. Ele lida com a geometria que costuma causar problemas em outros modelos: superfícies finas, buracos e topologias complexas. A versão com 4 bilhões de parâmetros produz malhas com texturas PBR reais, não apenas cores de vértices fingindo ser materiais.
O Stable Fast 3D prioriza a velocidade. Leva cerca de meio segundo para transformar uma imagem em uma malha. A malha precisa de limpeza e texturização, mas, para prototipagem? Para descobrir se uma ideia funciona antes de investir horas nela? É imbatível. O TripoSG é o próximo passo quando você quer uma geometria mais limpa a partir de uma única imagem.
O Hunyuan3D 2.1 é o modelo aberto da Tencent a ser usado: ele inclui os pesos completos e o código de treinamento, com texturização PBR adequada para produção. Preste atenção aos nomes, porque eles confundem muita gente. O Hunyuan3D 2.5, 3.0 e 3.1 existem, mas estão disponíveis apenas por API, sem pesos públicos. Portanto, para hospedagem própria, o gerador-base ainda para na versão 2.1 (uma discussão no GitHub perguntando à Tencent sobre a abertura do código da versão 2.5 continuava sem resposta em setembro de 2026). Se você prefere testá-lo em vez de hospedá-lo, nosso gerador 3D executa o Hunyuan3D no navegador. A Tencent abriu duas extensões úteis criadas sobre a versão 2.1: o Hunyuan3D-Omni adiciona controle por múltiplas condições (nuvem de pontos, voxel, esqueleto e caixa delimitadora), enquanto o Hunyuan3D-Part decompõe uma malha em partes editáveis. A licença também exclui a União Europeia, o Reino Unido e a Coreia do Sul, então confira os termos antes de lançar seu jogo nessas regiões.
O SAM 3D (Meta, novembro de 2025) é a opção mais recente: uma única foto é transformada em uma malha 3D, com modelos separados para objetos e corpos humanos. Combinado ao trabalho de segmentação da Meta, ele permite isolar um objeto em uma imagem e reconstruir apenas esse objeto.
O UniRig (Tsinghua e Tripo, MIT) resolve o problema que todos encontram logo após obter uma malha: a criação do rig. Ele gera automaticamente um esqueleto válido e pesos de skinning para uma malha de entrada. Assim, um personagem gerado pode realmente ser animado em vez de ficar parado como um objeto estático. Combine-o ao trabalho de animação automática do SOMA-X, da NVIDIA, e um personagem totalmente gerado e equipado com rig deixa de ser apenas uma demonstração de pesquisa.
Esta é a expectativa realista para criadores independentes: gere a arte conceitual com o FLUX, passe-a pelo InstantMesh para criar a geometria e, depois, faça a texturização no Blender ou use o TRELLIS para automatizar o PBR. Isso representa de 30 a 60 minutos por asset, em vez de 4 a 8 horas. Não é instantâneo, mas faz uma diferença real.
Áudio e música
A geração de áudio ainda não alcançou o nível das imagens e dos vídeos. Mesmo assim, já há recursos suficientes para mudar a maneira como você trabalha, especialmente na prototipagem e na criação de efeitos sonoros.
Amostra de música gerada por IA. Descreva o clima desejado e obtenha uma música adequada
| Modelo | Organização | Lançamento | O que faz | Licença | Custo/30 s |
|---|---|---|---|---|---|
| ACE-Step 1.5 | StepFun/ACE Studio | jan. de 2026 | Gera rapidamente ~4 min de música, 19 idiomas, clonagem de voz | MIT | ~$0.02 |
| Stable Audio 3.0 | Stability AI | maio de 2026 | Músicas de até ~6 min; modelos abertos Small, Small-SFX + Medium | Stability Community | ~$0.02 |
| YuE | MAP | jan. de 2025 | Músicas completas a partir de letras, vocais + acompanhamento | Apache 2.0 | ~$0.05 |
| MusicGen | Meta | 2023 | Texto para música, controlável | código MIT / pesos CC-BY-NC | ~$0.01 |
| DiffRhythm 2 | ASLP-lab | fev. de 2026 | Geração rápida de músicas completas | Apache 2.0 | ~$0.02 |
| Magenta RealTime | jun. de 2025 | Música em tempo real controlável por prompts | código Apache / pesos CC-BY | ~$0.02 |
Experimente diretamente: demonstração do MusicGen ↗ · playground do AudioCraft ↗
Veja amostras: exemplos do MusicGen ↗ · amostras do AudioGen ↗
O que você realmente pode usar em um lançamento
O MusicGen, da Meta, ainda é uma opção prática para prototipar o áudio de jogos. Descreva o clima desejado, obtenha uma música adequada e execute o modelo tranquilamente em uma GPU de 12 GB. Há uma armadilha na licença: o código do MusicGen é MIT, mas os pesos do modelo são CC-BY-NC (não comercial). Portanto, use-o para prototipagem e mude para um modelo com licença comercial, como o ACE-Step ou Stable Audio, em qualquer projeto que você lançar.
O modelo aberto de efeitos sonoros do Stable Audio (Small-SFX) lida com passos, rangidos de portas, vento ambiente e sons mecânicos, funciona localmente e é distribuído sob a licença comunitária da Stability. Portanto, é a opção aberta de SFX indicada quando você precisa de sons que possa realmente usar comercialmente. Ele é a melhor escolha porque os outros modelos abertos de SFX têm restrições: o AudioGen, da Meta, usa a licença CC-BY-NC, enquanto o TangoFlux está sob a licença comunitária não comercial da Stability. Assim, ambos servem apenas para protótipos, não para um jogo lançado.
O Magenta RealTime (Google) se destaca da melhor maneira possível: é o único modelo com pesos abertos criado para gerar música em tempo real e permitir controle contínuo por prompts. Em vez de renderizar uma faixa finalizada, ele gera música ao vivo, que você pode orientar durante a reprodução. Esse é exatamente o formato de uma trilha sonora adaptativa para jogos, capaz de mudar conforme as ações do jogador. O código usa Apache 2.0 e os pesos usam CC-BY, ambos adequados para uso comercial.
O YuE é realmente empolgante. É o primeiro modelo aberto capaz de gerar músicas completas com vocais. Músicas-tema. Música de fundo com canto de verdade. A qualidade varia, mas está muito à frente de qualquer outra opção que você possa baixar e executar por conta própria.
O ACE-Step é o modelo aberto de música que você precisa conhecer agora, e ele evoluiu rapidamente: a linha 1.5 (janeiro de 2026, com uma variante XL maior de 5 bilhões de parâmetros) substitui o lançamento original de maio de 2025 e agora usa a licença MIT. Ele gera vários minutos de música rapidamente, oferece suporte a 19 idiomas e realiza clonagem de voz, remixes e edição de letras. Para protótipos de jogos, ele preenche grande parte das lacunas deixadas pelo YuE e pelo MusicGen.
O Stable Audio 3.0 (maio de 2026) é a maior atualização para áudio. Ele consegue gerar músicas de até aproximadamente seis minutos, e a Stability lançou pesos abertos para três das quatro variantes: o Small e o modelo dedicado a efeitos sonoros Small-SFX funcionam no próprio dispositivo, enquanto o Medium oferece melhor estrutura musical e a duração completa das faixas. Apenas o modelo Large permaneceu restrito à API. O Small-SFX agora é a opção aberta mais forte especificamente para efeitos sonoros de jogos. Os três modelos abertos usam a Stability AI Community License, que permite usar e vender o que eles geram, com exigência de uma Enterprise License para empresas com receita anual superior a $1 milhão, segundo o anúncio da Stability. Toda a família foi treinada com dados licenciados, então a base jurídica é mais segura do que a dos geradores de música envolvidos em processos judiciais ainda não resolvidos.
Sendo franco: a diferença entre os modelos abertos e os fechados (Suno e Udio) está diminuindo, mas ainda é real para músicas completas com vocais. Essas ferramentas fechadas também enfrentam disputas judiciais não resolvidas relacionadas aos dados de treinamento. Para efeitos sonoros, os modelos abertos — especialmente o modelo de SFX do Stable Audio — são genuinamente competitivos. Para músicas que você pretende lançar, espere fazer muitas iterações ou chamar um músico para a produção final e usar essas ferramentas em todo o restante.
Fala e voz
A geração de voz já ultrapassou há muito tempo o nível de “boa o bastante para jogos”, e isso muda o que pequenas equipes conseguem criar.
Narração de jogo gerada por IA, com fala natural, ritmo adequado e emoção
| Modelo | Organização | Lançamento | Principal recurso | Licença | Custo/min |
|---|---|---|---|---|---|
| Qwen3-TTS | Alibaba | jan. de 2026 | Clonagem de voz com 3 s, design de voz, 10 idiomas | Apache 2.0 | ~$0.002 |
| Chatterbox | Resemble AI | 2025 | Controle de emoção, clonagem com ~5 s, 23 idiomas | MIT | ~$0.003 |
| CSM | Sesame AI | mar. de 2025 | Fluxo de conversa, pausas naturais | Apache 2.0 | ~$0.005 |
| Fish Speech 1.5 | Fish Audio | 2024 | Clonagem zero-shot com 10 a 30 s | código Apache / pesos CC-BY-NC-SA | ~$0.002 |
| OpenVoice V2 | MyShell/MIT | abr. de 2024 | Controle de emoção/sotaque | MIT | ~$0.003 |
| XTTS-v2 | Coqui (comunidade) | 2024 | 17 idiomas, clonagem de voz | CPML (não comercial) | ~$0.005 |
Ouça amostras: vozes do Fish Audio ↗ · demonstração do OpenVoice ↗
Fazendo NPCs soarem como pessoas
O CSM (Conversational Speech Model), da Sesame, foi criado especificamente para diálogos. Ele produz pausas naturais. Mudanças de entonação. O ritmo de uma conversa real. A maioria dos sistemas de TTS soa como alguém lendo um roteiro, e isso fica imediatamente evidente. O CSM soa como alguém conversando. Essa diferença importa mais do que você imagina.
O Qwen3-TTS (Alibaba, janeiro de 2026) é a opção indicada para projetos comerciais. Toda a família usa a licença Apache 2.0, clona uma voz a partir de aproximadamente 3 segundos de áudio de referência, fala 10 idiomas e permite criar vozes por meio de descrições. Assim, você pode especificar a voz de um NPC em texto simples, em vez de procurar gravações de referência. Os modelos de 0,6 e 1,7 bilhão de parâmetros funcionam em hardware modesto. Chatterbox (Resemble AI) é a escolha para vozes expressivas e tem licença MIT, então você pode usá-lo no lançamento. Ele clona uma voz a partir de cerca de 5 segundos de áudio, opera com latência inferior a 200 ms, abrange 23 idiomas e é o primeiro modelo aberto com controle de exagero emocional, permitindo que um NPC realmente soe irritado ou assustado, em vez de inexpressivo. Outras duas opções Apache 2.0 atendem a nichos específicos: o Orpheus (Canopy) aceita tags de emoção embutidas, como <laugh> e <sigh>, que se encaixam perfeitamente em falas curtas de NPCs, e oferece uma variante de 150M para hardware de baixo desempenho; já o Dia (Nari Labs) foi criado para diálogos com vários falantes e inclui sons não verbais, como tosses e risadas, em uma única passagem. O Voxtral TTS da Mistral (março de 2026) é uma opção mais recente de pesos abertos voltada para agentes de voz, segundo a página de notícias da Mistral, mas leia a licença antes de lançar seu jogo.
Fish Speech e OpenVoice cuidam da clonagem de voz. Grave de 10 a 30 segundos da voz de um ator ou atriz e depois gere diálogos ilimitados com ela. Pense no que isso significa: você pode contratar talentos de voz para as falas principais e então ampliar a interpretação para abranger centenas de variações e diálogos ambientes. Uma observação sobre a licença do Fish Speech: o código é aberto, mas os pesos da versão 1.5 usam CC-BY-NC-SA, portanto ele é uma ferramenta de prototipagem. Para jogos lançados, use OpenVoice (MIT) ou Qwen3-TTS (Apache 2.0).
O NVIDIA ACE (não totalmente aberto, mas vale a pena conhecer) agora oferece suporte ao Qwen3-8B para implantação de NPCs no dispositivo. LLM local + TTS local + sincronização labial, tudo executado em GPUs de consumo. Essa é a stack para conversas em tempo real com NPCs que não dependem de chamadas à nuvem.
A abordagem que faz sentido para criadores independentes: contrate atores e atrizes de voz para os personagens principais e para as falas mais importantes. Use Qwen3-TTS ou OpenVoice para ampliar a cobertura de diálogos ambientes, variações e todas as falas incidentais que, de outra forma, ficariam sem voz ou seriam caras demais.
Modelos de mundo e simulação de jogos
É aqui que as coisas ficam realmente estranhas e realmente empolgantes. Esses modelos não geram assets estáticos. Eles geram experiências que parecem jogos.
🎮 Jogue Oasis: Minecraft gerado por IAGeração de mundos em tempo real sem engine de jogo, apenas previsão por IA
| Modelo | Organização | Lançamento | O que faz | Status | Custo/quadro |
|---|---|---|---|---|---|
| DIAMOND | Pesquisa | 2024 | Modelo de mundo por difusão, simulação de Atari | Pesos abertos | ~$0.001 |
| Oasis | Decart/Etched | out. de 2024 | Geração de Minecraft em tempo real | Pesos de 500M abertos | ~$0.002 |
| MineWorld | Microsoft | abr. de 2025 | Minecraft em tempo real, alternativa aberta ao Oasis | MIT | ~$0.002 |
| Hunyuan-GameCraft | Tencent | ago. de 2025 | Vídeo interativo de jogos, controle por teclado/mouse | Tencent Community | ~$0.005 |
| GameGen-X | Pesquisa | 2024 | Geração de vídeos de mundo aberto | Código + conjunto de dados abertos | ~$0.005 |
| NVIDIA Cosmos | NVIDIA | out. de 2025 | Simulação de IA física (Predict2.5) | NVIDIA Open Model License | ~$0.01 |
| Matrix-Game 3.0 | Skywork | mar. de 2026 | Mundos interativos em 720p e tempo real, memória de longo horizonte | Pesos abertos | ~$0.005 |
| Genie 2 | DeepMind | dez. de 2024 | 3D interativo a partir de imagens | Não lançado | N/D |
| Genie 3 | DeepMind | ago. de 2025 | Mundos em 720p e tempo real, eventos controláveis por prompts | Fechado (Project Genie) | N/D |
Veja as pesquisas: página do projeto DIAMOND ↗ · blog do Cosmos ↗
Experimente: demonstração ao vivo do Oasis ↗ · exemplos do Genie 2 ↗
Por que você deveria se importar com isso
O DIAMOND provou algo que muda a maneira como pensamos sobre IA para jogos. Você pode treinar um agente inteiramente dentro de um mundo gerado. Nenhuma engine de jogo real é necessária para o treinamento. A IA joga na imaginação de um modelo de difusão e depois transfere o que aprendeu para o jogo real. As implicações disso são significativas.
O Oasis executa um mundo semelhante ao Minecraft em tempo real. Quadro a quadro. Sem engine de jogo, sem texturas, sem assets prontos. Apenas um transformer prevendo o que vem a seguir. É uma prova de conceito, mas imagine até onde isso pode chegar. A versão de 500 milhões de parâmetros já é aberta.
O GameGen-X lançou o maior conjunto de dados de vídeos de jogos de mundo aberto. Se você deseja treinar seus próprios modelos ou fazer ajuste fino de modelos existentes para gerar conteúdo semelhante a jogos, esse é seu ponto de partida.
O NVIDIA Cosmos foi desenvolvido para robótica e veículos autônomos, mas seus modelos fundamentais de mundo também funcionam para jogos. Eles entendem física, permanência de objetos e relações espaciais. A linha aberta atual é a Cosmos-Predict2.5, lançada em outubro de 2025 sob a NVIDIA Open Model License, que permite uso comercial e trabalhos derivados.
O Hunyuan-GameCraft (Tencent, agosto de 2025) é o modelo de mundo aberto com formato mais diretamente voltado a jogos. Ele foi treinado com mais de um milhão de gravações de mais de 100 jogos AAA e unifica entradas de teclado e mouse em um espaço de controle compartilhado, de modo que gera vídeos interativos de jogos que você realmente controla, em vez de apenas assistir. Ele usa a mesma Tencent Community License do Hunyuan3D, com a mesma exclusão da UE, do Reino Unido e da Coreia do Sul, portanto verifique os termos antes de lançar nessas regiões. O MineWorld (Microsoft, MIT) é a contraparte totalmente permissiva do Oasis: um modelo de mundo de Minecraft em tempo real que você pode baixar e executar sem uma engine de jogo.
O Genie 3 (DeepMind, anunciado em agosto de 2025) é o salto que merece atenção: o primeiro modelo de mundo com interação em tempo real, capaz de gerar mundos navegáveis em 720p a 24 fps que permanecem consistentes por alguns minutos, além de “eventos de mundo controláveis por prompts” que alteram o clima ou adicionam objetos mediante comando. Ele foi disponibilizado ao público como Project Genie em janeiro de 2026 para assinantes do Google AI Ultra nos EUA. Os pesos continuam fechados, mas ele mostra o rumo dos mundos jogáveis e gerados.
O Matrix-Game 3.0 (Skywork, março de 2026) é a resposta aberta ao Genie. Trata-se de um modelo de mundo interativo com memória aumentada que transmite em 720p a 40 fps em tempo real e mantém as cenas consistentes em sequências de um minuto. Uma versão destilada de 5B faz inferência em tempo real, uma versão MoE maior de 2x14B eleva a qualidade, e os pesos estão no Hugging Face sob a licença Apache 2.0. Se você deseja experimentar mundos gerados e jogáveis hoje, em vez de esperar pela DeepMind, este é o modelo que pode realmente baixar.
Para o desenvolvimento prático de jogos hoje, essas ainda são ferramentas de pesquisa. Mas, se você trabalha com conteúdo orientado por IA, geração procedural ou simplesmente pensa sobre os rumos de tudo isso, esta é a fronteira.
Grandes modelos de linguagem
LLMs viabilizam diálogos, geração de missões e lógica de jogo. E as opções abertas agora realmente competem com o GPT-4. Isso não era verdade dois anos atrás.
| Modelo | Organização | Lançamento | Tamanho | Melhor para | Licença | Custo/1 mil tokens |
|---|---|---|---|---|---|---|
| DeepSeek-V3 | DeepSeek | dez. de 2024 | MoE de 671B (37B ativos) | Raciocínio, uso geral | Permissiva | ~$0.02 |
| DeepSeek-R1 | DeepSeek | jan. de 2025 | Baseado no V3 | Cadeia de raciocínio | Permissiva | ~$0.03 |
| DeepSeek-V3.2 | DeepSeek | dez. de 2025 | Atenção esparsa (DSA) | Raciocínio + uso de ferramentas | MIT | ~$0.02 |
| DeepSeek-V4 | DeepSeek | abr. de 2026 | MoE de 1.6T (49B ativos) | Raciocínio de fronteira, contexto de 1M | MIT | ~$0.02 |
| GLM-5 | Zhipu / Z.ai | fev. de 2026 | MoE de 744B (40B ativos) | Programação, agentes, uso de ferramentas | MIT | ~$0.02 |
| GLM-5.2 | Zhipu / Z.ai | jun. de 2026 | MoE de 753B | Programação, agentes, contexto de 1M | MIT | ~$0.02 |
| GPT-OSS | OpenAI | ago. de 2025 | MoE de 120B / 20B | Raciocínio, uso de ferramentas, no dispositivo | Apache 2.0 | ~$0.01 |
| Kimi K2 | Moonshot | 2025 | MoE de 1T (32B ativos) | Agentes, programação | MIT modificada | ~$0.02 |
| Kimi K3 | Moonshot | jul. de 2026 | MoE de 2.8T (16 de 896 especialistas ativos) | Agentes de fronteira, programação, contexto de 1M, visão | Kimi K3 License | ~$0.03 |
| Hy3 | Tencent | jul. de 2026 | MoE de 295B (21B ativos) | Raciocínio, programação por agentes, contexto de 256K | Apache 2.0 | ~$0.02 |
| Gemma 3 | 2025 | 1B-27B | No dispositivo, 140 idiomas, visão | Gemma | ~$0.01 | |
| Gemma 4 | abr. de 2026 | E2B a 31B (MoE 26B-A4B) | No dispositivo, mais de 140 idiomas, visão + áudio, 256K | Apache 2.0 | ~$0.01 | |
| Qwen3 | Alibaba | 2025 | MoE de 235B (22B ativos) | Multilíngue, código | Apache 2.0 | ~$0.01 |
| Qwen3.5 / 3.6 / 3.8 | Alibaba | fev.-ago. de 2026 | 0.8B até 2.4T-A95B | Multimodal, agentes, modelo aberto principal da classe Qwen-Max | Apache 2.0 | ~$0.02 |
| Mistral Small 4 | Mistral | mar. de 2026 | MoE de 119B (6B ativos) | Raciocínio + visão + programação por agentes, 256K | Apache 2.0 | ~$0.01 |
| Qwen3-Coder | Alibaba | 2025 | MoE de 480B (35B ativos) | Programação por agentes, contexto de 256K | Apache 2.0 | ~$0.02 |
| Llama 4 | Meta | 2025 | Vários | Agentes, contexto de até 10M | Llama Community | ~$0.01 |
| Muse Glimmer 30B | Meta | ago. de 2026 | ~30B denso | Agentes no dispositivo, visão, contexto de mais de 128K | Apache 2.0 | ~$0.01 |
| Qwen3-VL | Alibaba | 2025 | 2B-235B | Visão + linguagem | Apache 2.0 | ~$0.02 |
| InternVL3 | Shanghai AI Lab | 2025 | 1B-78B | Visão, OCR, compreensão espacial de interfaces | MIT | ~$0.02 |
Comece por aqui: Qwen3-8B no HuggingFace ↗ · DeepSeek-V3 no HuggingFace ↗ · GLM-5 no HuggingFace ↗
Para criar jogos
O Qwen3 é a escolha prática para a maioria dos usos em jogos. Licença Apache 2.0, o que significa que você mantém o controle sobre sua integração. Tem forte suporte multilíngue, algo importante se você está pensando em localização. É bom em seguir instruções estruturadas. As variantes 7B e 14B rodam localmente em GPUs de consumo.
Qwen3.5, 3.6 e 3.8 mantiveram a linha Apache 2.0 ao longo de 2026. O Qwen3.5 (16 de fevereiro de 2026) estreou com um MoE 397B-A17B e depois ganhou variantes densas de 27B, 9B e 4B. O Qwen3.6 (abril) ajustou a mesma família para oferecer mais estabilidade, e seu 35B-A3B é o ponto ideal para execução local: 35B de conhecimento com apenas 3B ativos por token, portanto roda muito rápido em uma única placa de 24 GB. O Qwen3.8 (12 a 14 de agosto de 2026) é o modelo grande, descrito no repositório do Qwen3.8 como o primeiro modelo da classe Qwen-Max lançado abertamente, com um modelo principal 2.4T-A95B e um modelo denso de 27B, ambos sob Apache 2.0 e com contexto de 262K.
O DeepSeek-V3 iguala ou supera o GPT-4 na maioria dos benchmarks. A arquitetura é engenhosa: apenas 37B parâmetros são ativados por token, apesar do total de 671B. Você precisa de hardware robusto, com várias GPUs, mas a qualidade está no nível da fronteira sem depender de uma API.
O DeepSeek-V3.2 (dezembro de 2025) reúne raciocínio e uso de ferramentas em um único modelo e introduz o DeepSeek Sparse Attention (DSA) para inferência mais barata em contextos longos, com uma variante Speciale de alta capacidade computacional voltada aos principais benchmarks de raciocínio. Para lógica de jogos e diálogos, ele é um substituto direto mais poderoso e com maior capacidade de atuação como agente do que o V3.
O DeepSeek-V4 (abril de 2026) voltou a elevar a fronteira dos modelos abertos. O V4-Pro é um MoE de 1.6T parâmetros com apenas 49B ativos por token, uma janela de contexto de 1 milhão de tokens e modos de raciocínio selecionáveis, tudo sob a licença MIT. A variante V4-Flash (284B no total, 13B ativos) mantém o contexto de 1M em um pacote que não exige um cluster completo de GPUs. Se você está escolhendo hoje um modelo aberto para lógica complexa de missões ou contextos extensos de estado de jogo, esse é o limite superior.
O GLM-5 (Zhipu AI, fevereiro de 2026) é o modelo aberto a ser superado em programação e trabalho com agentes, e a atualização GLM-5.2 elevou suas pontuações em uso de ferramentas e planejamento de longo horizonte para perto da fronteira dos modelos fechados. É um MoE de 744B parâmetros, com 40B ativos por token, contexto de 200 mil tokens e licença MIT. O próprio GLM-5.2 foi lançado em 17 de junho de 2026 como um MoE de 753B com contexto de 1M tokens, ainda sob MIT e sem limitações regionais; depois veio o GLM-5.3, uma atualização de pós-treinamento sobre a mesma base, com pesos no Hugging Face sob a licença GLM-5.3 da própria Z.ai em vez da MIT, portanto verifique esse texto se for hospedar por conta própria a versão mais recente. A Z.ai é a primeira empresa de modelos fundamentais com ações negociadas em bolsa e oferece preços agressivos para sua API hospedada, cerca de $1,40 por milhão de tokens de entrada, mas os pesos estão no Hugging Face caso você prefira hospedar por conta própria. Se seu jogo depende de um LLM para criar scripts de missões, agentes que chamam ferramentas ou sistemas orientados por código, o GLM-5 é uma forte alternativa à OpenAI que você controla totalmente. GPT-OSS (OpenAI, agosto de 2025) é o primeiro lançamento de pesos abertos da OpenAI e se encaixa perfeitamente no tema deste guia. O modelo gpt-oss-120b raciocina e chama ferramentas em um nível próximo ao o4-mini usando uma única GPU de 80 GB, enquanto o gpt-oss-20b roda em uma placa de consumo com 16 GB, ambos sob a licença Apache 2.0. Se você quer um modelo de um laboratório ocidental que possa hospedar por conta própria para lógica de NPCs ou agentes que usam ferramentas, esta é a escolha.
Kimi K2 (Moonshot) é o outro peso-pesado agêntico aberto ao lado do GLM-5 e do DeepSeek. É um MoE de 1 trilhão de parâmetros, com 32B ativos, altamente ajustado para programação e uso de ferramentas. Sua licença MIT Modificada só acrescenta restrições acima de 100 milhões de usuários mensais; portanto, para estúdios independentes, ela é efetivamente MIT. Use-o quando um agente precisar planejar ao longo de muitas etapas.
Kimi K3 (Moonshot, julho de 2026) é o maior modelo de pesos abertos já anunciado e chega mais perto da fronteira dos modelos fechados do que qualquer modelo aberto anterior. É um MoE de 2,8 trilhões de parâmetros com apenas cerca de 50B ativos por token (16 de 896 especialistas), contexto de 1 milhão de tokens e visão nativa, construído sobre dois novos mecanismos de atenção chamados Kimi Delta Attention e Attention Residuals. Nos benchmarks de julho da Moonshot, ele superou as versões então disponíveis do Claude Opus e do GPT-5.5 em tarefas de programação e agênticas, ficando atrás apenas dos melhores modelos proprietários — metas que voltaram a avançar em setembro com o Claude Fable 5.1 e o GPT-6 Astra. Os pesos chegaram ao Hugging Face em 27 de julho de 2026, no formato MXFP4, sob a Licença Kimi K3 em vez da MIT. Ela é permissiva para a maioria dos usos, mas uma empresa de modelo como serviço com receita superior a $20 milhões em qualquer período de 12 meses precisa de um acordo separado com a Moonshot, e produtos com mais de 100 milhões de usuários mensais ou $20 milhões de receita mensal precisam exibir "Kimi K3" na interface. Hospedar por conta própria um modelo de 2,8T ainda exige um cluster de GPUs com vários nós, então a maioria das equipes o acessará pela API, a $3 por milhão de tokens de entrada e $15 por milhão de tokens de saída. Para agentes que você realmente pode executar por conta própria, o K2 continua sendo a opção prática da Moonshot, mas o K3 redefine o que "aberto" pode significar no nível mais avançado.
Gemma 3 (Google) é a melhor opção quando você precisa rodar no hardware do jogador ou oferecer localização ampla. Ele está disponível nos tamanhos 1B, 4B, 12B e 27B, portanto escala a partir de uma placa com 8 GB, oferece suporte a 140 idiomas, faz chamadas de funções e, nas variantes de 4B ou mais, também interpreta imagens, funcionando ainda como um pequeno modelo de visão. A licença do Gemma permite uso comercial.
Gemma 4 (Google, 2 de abril de 2026) o substitui em novos projetos e resolve de vez a questão da licença: toda a família usa Apache 2.0, conforme o cartão do modelo. Ele é oferecido como E2B e E4B para celulares e notebooks, além de versões 12B, 26B-A4B MoE com menos de 4B ativos e uma versão densa 31B, com contexto de 128K nos modelos pequenos e 256K nos demais, entrada nativa de imagens em todos os tamanhos, áudio nos menores e suporte a mais de 140 idiomas. Para um cérebro de NPC executado no dispositivo que também precise analisar uma captura de tela, o 26B-A4B é a escolha.
A linha Llama da Meta está efetivamente pausada. O Llama 4 (abril de 2025) continua sendo o último Llama e, em abril de 2026, o Meta Superintelligence Labs lançou seu sucessor, o Muse Spark, como modelo fechado. A Meta voltou parcialmente atrás em agosto de 2026 com o Muse Glimmer 30B, um modelo multimodal denso de aproximadamente 30B sob Apache 2.0, com contexto de mais de 128K e compilações de 4 bits que cabem em uma placa de 24 GB. É um ótimo modelo de agente local, mas, se você estava esperando pelo Llama 5, pare de esperar e escolha entre Qwen, Gemma 4 ou Glimmer.
Hy3 (Tencent, julho de 2026) é a outra grande novidade sob Apache 2.0. É um MoE de 295B com 21B ativos e contexto de 256K, conforme seu cartão do modelo. A versão de julho removeu as exclusões regionais presentes na prévia de abril; portanto, ao contrário das licenças do Hunyuan3D e do GameCraft da Tencent, ele pode ser usado na União Europeia, no Reino Unido e na Coreia do Sul.
Qwen3-Coder (Alibaba) é o modelo aberto dedicado a programação, substituindo a antiga linha DeepSeek-Coder na maioria dos usos. É um MoE de 480B com 35B ativos, contexto nativo de 256K (extensível a 1 milhão), licença Apache 2.0 e desempenho na classe do Claude Sonnet em benchmarks de programação agêntica. Se o seu jogo gera ou executa código, este é o teto entre os modelos abertos. A família europeia Mistral é uma alternativa sólida para hospedagem própria: Devstral para programação e Mistral Small 4 (16 de março de 2026), um MoE de 119B com 6B ativos que reúne raciocínio, visão e programação agêntica em um único modelo Apache 2.0 com contexto de 256K.
Qwen3-VL acrescenta compreensão visual, com versões densas e MoE que vão de 2B a 235B sob Apache 2.0. É útil para jogos que precisam analisar capturas de tela, compreender conteúdo desenhado pelos jogadores ou processar a entrada de uma câmera. A variante 8B roda em uma única GPU. InternVL3 (Shanghai AI Lab, MIT) é a outra opção aberta forte de visão e linguagem, especialmente boa em OCR e localização de elementos de interface, o que importa quando suas ferramentas precisam ler interfaces de jogos; o Pixtral 12B da Mistral (Apache 2.0) é uma opção mais leve e segura para uso comercial.
Para NPCs executados no dispositivo — personagens que respondem em tempo real sem chamadas à nuvem —, o Qwen3-8B por meio do NVIDIA ACE é o caminho mais prático no momento. Ele roda junto com o jogo no hardware do jogador.
Modelos utilitários
Eles não geram conteúdo diretamente, mas fazem seus pipelines funcionarem.
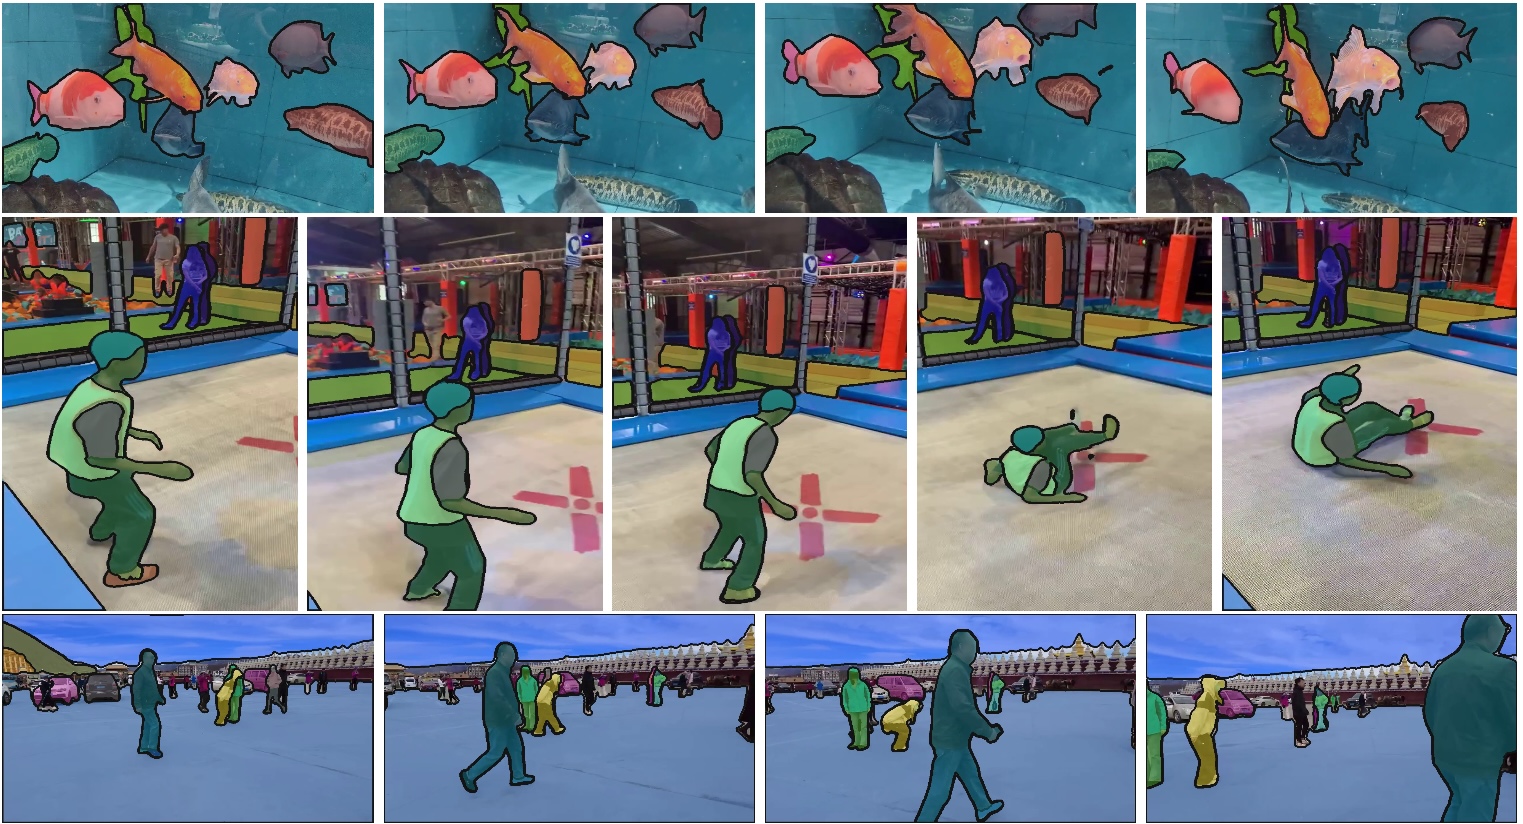 O SAM 2 segmenta qualquer objeto em imagens e vídeos. Clique uma vez e obtenha uma máscara perfeita
| Modelo | Organização | Lançamento | O que faz |
|---|---|---|---|
| SAM 2 | Meta | ago. de 2024 | Segmenta qualquer elemento em imagens e vídeos |
| Depth Pro | Apple | out. de 2024 | Gera profundidade métrica a partir de uma única imagem |
| gsplat | Nerfstudio | 2024+ | Gaussian splatting acelerado por CUDA |
SAM 2 segmenta objetos em vídeos em tempo real. Clique em algo e obtenha uma máscara perfeita. É útil para rotoscopia, composição ou extração de objetos de filmagens para usá-los como assets do jogo. Experimente o SAM 2 ↗
O Depth Pro da Apple produz mapas de profundidade métrica a partir de imagens únicas em menos de um segundo. Isso abre muitas possibilidades: converter arte 2D em 2,5D com efeitos de paralaxe, gerar dados de profundidade para reconstrução 3D e criar mapas de normais a partir de imagens planas. Depth Pro no Hugging Face ↗
gsplat é uma implementação rápida de Gaussian splatting. Se você captura ambientes reais para jogos, seja por fotogrametria ou escaneamento de cenários, esta é a biblioteca que torna isso viável.
O que eu realmente usaria
Se você está começando um projeto de jogo hoje, esta é uma combinação de ferramentas que faz sentido:
Texturas e sprites: FLUX.1 [schnell], Apache 2.0, iteração rápida e qualidade pronta para publicação
Arte conceitual: SD 3.5 Large com LoRAs para controlar o estilo
Assets 3D: Hunyuan3D 2.1 ou TRELLIS.2 para malhas texturizadas, SAM 3D quando o ponto de partida for uma foto e, depois, Blender para os ajustes finais
Rigging automático: UniRig ou NVIDIA SOMA-X para criar esqueleto e skinning nas malhas geradas (ambos abertos), em vez de depender do Mixamo
Efeitos sonoros: o modelo aberto Small-SFX do Stable Audio, que roda localmente e possui licença comercial
Música: ACE-Step para protótipos e, depois, um compositor para a produção final
Voz: Qwen3-TTS para clonagem e diálogos ambientes (Apache 2.0), Chatterbox (MIT) quando uma fala precisar de emoção real e dubladores para as falas importantes
Diálogos de NPCs: Qwen3.6-35B-A3B, Gemma 4 26B-A4B ou Muse Glimmer 30B localmente, ou um LLM em nuvem que possa ser hospedado por conta própria (GLM-5.2, DeepSeek-V4 ou Kimi K3) para raciocínio complexo e uso de ferramentas
Vídeo (cinemáticas): Mochi 1 ou Wan 2.2 5B localmente; LTX-2.5 ou HunyuanVideo-1.5 na nuvem quando você precisar de qualidade final
A questão em tudo isso é a seguinte: o erro comum é tentar usar IA para tudo. Estes são recursos, não substitutos. Eles reduzem o trabalho nas partes tediosas, como iteração, variações e assets provisórios, para que você possa dedicar seu tempo às decisões criativas que realmente importam. Àquilo que torna seu jogo único.
Uma avaliação realista do hardware
Sejamos honestos sobre o que você realmente precisa para rodar tudo isso:
8 GB de VRAM (RTX 3060, 4060): SD 1.5/SDXL, Wan 2.1 pequeno, AudioGen, Fish Speech e LLMs pequenos (7B quantizados). É o território dos notebooks gamers e já basta para começar.
12 GB de VRAM (RTX 3080, 4070): SD 3.5, FLUX schnell, Mochi 1, MusicGen, TripoSR e Qwen 14B quantizado. É aqui que as coisas ficam confortáveis. A maioria dos modelos úteis roda nessa configuração.
24 GB de VRAM (RTX 3090, 4090): a maioria dos modelos em precisão completa, InstantMesh, LLMs maiores e a categoria de agentes locais de 2026: Qwen3.6-35B-A3B, Gemma 4 31B em 4 bits e Muse Glimmer 30B em 4 bits. Se você leva esse fluxo de trabalho a sério, este é o ponto ideal.
48–80 GB de VRAM (A100, H100): HunyuanVideo, LTX-2, DeepSeek-V3 e geração em escala de produção. Hardware empresarial. Você não vai comprá-lo, mas alugá-lo.
Instâncias em nuvem no RunPod, Lambda Labs ou Modal custam US$ 2–4 por hora para GPUs A100. Para uso ocasional, isso sai mais barato do que comprar o hardware. Inicie uma instância quando precisar da qualidade final e encerre-a quando terminar.
Sobre as estimativas de custo deste guia: os custos por geração pressupõem inferência hospedada por conta própria em GPUs na nuvem por cerca de US$ 2–3/hora (A100) ou US$ 0,40/hora (RTX 4090). Os custos reais variam conforme o hardware, a otimização e o tamanho dos lotes. Estes são valores aproximados para planejamento, então sua experiência pode variar.
Novidades de 2026
Lançamentos recentes: LTX-2 e LTX-2.3 trouxeram áudio e vídeo sincronizados e abertos com 4K nativo. O TRELLIS.2 da Microsoft (dezembro de 2025) tornou-se o líder aberto em conversão de imagem para 3D, enquanto o SAM 3D da Meta (novembro de 2025) tornou prática a reconstrução 3D a partir de uma única foto. O FLUX.2 substituiu o FLUX.1 na geração de imagens, e o SOMA-X da NVIDIA trouxe rigging automático e redirecionamento de animações em código aberto. O ritmo continuou acelerado no primeiro semestre de 2026: o Qwen3-TTS (janeiro) deu à clonagem de voz uma opção sólida sob Apache 2.0; o GLM-5 da Zhipu (fevereiro) lançou um modelo aberto de 744B para programação e tarefas agênticas sob MIT; o Matrix-Game 3.0 da Skywork (março) disponibilizou um modelo de mundo interativo em tempo real com pesos abertos; o DeepSeek-V4 (abril) levou os LLMs abertos a um contexto de 1 milhão de tokens sob MIT; o Stable Audio 3.0 (maio) lançou três modelos de áudio abertos treinados com dados licenciados; e a Ideogram lançou seu primeiro modelo de imagem com pesos abertos (junho). Em julho, a Moonshot anunciou o Kimi K3, um modelo de pesos abertos com 2,8T de parâmetros, cujos pesos foram lançados em 27 de julho sob a Licença Kimi K3. No mesmo mês, a Tencent migrou o Hy3 de 295B para Apache 2.0, poucas semanas depois de a Z.ai lançar o GLM-5.2 sob MIT (17 de junho). Agosto também foi movimentado no ecossistema aberto: a Alibaba lançou o Qwen3.8 (um modelo principal de 2.4T-A95B e um modelo denso de 27B, sob Apache 2.0), a Meta disponibilizou o Muse Glimmer 30B sob Apache 2.0, a MiniMax abriu os pesos do modelo de vídeo H3 de 33B e a Lightricks lançou o LTX-2.5. No início do ano, o Gemma 4 do Google (abril, Apache 2.0) e o Mistral Small 4 (março, Apache 2.0) redefiniram a categoria de modelos executados no dispositivo.
A tendência a acompanhar: os principais laboratórios estão mantendo cada vez mais seus modelos mais recentes restritos a APIs, mesmo quando as versões anteriores eram abertas. O Wan tornou-se fechado na versão 2.5 e permaneceu assim até a 3.0 (agosto de 2026), assim como o Qwen-Image na versão 2.0 e o Hunyuan3D na 2.5. O Muse Spark, sucessor do Llama da Meta, foi lançado como modelo fechado em abril de 2026, antes de o menor Muse Glimmer voltar a ser aberto em agosto. A Black Forest Labs está lançando o FLUX 3 primeiro por sua API, com um FLUX 3 Dev aberto prometido para mais adiante em 2026, e a Skywork anunciou o SkyReels V4 em fevereiro sem publicar os pesos. O ecossistema aberto continua vibrante e avançando rapidamente, mas já não é seguro presumir que "a versão mais recente é aberta". Portanto, verifique a disponibilidade dos pesos antes de criar um pipeline em torno de um modelo.
A trajetória é clara: todo recurso presente em modelos fechados aparece em modelos abertos de 6 a 12 meses depois. A questão não é se os modelos abertos serão bons o bastante. Eles já são para a maioria dos usos. A questão é em quanto tempo eles se tornarão o padrão.
E isto é o que isso significa para criadores: as ferramentas que antes exigiam orçamentos empresariais ou assinaturas mensais estão se tornando algo que você pode simplesmente... executar. No seu próprio hardware. Sem precisar da permissão de ninguém.
Essa é a mudança. É para isso que estamos construindo.
Perguntas frequentes
Qual é o melhor modelo de IA de código aberto para gerar assets de jogos?
Depende do tipo de asset. Para modelos 3D, o Hunyuan3D é a opção aberta mais forte em 2026. Para arte 2D e texturas, o FLUX lidera em qualidade. Para efeitos sonoros e música, os modelos abertos de áudio avançaram rapidamente. Não existe um único modelo "melhor", pois jogos precisam de muitos tipos de assets; por isso, a maioria dos criadores encadeia alguns modelos em vez de depender de apenas um.
Os modelos de IA de código aberto são bons o bastante para substituir APIs fechadas?
Para a maior parte do trabalho com assets de jogos em 2026, sim. Os modelos abertos agora igualam as APIs fechadas na geração de imagens, 3D e áudio, e você pode executá-los em seu próprio hardware sem tarifas por chamada ou mudanças inesperadas de preço. Os modelos fechados ainda lideram em algumas tarefas de fronteira, como vídeos longos, mas a diferença costuma desaparecer em um intervalo de 6 a 12 meses.
Posso executar esses modelos de IA generativa na minha própria GPU?
Muitos deles, sim. Modelos de imagem e áudio rodam com folga em uma única GPU de consumo, como a RTX 4090. Modelos maiores de vídeo e 3D precisam de mais VRAM e, muitas vezes, de uma GPU na nuvem da classe A100. A seção de hardware acima lista o que cada modelo exige, para que você possa se planejar antes de se comprometer.
Qual é o melhor modelo de fronteira de código aberto em 2026?
Em setembro de 2026, a fronteira aberta é uma disputa entre quatro modelos, e a resposta depende do que você consegue executar. O Kimi K3 (MoE de 2,8T) é o maior e alcança resultados mais próximos dos líderes fechados, mas sua Licença Kimi K3 impõe condições a grandes empresas que oferecem modelos como serviço. O DeepSeek-V4-Pro (1,6T, 49B ativos) e o Qwen3.8-2.4T-A95B têm as licenças mais simples nessa escala, MIT e Apache 2.0, respectivamente. O GLM-5.2 (753B, MIT) é especializado em programação e agentes. Nenhum deles cabe em uma única GPU, portanto, para qualquer coisa que você hospede por conta própria, o verdadeiro "melhor" está um nível abaixo: Qwen3.6-35B-A3B, Gemma 4 31B ou Muse Glimmer 30B.
Quais são os melhores modelos de fronteira para geração de imagens, abertos e fechados?
Abertos: FLUX.2 [klein] 4B (Apache 2.0, menos de um segundo) para arte de jogos segura para uso comercial, Qwen-Image-2512 (Apache 2.0) quando você precisa de texto legível e FLUX.2 [dev] ou Chroma1-HD para obter a máxima qualidade, se a licença for adequada. Fechados: FLUX.2 [pro] e o Qwen-Image-2.0, disponível apenas por API, além de lançamentos de 2026 como o Kling IMAGE 3.0 (até 10 imagens de referência, segundo o guia do Kling) e o Grok Imagine Image 2.0 da xAI. Por enquanto, o modelo de imagens do FLUX 3 está disponível apenas pela API da BFL, com uma versão Dev aberta prometida para o fim de 2026. Para desenvolvimento de jogos, a categoria aberta já é boa o suficiente, então os modelos fechados oferecem principalmente conveniência.
Quais modelos de vídeo com pesos abertos permitem implantação comercial completa e sob qual licença?
Se você precisa de um modelo de vídeo aberto que possa ser implantado comercialmente em escala empresarial sem limite de receita, as opções seguras são Wan 2.2 (Apache 2.0, incluindo as variantes MoE de 5B e 14B), Mochi 1 (Apache 2.0), Step-Video-T2V (MIT) e CogVideoX 2B (Apache 2.0). O LTX-2 e o LTX-2.5 podem ser usados comercialmente de forma gratuita por empresas com receita anual inferior a US$ 10 milhões e exigem um contrato pago acima desse valor, que é a opção de "comprar acesso" realmente oferecida pela Lightricks. O MiniMax H3 é aberto sob a Licença Comunitária MiniMax H3, mas solicita que usuários dos EUA, da UE, do Reino Unido e da Coreia do Sul façam uma solicitação prévia; já o HunyuanVideo usa a licença comunitária da Tencent, com exceções regionais. Portanto, leia ambas antes de se comprometer. O Wan 2.5 ao 3.0, o Veo, o Kling e o Seedance não têm pesos públicos. Nosso guia de modelos de vídeo com imagens de referência compara as opções hospedadas.
Qual IA generativa devo usar para criar recursos e ambientes de jogos em 2026?
Encadeie alguns modelos especializados em vez de procurar um único modelo para tudo. Para objetos e personagens, passe um conceito gerado pelo FLUX.2 klein ou Qwen-Image pelo Hunyuan3D 2.1 ou TRELLIS.2 e faça o rigging com o UniRig. Para ambientes, gere um skybox ou HDRI (nosso gerador de skybox faz isso no navegador), crie o terreno proceduralmente ou com uma etapa de difusão, como mostrado em nosso guia de geração de terrenos, e aplique texturas usando um modelo de imagens junto com um extrator PBR, conforme explicado em nosso guia de geradores de texturas com IA. O áudio pode ser gerado pelo Stable Audio 3.0 Small-SFX e pelo ACE-Step, e as vozes pelo Qwen3-TTS ou Chatterbox. Todos os modelos desse fluxo são abertos e podem ser usados comercialmente em setembro de 2026.
Qual é o melhor LLM para executar localmente em 2026?
Escolha primeiro pela quantidade de VRAM. Com 8 GB, use o Qwen3.5-4B ou o Gemma 4 E4B. Com 16 GB, use o gpt-oss-20b (Apache 2.0, criado para 16 GB) ou o Gemma 4 12B. Com 24 GB, o Qwen3.6-35B-A3B é a opção versátil que a maioria das pessoas deveria usar, com o Muse Glimmer 30B em 4 bits para tarefas com agentes e visão, e o Gemma 4 31B quantizado quando você quiser o modelo denso mais potente. Acima disso, o DeepSeek-V4-Flash (284B, 13B ativos) é a menor opção para obter uma janela de contexto de 1 milhão de tokens em uma estação de trabalho. Todos eles usam Apache 2.0 ou MIT, e o Ollama ou o LM Studio executa cada um deles com um único comando.
É legal usar recursos gerados por IA em um jogo comercial?
Em geral, sim, no caso de modelos de código aberto executados por você, mas isso depende da licença do modelo e das suas premissas sobre os dados de treinamento. Sempre confira a licença específica do modelo e informe o uso de conteúdo gerado por IA quando a plataforma exigir. Consulte nossa política de conteúdo gerado por IA para saber como lidamos com isso.
Leitura adicional
- Controvérsia da IA, confiança e economia pós-IA: nossa posição sobre IA em jogos
- Política de conteúdo gerado por IA: como lidamos com a divulgação do uso de IA
- Melhores modelos de vídeo com IA compatíveis com imagens de referência: comparação dos modelos de vídeo hospedados
- Melhores geradores de modelos 3D com IA: comparação entre Meshy, Tripo e Rodin hospedados e os modelos abertos
- Pilha tecnológica para jogos web em 2026: WebGL, WebGPU e Wasm para jogos
- Tecnologia para mundos 3D abertos no navegador: uso de recursos 3D gerados por IA em mundos no navegador
- Geração de paisagens para mundos abertos no navegador: síntese de terrenos baseada em difusão
- Onde encontrar recursos gratuitos para jogos: fontes tradicionais de recursos junto com a geração por IA
- Ferramentas de programação com IA baseada em agentes: IA para escrever código de jogos, não apenas gerar recursos
Modelos generativos são mais divertidos quando o resultado é jogável.