Mejores modelos generativos de IA de código abierto para juegos (2026)
Última actualización: septiembre de 2026.
Esto es lo que ocurre con la IA generativa. Durante años, los mejores modelos estuvieron detrás de claves de API y precios impredecibles. Organizabas tu flujo de trabajo en torno a una herramienta, te acostumbrabas a ella y, de pronto, recibías un correo informándote de que los precios habían cambiado. O, peor aún, la empresa había cambiado por completo de rumbo.
Eso cambió a finales de 2024. Tencent, Alibaba y DeepSeek empezaron a publicar modelos que realmente puedes descargar. Modelos capaces de competir con las alternativas cerradas. Y, de repente, los creadores tienen opciones que no dependen del modelo de negocio de otros.
¿Y si pudieras generar vídeos, recursos 3D, música y voces mediante modelos bajo tu control? Ese es el punto en el que estamos. Esta guía repasa qué es real, qué funciona y qué puedes empezar a utilizar hoy mismo.
Generación de vídeo
Durante años, generar vídeo significaba recurrir a Runway o Pika: plataformas cerradas, cuotas de suscripción y límites sobre lo que podías hacer con el resultado. ¿Ahora? Puedes ejecutar modelos comparables en tu propio hardware.
Generación de texto a vídeo con HunyuanVideo, salida a 720p del principal modelo de vídeo de código abierto
| Modelo | Organización | Parámetros | Especificaciones | Hardware | Coste |
|---|---|---|---|---|---|
| HunyuanVideo | Tencent | 13B | 720p, texto+imagen | 80GB | ~$0.20 |
| HunyuanVideo-1.5 | Tencent | 8.3B | 480p-1080p, texto+imagen | 14GB | ~$0.05 |
| Mochi 1 | Genmo | 10B | 480p@30fps | 12GB+ | ~$0.10 |
| LTX-Video | Lightricks | — | 768x512, tiempo real | 12GB | ~$0.02 |
| LTX-2 / LTX-2.5 | Lightricks | 19B (2) / 22B (2.5) | 4K, audio sincronizado, múltiples planos en 2.5 | Gama alta | ~$0.30 |
| Wan 2.1 | Alibaba | 1.3-14B | 480p-720p | 8GB+ | ~$0.03 |
| Wan 2.2 | Alibaba | 27B MoE (14B activos) | 720p, MoE | 8GB+ | ~$0.03 |
| CogVideoX1.5-5B | Tsinghua | 5B | 1360x768@16fps, hasta 10 s | 12GB | ~$0.04 |
| SkyReels-V3 | Skywork | 14-19B | Impulsado por audio, referencia a vídeo, V2V | Gama alta | ~$0.10 |
| MiniMax H3 | MiniMax | 33B | 2K, 4-15 s, audio estéreo, hasta 9 imágenes de referencia | Gama alta | sin evaluar |
| Step-Video-T2V | StepFun | 30B | Mayor modelo T2V abierto, 204 fotogramas | Gama alta | ~$0.15 |
| Open-Sora 2.0 | HPC-AI | 11B | Integración con Flux | Gama alta | ~$0.20 |
Pesos: HunyuanVideo ↗ · Mochi 1 ↗ · Wan 2.1 ↗ · Open-Sora ↗
Ver muestras: Galería de HunyuanVideo ↗ · Ejemplos de Mochi ↗ · Muestras de CogVideoX ↗
Qué significa esto para los creadores
HunyuanVideo supera a Runway Gen-3 en evaluaciones profesionales y es completamente abierto. ¿El inconveniente? Necesitas hardware potente. Una A100 o H100 con 80 GB de VRAM. Para la mayoría de nosotros, eso significa alquilar GPU en la nube cuando las necesitemos.
HunyuanVideo-1.5 cambió por completo los requisitos de hardware. Tencent lo publicó en noviembre de 2025 como un modelo abierto de 8.3B parámetros que funciona en una GPU de consumo con 14 GB, con generación de texto a vídeo y de imagen a vídeo a 480p/720p, además de escalado opcional a 1080p. Un nuevo mecanismo de atención selectiva y por mosaicos deslizantes (Selective and Sliding Tile Attention, SSTA) le proporciona aproximadamente el doble de velocidad de inferencia que el HunyuanVideo original. Si querías la calidad de HunyuanVideo pero no podías justificar una tarjeta de 80 GB, esta es la versión que realmente puedes ejecutar en casa.
Mochi 1 es el que realmente puedes ejecutar. Una GPU de 12 GB —territorio de la RTX 3060— lo maneja sin problemas. El resultado es genuinamente creativo y posee una calidad artística distintiva. No alcanza del todo la fidelidad de HunyuanVideo, pero tú controlas el proceso.
LTX-2 es donde la cosa se pone interesante para los juegos. Es el primer modelo abierto que genera audio sincronizado con el vídeo. Imagina cinemáticas cuyo sonido simplemente... encaja. Sin sincronización en posproducción. Lightricks publicó como código abierto todos los pesos y el código de inferencia y entrenamiento en enero de 2026, con salida 4K nativa de hasta 50 fps y audio sincronizado de hasta 20 segundos. Una salvedad sobre la licencia: los pesos abiertos de LTX-2 son gratuitos para uso académico y para uso comercial solo por parte de empresas con ingresos anuales inferiores a $10M, así que comprueba ese umbral antes de basar un negocio en él. El checkpoint actual en septiembre de 2026 es LTX-2.5, un modelo de 22B que añade generación nativa de múltiples planos (varios planos conectados con un mismo personaje y estilo), un decodificador de vídeo por difusión en lugar de una reconstrucción VAE convencional y un codificador de texto Gemma 4 12B para prompts más largos. Todo ello sigue sujeto a la licencia comunitaria LTX-2.x, con el mismo límite de ingresos de $10M y un acuerdo de pago por encima de él.
SkyReels-V3 (Skywork, enero de 2026) es la nueva línea abierta más destacada. Es un modelo multimodal unificado que ofrece generación de vídeo impulsada por audio, de referencia a vídeo y de vídeo a vídeo en variantes de 14B y 19B, por lo que resulta potente cuando necesitas usar un personaje o una imagen de referencia para dirigir el plano. Step-Video-T2V (StepFun) es el mayor modelo abierto de texto a vídeo, con 30B, y se distribuye bajo una licencia MIT clara; merece la pena conocerlo si para ti una licencia permisiva importa más que poder ejecutarlo en una GPU pequeña.
MiniMax H3 (Hailuo 3.0) es la incorporación abierta más reciente y el modelo que conviene seguir de cerca para crear cinemáticas basadas en referencias. MiniMax lo lanzó como API el 31 de julio de 2026 y publicó los pesos base de 33B en Hugging Face en agosto con dos checkpoints: FL2VA para generación a partir del primer y último fotograma, y Ref2VA, que admite hasta 9 imágenes de referencia, 3 clips de vídeo de referencia y 3 clips de audio (12 archivos en total), y genera entre 4 y 15 segundos con una resolución de hasta 2K y audio estéreo nativo. Utiliza la licencia comunitaria MiniMax H3, y la ficha del modelo pide a los usuarios de EE. UU., la UE, el Reino Unido y Corea del Sur que presenten primero un formulario de solicitud, por lo que no es una solución lista para usar en cualquier estudio.
Wan 2.1 funciona en un portátil gaming. Una GPU de 8 GB basta para las variantes más pequeñas. Si alguna vez has querido crear prototipos mediante generación de vídeo, pero no podías justificar el hardware, esta es tu vía de entrada.
Wan 2.2 (Alibaba, julio de 2025) es el primer modelo de vídeo de código abierto basado en un diseño de mezcla de expertos: 27B parámetros totales, de los cuales solo 14B están activos en cada paso. Se distribuye en versiones de texto a vídeo (T2V-A14B), imagen a vídeo (I2V-A14B) y una variante híbrida de 5B que funciona en GPU de consumo, todas bajo Apache 2.0 para uso comercial.
Conviene conocer una salvedad: Wan 2.2 sigue siendo la última versión abierta de Wan. Las versiones más recientes Wan 2.5 (septiembre de 2025), 2.6 (diciembre de 2025), 2.7 (abril de 2026) y ahora Wan 3.0 (agosto de 2026, con clips en plano secuencia de 30 segundos a un máximo de 1080p y entradas de referencia, según Alibaba Cloud Model Studio) añadieron audio sincronizado, 1080p y un control más preciso de los fotogramas, pero solo están disponibles mediante API y no tienen pesos públicos. La organización Wan-AI en Hugging Face sigue llegando únicamente hasta la versión 2.2 en septiembre de 2026, digan lo que digan los sitios de afiliados. Si el autoalojamiento es importante para ti, 2.2 es el límite. LTX-2.5 es el modelo abierto al que recurrir cuando necesitas 4K y audio sincronizado.
El flujo de trabajo más lógico: Mochi 1 o Wan 2.1 para crear prototipos localmente. HunyuanVideo-1.5 o LTX-2.5 en GPU en la nube cuando necesites la calidad final.
Generación de imágenes
Aquí es donde el código abierto ya ha ganado. Los modelos que puedes descargar hoy compiten de verdad con Midjourney. No son «casi igual de buenos»; son realmente competitivos.
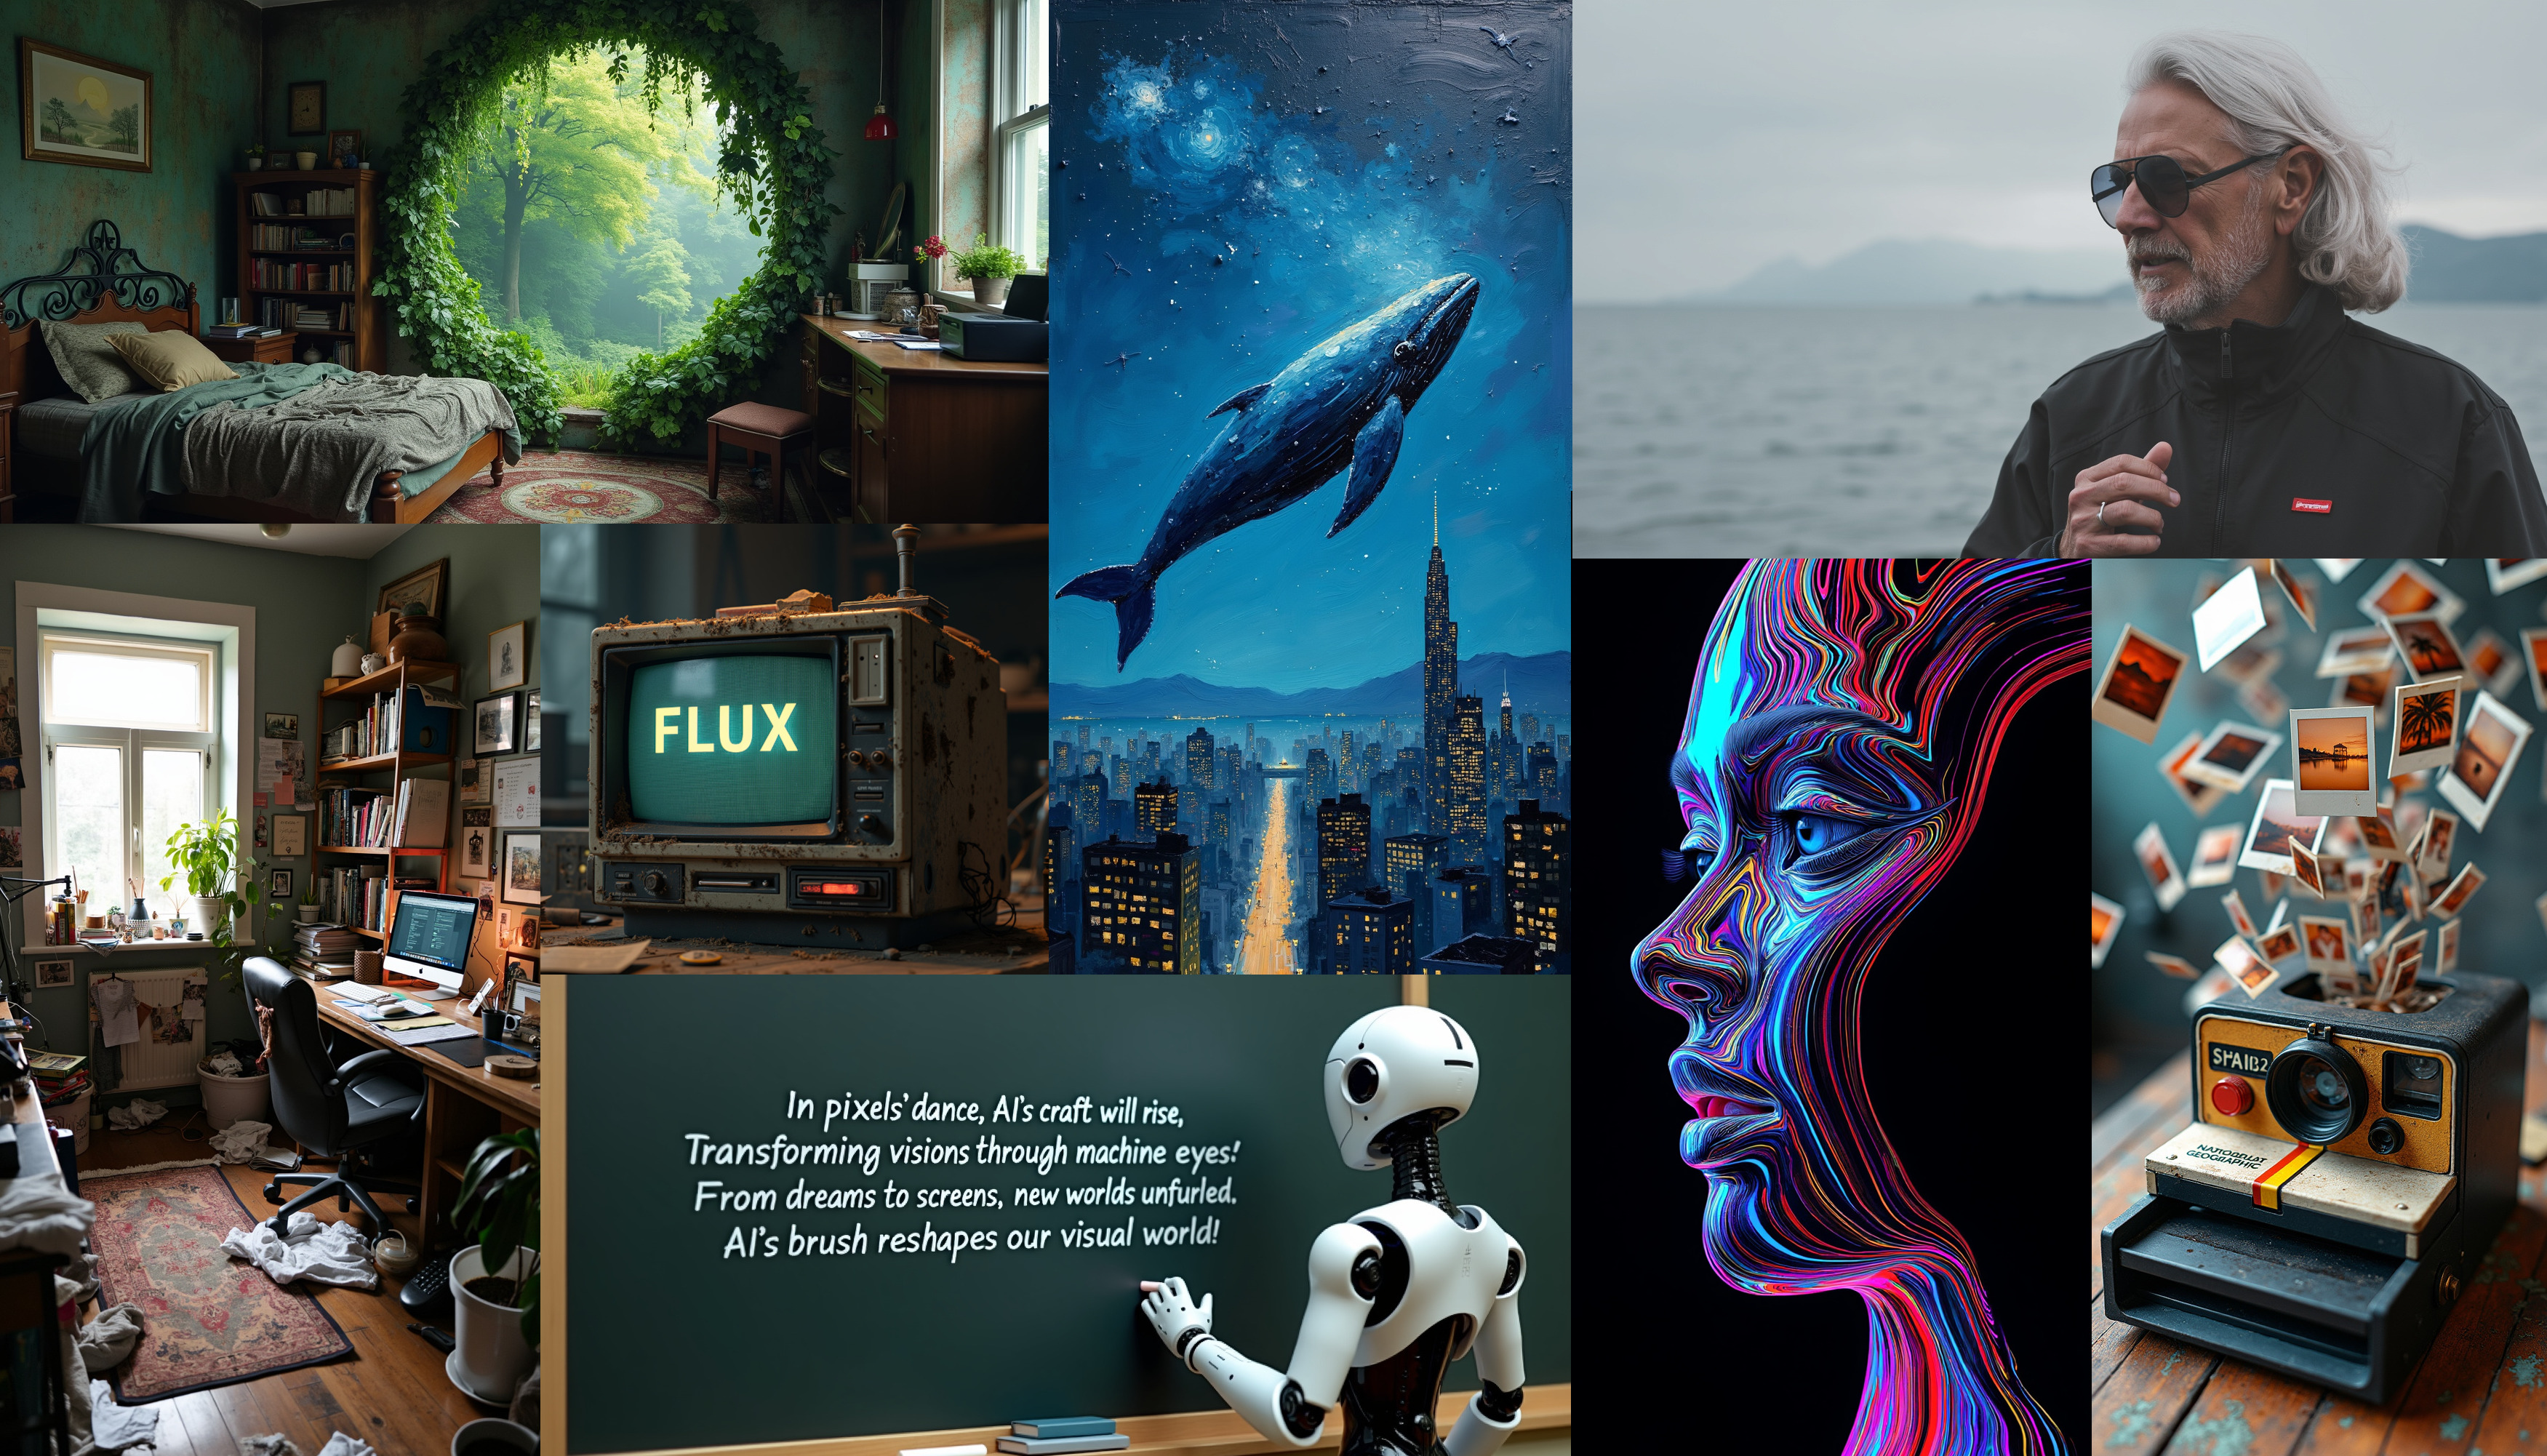 Muestras de FLUX.1, calidad fotorrealista con un modelo bajo licencia Apache 2.0
| Modelo | Organización | Lanzamiento | Parámetros | Característica principal | Licencia | Coste/imagen |
|---|---|---|---|---|---|---|
| FLUX.1 [schnell] | Black Forest Labs | Ago. 2024 | 12B | Generación en 4 pasos, rápida | Apache 2.0 | ~$0.001 |
| FLUX.1 [dev] | Black Forest Labs | Ago. 2024 | 12B | Calidad cercana a Pro | No comercial | ~$0.002 |
| SD 3.5 Large | Stability AI | Oct. 2024 | 8B | Renderizado de texto, estilos diversos | Licencia de Stability | ~$0.002 |
| SD 3.5 Large Turbo | Stability AI | Oct. 2024 | 8B | 4 pasos, rápido | Licencia de Stability | ~$0.001 |
| HiDream-I1 | HiDream.ai | Abr. 2025 | 17B | Alta calidad, variantes Full/Dev/Fast | MIT | ~$0.002 |
| CogView4 | Tsinghua / Zhipu | Mar. 2025 | 6B | Texto nativo en chino, hasta 2048 px | Apache 2.0 | ~$0.002 |
| Qwen-Image | Alibaba | Ago. 2025 | 20B | Renderizado y edición de texto líderes en su categoría | Apache 2.0 | ~$0.002 |
| FLUX.2 | Black Forest Labs | Nov. 2025 | 32B | Texto+edición, 4 MP, múltiples referencias | dev: No comercial / klein 4B: Apache 2.0 | ~$0.003 |
| Ideogram 4.0 | Ideogram | Jun. 2026 | 9.3B | Diseño, renderizado de texto y control de composición mediante JSON | No comercial | ~$0.002 |
Pruébalos directamente: Demo de FLUX.1 schnell ↗ · Demo de SD 3.5 Large ↗ · GitHub (FLUX) ↗
Ver muestras: Galería de FLUX ↗ · Galería de FLUX LoRA ↗ · Ejemplos de Replicate ↗
Para crear recursos de juego
FLUX.1 [schnell] es el modelo que debes conocer. Tiene licencia Apache 2.0, lo que significa que puedes publicar juegos comerciales sin preocuparte por problemas de licencias. Genera en solo 4 pasos, por lo que puedes iterar con rapidez. Describe lo que quieres, observa el resultado, ajústalo y repite.
SD 3.5 Large por fin gestiona correctamente el renderizado de texto. Las versiones anteriores deformaban cualquier texto que intentaras incluir. Esto importa para maquetas de interfaces, carteles dentro del juego, pantallas de título y cualquier otro lugar donde necesites palabras legibles en tus imágenes.
FLUX.2 (Black Forest Labs, noviembre de 2025) es su sucesor de mayor tamaño: un modelo de 32B que gestiona la generación de texto a imagen y la edición de imágenes en un único checkpoint, con una sólida coherencia de personajes y estilos mediante múltiples referencias, además de un renderizado de texto fiable con resoluciones de hasta 4 megapíxeles. FLUX.2 [dev], con pesos abiertos, utiliza una licencia no comercial, pero FLUX.2 [klein], la versión destilada por tamaño (enero de 2026), distribuye su variante de 4B bajo Apache 2.0, genera en menos de un segundo y funciona con unos 8 GB de VRAM, por lo que sigue existiendo una opción comercialmente segura para publicar arte de juegos. Descarga específicamente klein 4B: la versión klein 9B, de mayor tamaño, sigue bajo la licencia no comercial de FLUX. Los procesos cuantizados permiten ejecutar [dev] en GPU de 18-24 GB. La próxima generación de Black Forest Labs, FLUX 3, es un modelo conjunto de imagen, vídeo y audio anunciado el 23 de julio de 2026 y, en septiembre de 2026, solo está disponible mediante API: el vídeo con audio sincronizado se lanzó como versión preliminar el 4 de agosto, y FLUX 3 Dev con pesos abiertos está «previsto para más adelante en 2026», según las notas de la versión de BFL. Hasta que llegue, klein 4B sigue siendo la variante de FLUX segura para uso comercial.
Hay otras dos opciones abiertas que merece la pena conocer. Chroma1-HD (8.9B, Apache 2.0) es un derivado completamente abierto de FLUX.1-schnell, por lo que constituye la forma segura para uso comercial de obtener la calidad de la familia FLUX sin la licencia de [dev]. OmniGen2 (Apache 2.0) es un modelo unificado que ofrece texto a imagen y edición basada en instrucciones en un mismo lugar, lo que supone la vía más rápida cuando estás iterando sobre un recurso existente («haz que la espada brille en azul») en vez de generar desde cero.
Qwen-Image (Alibaba, agosto de 2025) es el modelo abierto al que recurrir cuando tu arte necesita texto legible, como carteles, interfaces, pósteres o etiquetas de objetos. Es un modelo de 20B bajo Apache 2.0, con renderizado de texto líder en su categoría y una potente variante de edición basada en instrucciones, por lo que es seguro para uso comercial y excepcionalmente bueno en algo que la mayoría de los modelos de imagen todavía hacen mal. La actualización de diciembre de 2025, Qwen-Image-2512, mejoró el realismo humano y la composición del texto, y mantuvo la licencia Apache 2.0, así que descarga ese checkpoint si vas a alojarlo tú mismo. El Qwen-Image-2.0 más reciente (febrero de 2026) solo está disponible mediante API y, en septiembre de 2026, el repositorio de QwenLM sigue mostrando Qwen-Image-2512 y Qwen-Image-Edit-2511 como los checkpoints más recientes con pesos públicos. Ideogram 4.0 (junio de 2026) es el primer lanzamiento de pesos abiertos de Ideogram: un transformador de difusión de 9,3B creado para trabajos de diseño, con una sólida representación de texto multilingüe y control explícito de la composición y el color mediante prompts JSON estructurados. Hay una salvedad antes de usarlo como base: el código de inferencia tiene licencia Apache 2.0, pero los pesos están sujetos a una licencia no comercial, por lo que es una herramienta de investigación y prototipado a menos que compres la licencia comercial.
El ecosistema en torno a Stable Diffusion sigue sin tener rival. ControlNet para controlar la composición con precisión. Inpainting para hacer correcciones. Ajuste fino con LoRA para estilos personalizados. FLUX está recuperando terreno, pero, si hoy necesitas una personalización profunda, la madurez de las herramientas de SD te ofrece más posibilidades.
Yo lo plantearía así: para texturas y sprites, cualquiera de los dos sirve. Para arte conceptual con requisitos de estilo específicos, SD 3.5 con LoRA. Para obtener la máxima calidad en un lanzamiento comercial, FLUX schnell.
Generación 3D
Si alguna vez has pasado ocho horas modelando un objeto que aparece en tu juego durante tres segundos, esta sección es para ti. La generación 3D pasó de ser «una investigación interesante» a convertirse en una verdadera herramienta de producción hace ya algún tiempo y, en 2026, los modelos abiertos son realmente buenos. Puedes pasar de un boceto a una malla con texturas en menos de un minuto.
Esta página trata sobre los modelos abiertos que puedes alojar por tu cuenta. Si estás eligiendo una herramienta en vez de un modelo, nuestra guía de los mejores generadores de modelos 3D con IA compara las opciones alojadas (Meshy, Tripo, Rodin y Hi3D) con las abiertas, incluidos los precios y los derechos de uso comercial de cada una.
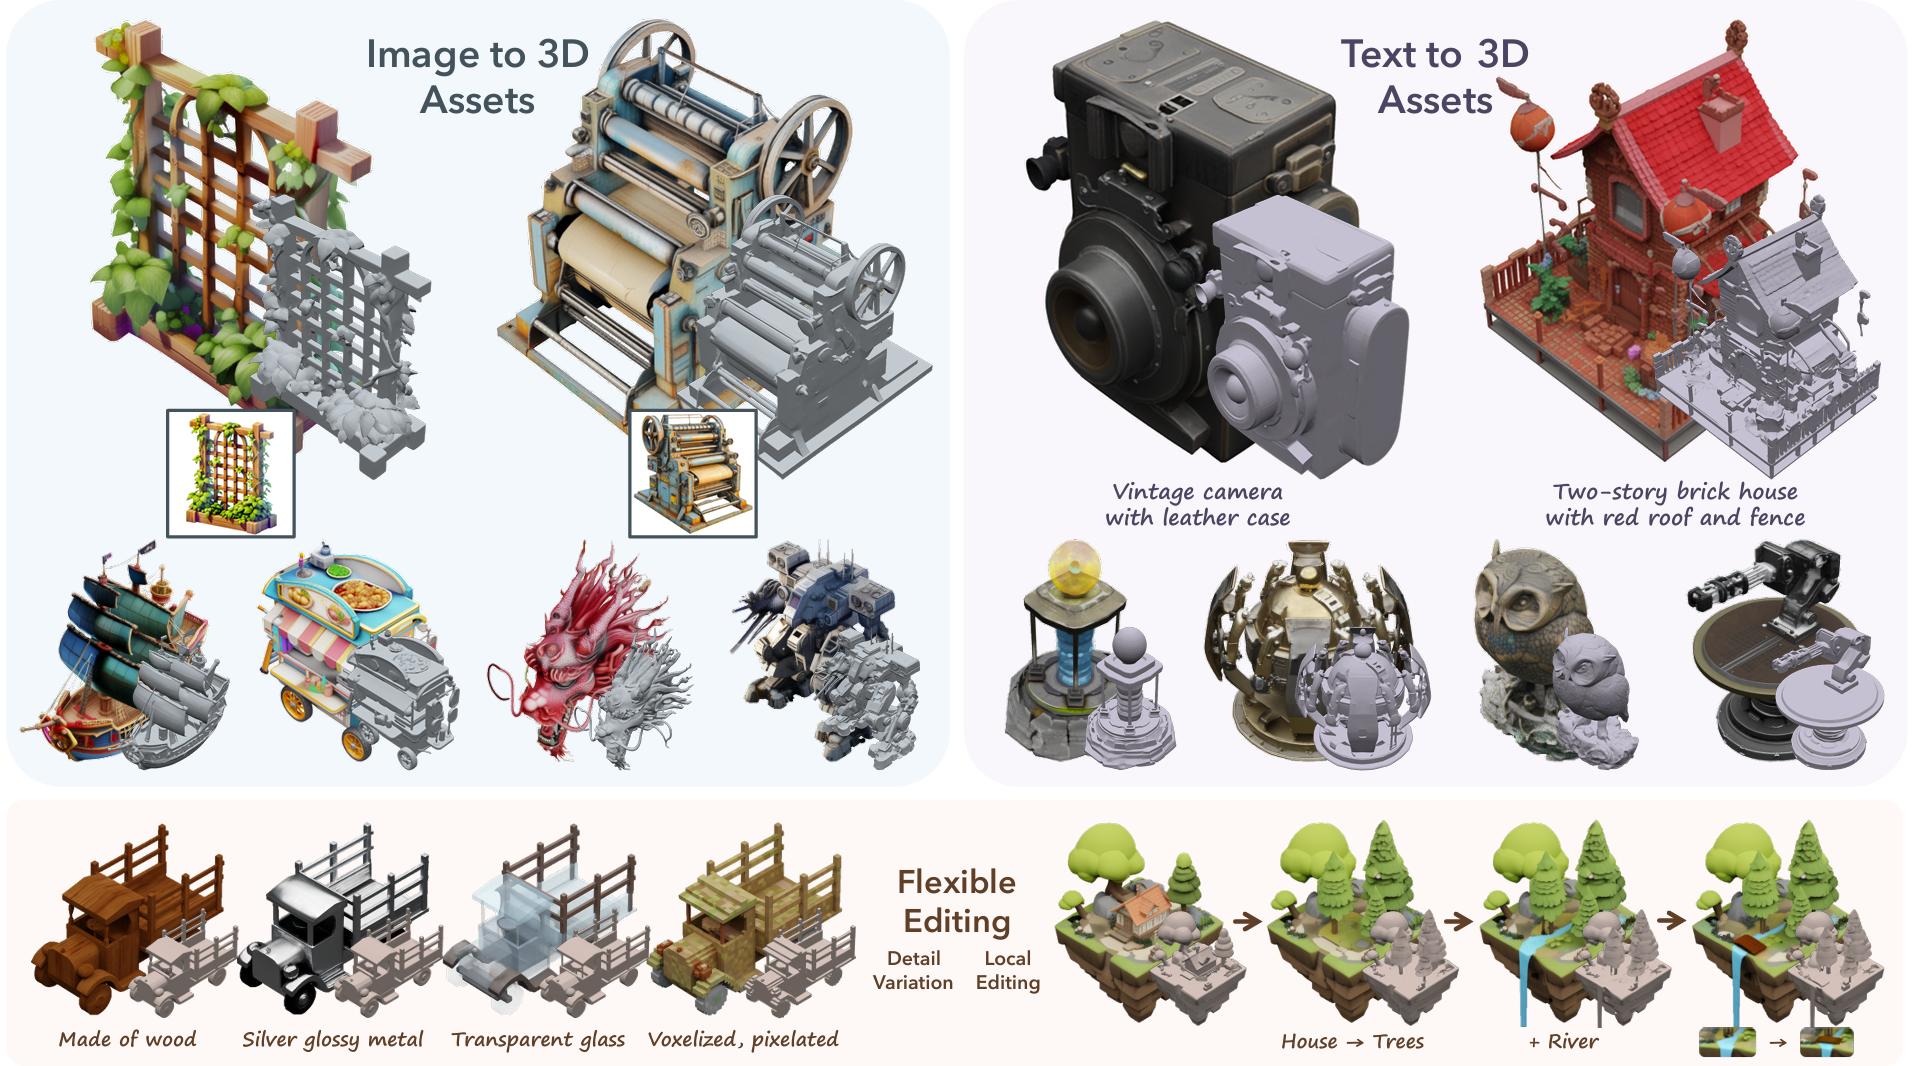 TRELLIS genera mallas 3D con texturas y materiales PBR a partir de imágenes individuales
| Modelo | Organización | Lanzamiento | Característica principal | Resultado | Coste/malla |
|---|---|---|---|---|---|
| TRELLIS.2-4B | Microsoft | dic. de 2025 | 4B de parámetros, PBR nativo, hasta 1536³ | Malla con texturas y normales | ~0,03 USD |
| Hunyuan3D 2.1 | Tencent | jun. de 2025 | PBR para producción, pesos completos y código de entrenamiento | Malla con texturas de alta fidelidad | ~0,05 USD |
| SAM 3D | Meta | nov. de 2025 | De una sola imagen a 3D (objetos y cuerpos humanos) | Malla a partir de una foto | ~0,02 USD |
| Stable Fast 3D | Stability AI | ago. de 2024 | De una imagen a una malla en ~0,5 s | Malla rápida con texturas | ~0,001 USD |
| TripoSG | VAST-AI | mar. de 2025 | Generación de formas mediante flujo rectificado con 1,5B de parámetros | Malla de alta calidad | ~0,01 USD |
| TripoSR | Stability / Tripo | 2024 | Reconstrucción rápida a partir de una sola imagen | Malla (sin textura) | ~0,001 USD |
| UniRig | Tsinghua / Tripo | 2025 | Rigging automático: esqueleto y pesos de skinning | Malla con rig y animable | ~0,01 USD |
Pruébalos directamente: demo de TRELLIS.2 ↗ · demo de Hunyuan3D ↗ · demo de InstantMesh ↗
Ver ejemplos: página del proyecto TRELLIS.2 ↗ · galería de 3D AI Studio ↗
Un flujo de trabajo que realmente funciona
El enfoque que está funcionando entre los creadores combina varios modelos. Empieza con una imagen, ya sea generada o fotografiada. Pásala por Stable Zero123 o Wonder3D para obtener varias vistas. Envía esas vistas a InstantMesh o TripoSR para generar la malla. Después, utiliza TRELLIS.2 o Hunyuan3D para obtener materiales adecuados.
TRELLIS.2 de Microsoft es el nuevo líder para crear recursos listos para producción. Gestiona la geometría que hace fallar a otros modelos: superficies finas, agujeros y topologías complejas. La versión de 4B de parámetros produce mallas con auténticas texturas PBR, no simples colores de vértices que pretenden ser materiales.
Stable Fast 3D apuesta por la velocidad. Tarda aproximadamente medio segundo en pasar de una imagen a una malla. La malla requiere retoques y texturizado, pero ¿para crear prototipos? ¿Para averiguar si una idea funciona antes de invertir horas? Es imbatible. TripoSG es el siguiente paso cuando quieres una geometría más limpia a partir de una sola imagen.
Hunyuan3D 2.1 es el modelo abierto de Tencent que debes utilizar: incluye los pesos completos y el código de entrenamiento, además de texturizado PBR con calidad de producción. Presta atención a los nombres, porque suelen causar confusión. Hunyuan3D 2.5, 3.0 y 3.1 existen, pero solo están disponibles mediante API y no tienen pesos públicos, por lo que, para el autoalojamiento, el generador base sigue estando limitado a la versión 2.1 (un hilo de GitHub en el que se pregunta a Tencent si publicará la versión 2.5 como código abierto seguía sin respuesta en septiembre de 2026). Si prefieres probarlo en vez de alojarlo, nuestro generador 3D ejecuta Hunyuan3D en el navegador. Tencent sí publicó dos extensiones útiles basadas en la versión 2.1: Hunyuan3D-Omni añade control mediante múltiples condiciones (nubes de puntos, vóxeles, esqueletos y cajas delimitadoras), mientras que Hunyuan3D-Part descompone una malla en partes editables. Su licencia también excluye a la UE, el Reino Unido y Corea del Sur, así que revisa las condiciones antes de publicar en esas regiones.
SAM 3D (Meta, noviembre de 2025) es la opción más reciente: convierte una sola foto en una malla 3D y ofrece modelos distintos para objetos y cuerpos humanos. Al combinarlo con el trabajo de segmentación de Meta, puedes aislar un objeto de una imagen y reconstruir únicamente ese objeto.
UniRig (Tsinghua y Tripo, MIT) resuelve el problema con el que todos se encuentran justo después de obtener una malla: el rigging. Genera automáticamente un esqueleto válido y los pesos de skinning de una malla de entrada, por lo que un personaje generado puede animarse de verdad en lugar de quedarse como un objeto estático. Combínalo con el trabajo de animación automática de SOMA-X de NVIDIA y un personaje totalmente generado y equipado con rig deja de ser una demostración de investigación.
Esta es una expectativa realista para creadores independientes: genera arte conceptual con FLUX, pásalo por InstantMesh para obtener la geometría y después aplica las texturas en Blender o utiliza TRELLIS para automatizar el PBR. Hablamos de entre 30 y 60 minutos por recurso, en vez de entre 4 y 8 horas. No elimina todo el trabajo, pero la diferencia es real.
Audio y música
La generación de audio todavía no ha alcanzado a la de imágenes y vídeo. Sin embargo, ya hay suficientes herramientas para cambiar tu forma de trabajar, especialmente al crear prototipos y efectos de sonido.
Ejemplo de música generada con IA. Describe el ambiente que buscas y obtén música que encaje
| Modelo | Organización | Lanzamiento | Función | Licencia | Coste/30 s |
|---|---|---|---|---|---|
| ACE-Step 1.5 | StepFun/ACE Studio | ene. de 2026 | Genera rápidamente ~4 min de música, admite 19 idiomas y clona voces | MIT | ~0,02 USD |
| Stable Audio 3.0 | Stability AI | may. de 2026 | Canciones de hasta ~6 min; modelos abiertos Small, Small-SFX y Medium | Stability Community | ~0,02 USD |
| YuE | MAP | ene. de 2025 | Canciones completas a partir de letras, con voces y acompañamiento | Apache 2.0 | ~0,05 USD |
| MusicGen | Meta | 2023 | Música a partir de texto, controlable | código MIT / pesos CC-BY-NC | ~0,01 USD |
| DiffRhythm 2 | ASLP-lab | feb. de 2026 | Generación rápida de canciones completas | Apache 2.0 | ~0,02 USD |
| Magenta RealTime | jun. de 2025 | Música en tiempo real controlable mediante prompts | código Apache / pesos CC-BY | ~0,02 USD |
Pruébalos directamente: demo de MusicGen ↗ · entorno de pruebas de AudioCraft ↗
Ver ejemplos: ejemplos de MusicGen ↗ · ejemplos de AudioGen ↗
Lo que realmente puedes incluir en un lanzamiento
MusicGen de Meta sigue siendo una opción práctica para crear prototipos de audio para juegos. Describe el ambiente que buscas, obtén música que encaje y ejecútalo sin problemas en una GPU de 12 GB. Hay una salvedad con la licencia: el código de MusicGen es MIT, pero los pesos del modelo son CC-BY-NC (no comercial), así que úsalo para crear prototipos y cambia a un modelo con licencia comercial, como ACE-Step o Stable Audio, para todo lo que vayas a publicar.
El modelo abierto de efectos de sonido de Stable Audio (Small-SFX) se ocupa de pasos, chirridos de puertas, viento ambiental y sonidos mecánicos, se ejecuta localmente y se distribuye bajo la licencia comunitaria de Stability. Por tanto, es la opción abierta de SFX a la que recurrir cuando necesitas sonidos que realmente puedas utilizar con fines comerciales. Es el modelo que conviene elegir porque los demás modelos abiertos de SFX imponen restricciones: AudioGen de Meta utiliza CC-BY-NC y TangoFlux está sujeto a la licencia comunitaria no comercial de Stability, por lo que ambos solo sirven para prototipos de un juego que vaya a publicarse.
Magenta RealTime (Google) destaca de la mejor manera posible: es el único modelo de pesos abiertos creado para generar música en tiempo real y controlarla continuamente mediante prompts. En vez de renderizar una pista terminada, genera música en directo que puedes dirigir mientras se reproduce, exactamente el formato de una banda sonora adaptativa para juegos que cambia según lo que haga el jugador. El código utiliza Apache 2.0 y los pesos CC-BY; ambas licencias permiten el uso comercial.
YuE es realmente emocionante. Es el primer modelo abierto que genera canciones completas con voces. Temas musicales. Música de fondo con canto real. La calidad varía, pero está a años luz de cualquier otra opción que puedas descargar y ejecutar por tu cuenta.
ACE-Step es el modelo abierto de música que debes conocer ahora, y ha avanzado con rapidez: la línea 1.5 (enero de 2026, con una variante XL más grande de 5B) sustituye al lanzamiento original de mayo de 2025 y ahora utiliza la licencia MIT. Genera rápidamente varios minutos de música, admite 19 idiomas y permite clonar voces, hacer remezclas y editar letras. Para crear prototipos de juegos, cubre buena parte de las carencias que dejaron YuE y MusicGen.
Stable Audio 3.0 (mayo de 2026) es la actualización más importante para el sonido. Puede generar canciones de hasta unos seis minutos, y Stability publicó los pesos abiertos de tres de sus cuatro variantes: Small y el modelo específico para efectos de sonido Small-SFX se ejecutan directamente en el dispositivo, mientras que Medium ofrece una mejor estructura musical y permite crear pistas con la duración máxima. Solo el modelo Large quedó limitado a la API. Small-SFX es ahora la opción abierta más potente específicamente para efectos de sonido de juegos. Los tres modelos abiertos se distribuyen bajo la Stability AI Community License, que permite usar y vender el contenido que generan, con una licencia Enterprise para empresas con más de $1 millón de ingresos anuales, según el anuncio de Stability. Toda la familia se entrenó con datos bajo licencia, por lo que su situación legal es más sólida que la de los generadores de música sujetos a litigios aún sin resolver.
Esta es la valoración sincera: la diferencia entre los modelos abiertos y los cerrados (Suno y Udio) se está reduciendo, pero sigue siendo real en el caso de las canciones completas con voces; además, esas herramientas cerradas también están sujetas a litigios pendientes sobre sus datos de entrenamiento. Para efectos de sonido, los modelos abiertos —especialmente el modelo SFX de Stable Audio— son verdaderamente competitivos. En el caso de las canciones que quieras publicar, tendrás que iterar mucho o contar con un músico para la producción final y utilizar estas herramientas para todo lo demás.
Habla y voz
La generación de voz ya ha superado con creces el umbral de «suficientemente buena para juegos», y eso cambia lo que pueden hacer los equipos pequeños.
Narración de juego generada con IA, con habla natural, un ritmo adecuado y emoción
| Modelo | Organización | Lanzamiento | Característica principal | Licencia | Coste/min |
|---|---|---|---|---|---|
| Qwen3-TTS | Alibaba | ene. de 2026 | Clonación de voz en 3 s, diseño de voces y 10 idiomas | Apache 2.0 | ~0,002 USD |
| Chatterbox | Resemble AI | 2025 | Control de emociones, clonación a partir de ~5 s y 23 idiomas | MIT | ~0,003 USD |
| CSM | Sesame AI | mar. de 2025 | Fluidez conversacional y pausas naturales | Apache 2.0 | ~0,005 USD |
| Fish Speech 1.5 | Fish Audio | 2024 | Clonación zero-shot a partir de 10-30 s | código Apache / pesos CC-BY-NC-SA | ~0,002 USD |
| OpenVoice V2 | MyShell/MIT | abr. de 2024 | Control de emociones y acentos | MIT | ~0,003 USD |
| XTTS-v2 | Coqui (comunidad) | 2024 | 17 idiomas y clonación de voz | CPML (no comercial) | ~0,005 USD |
Escucha ejemplos: voces de Fish Audio ↗ · demo de OpenVoice ↗
Cómo hacer que los PNJ suenen como personas
CSM (Conversational Speech Model) de Sesame se creó específicamente para diálogos. Produce pausas naturales. Cambios de entonación. El ritmo de una conversación real. La mayoría de los sistemas TTS suenan como alguien leyendo un guion, y se nota al instante. CSM suena como alguien hablando. Esa diferencia importa más de lo que parece.
Qwen3-TTS (Alibaba, enero de 2026) es la opción a la que recurrir para proyectos comerciales. Toda la familia utiliza Apache 2.0, clona una voz a partir de unos 3 segundos de audio de referencia, habla 10 idiomas y permite diseñar voces mediante descripciones, por lo que puedes definir la voz de un PNJ con texto normal en vez de buscar grabaciones de referencia. Los modelos de 0,6B y 1,7B se ejecutan en hardware modesto. Chatterbox (Resemble AI) es la opción ideal para voces expresivas y tiene licencia MIT, por lo que puedes incluirlo en un producto publicado. Clona una voz a partir de unos 5 segundos de audio, funciona con una latencia inferior a 200 ms, admite 23 idiomas y es el primer modelo abierto con un control de exageración emocional, así que un PNJ puede sonar realmente enfadado o asustado en lugar de inexpresivo. Otras dos opciones con licencia Apache 2.0 cubren nichos específicos: Orpheus (Canopy) admite etiquetas emocionales insertadas en el texto, como <laugh> y <sigh>, que se adaptan perfectamente a las frases breves de los PNJ, y ofrece una variante de 150M para hardware de gama baja; por su parte, Dia (Nari Labs) está diseñado para diálogos con varios interlocutores y puede generar elementos no verbales, como toses y risas, en una sola pasada. Voxtral TTS de Mistral (marzo de 2026) es un modelo más reciente de pesos abiertos orientado a agentes de voz, según la página de noticias de Mistral, pero lee su licencia antes de publicarlo.
Fish Speech y OpenVoice se encargan de la clonación de voz. Graba entre 10 y 30 segundos de un actor de voz y luego genera diálogos ilimitados con esa voz. Piensa en lo que esto implica: puedes contratar talento de voz para las líneas clave y después ampliar su interpretación para cubrir cientos de variaciones y diálogos ambientales. Una observación sobre la licencia de Fish Speech: el código es abierto, pero los pesos de la versión 1.5 tienen licencia CC-BY-NC-SA, así que es una herramienta de prototipado. Para juegos publicados, utiliza OpenVoice (MIT) o Qwen3-TTS (Apache 2.0).
NVIDIA ACE (no es totalmente abierto, pero merece la pena conocerlo) ya admite Qwen3-8B para desplegar PNJ en el dispositivo. LLM local + TTS local + sincronización labial, todo ejecutándose en GPU de consumo. Esta es la pila adecuada para conversaciones en tiempo real con PNJ que no necesitan realizar llamadas a la nube.
El enfoque más razonable para creadores independientes es contratar actores de voz para los personajes principales y las líneas más importantes. Utiliza Qwen3-TTS u OpenVoice para ampliar la cobertura con diálogos ambientales, variaciones y todas las líneas secundarias que, de otro modo, quedarían sin voz o resultarían prohibitivamente caras.
Modelos de mundo y simulación de juegos
Aquí es donde las cosas se vuelven realmente extrañas y realmente emocionantes. Estos modelos no generan recursos estáticos. Generan experiencias que se sienten como juegos.
🎮 Juega a Oasis: Minecraft generado por IAGeneración de mundos en tiempo real sin motor de juego, solo predicción mediante IA
| Modelo | Organización | Lanzamiento | Qué hace | Estado | Coste/fotograma |
|---|---|---|---|---|---|
| DIAMOND | Investigación | 2024 | Modelo de mundo de difusión, simulación de Atari | Pesos abiertos | ~$0.001 |
| Oasis | Decart/Etched | Oct 2024 | Generación de Minecraft en tiempo real | Pesos del modelo 500M abiertos | ~$0.002 |
| MineWorld | Microsoft | Abr 2025 | Minecraft en tiempo real, alternativa abierta a Oasis | MIT | ~$0.002 |
| Hunyuan-GameCraft | Tencent | Ago 2025 | Vídeo interactivo de juegos, control con teclado/ratón | Tencent Community | ~$0.005 |
| GameGen-X | Investigación | 2024 | Generación de vídeo de mundos abiertos | Código + conjunto de datos abiertos | ~$0.005 |
| NVIDIA Cosmos | NVIDIA | Oct 2025 | Simulación de IA física (Predict2.5) | NVIDIA Open Model License | ~$0.01 |
| Matrix-Game 3.0 | Skywork | Mar 2026 | Mundos interactivos a 720p en tiempo real, memoria a largo plazo | Pesos abiertos | ~$0.005 |
| Genie 2 | DeepMind | Dic 2024 | Entornos 3D interactivos a partir de imágenes | No publicado | N/D |
| Genie 3 | DeepMind | Ago 2025 | Mundos a 720p en tiempo real, eventos controlables mediante instrucciones | Cerrado (Project Genie) | N/D |
Consulta la investigación: página del proyecto DIAMOND ↗ · blog de Cosmos ↗
Pruébalo: demostración en vivo de Oasis ↗ · ejemplos de Genie 2 ↗
Por qué debería importarte
DIAMOND demostró algo que cambia la forma de pensar sobre la IA para juegos. Puedes entrenar a un agente íntegramente dentro de un mundo generado. No hace falta un motor de juego real para el entrenamiento. La IA juega en la imaginación de un modelo de difusión y después transfiere lo aprendido al juego real. Las implicaciones son importantes.
Oasis ejecuta un mundo similar a Minecraft en tiempo real. Fotograma a fotograma. Sin motor de juego, texturas ni recursos prediseñados. Solo un transformer que predice qué viene a continuación. Es una prueba de concepto, pero imagina hasta dónde puede llegar. La versión de 500M parámetros ya es abierta.
GameGen-X publicó el mayor conjunto de datos de vídeo de juegos de mundo abierto. Si quieres entrenar tus propios modelos o ajustar modelos existentes para generar contenido similar al de un juego, este es tu punto de partida.
NVIDIA Cosmos se creó para robótica y vehículos autónomos, pero sus modelos fundacionales de mundo también sirven para juegos. Entienden la física, la permanencia de los objetos y las relaciones espaciales. La línea abierta actual es Cosmos-Predict2.5, publicada en octubre de 2025 bajo la NVIDIA Open Model License, que permite el uso comercial y la creación de obras derivadas.
Hunyuan-GameCraft (Tencent, agosto de 2025) es el modelo de mundo abierto más orientado directamente a los juegos. Se entrenó con más de un millón de grabaciones de más de 100 juegos AAA y unifica las entradas de teclado y ratón en un espacio de control compartido, por lo que genera vídeo interactivo de juegos que puedes controlar de verdad en lugar de limitarte a mirar. Utiliza la misma Tencent Community License que Hunyuan3D, con las mismas exclusiones para la UE, el Reino Unido y Corea del Sur, así que comprueba las condiciones antes de publicar allí. MineWorld (Microsoft, MIT) es la alternativa totalmente permisiva a Oasis: un modelo de mundo de Minecraft en tiempo real que puedes descargar y ejecutar sin un motor de juego.
Genie 3 (DeepMind, anunciado en agosto de 2025) supone un salto que merece atención: es el primer modelo de mundo con interacción en tiempo real, capaz de generar mundos navegables a 720p y 24 fps que mantienen la coherencia durante varios minutos, además de «eventos del mundo controlables mediante instrucciones» que cambian el clima o añaden objetos a petición. Se abrió al público como Project Genie en enero de 2026 para los suscriptores de Google AI Ultra en Estados Unidos. Sus pesos siguen siendo cerrados, pero muestra hacia dónde se dirigen los mundos generados y jugables.
Matrix-Game 3.0 (Skywork, marzo de 2026) es la respuesta abierta a Genie. Es un modelo de mundo interactivo con memoria aumentada que transmite a 720p y 40 fps en tiempo real y mantiene la coherencia de las escenas durante secuencias de un minuto. Una versión destilada de 5B permite inferencias en tiempo real, una versión MoE 2x14B más grande mejora la calidad y los pesos están disponibles en Hugging Face bajo Apache 2.0. Si quieres experimentar hoy con mundos generados jugables en lugar de esperar a DeepMind, este es el que realmente puedes descargar.
Para el desarrollo práctico de juegos actual, estas siguen siendo herramientas de investigación. Pero si trabajas con contenido impulsado por IA, generación procedimental o simplemente estás pensando hacia dónde se dirige todo esto, esta es la frontera.
Grandes modelos de lenguaje
Los LLM impulsan los diálogos, la generación de misiones y la lógica de juego. Y las opciones abiertas ya compiten de verdad con GPT-4. Esto no era así hace dos años.
| Modelo | Organización | Lanzamiento | Tamaño | Ideal para | Licencia | Coste/1K tokens |
|---|---|---|---|---|---|---|
| DeepSeek-V3 | DeepSeek | Dic 2024 | MoE de 671B (37B activos) | Razonamiento, uso general | Permisiva | ~$0.02 |
| DeepSeek-R1 | DeepSeek | Ene 2025 | Basado en V3 | Cadena de pensamiento | Permisiva | ~$0.03 |
| DeepSeek-V3.2 | DeepSeek | Dic 2025 | Atención dispersa (DSA) | Razonamiento + uso de herramientas | MIT | ~$0.02 |
| DeepSeek-V4 | DeepSeek | Abr 2026 | MoE de 1.6T (49B activos) | Razonamiento de vanguardia, contexto de 1M | MIT | ~$0.02 |
| GLM-5 | Zhipu / Z.ai | Feb 2026 | MoE de 744B (40B activos) | Programación, agentes, uso de herramientas | MIT | ~$0.02 |
| GLM-5.2 | Zhipu / Z.ai | Jun 2026 | MoE de 753B | Programación, agentes, contexto de 1M | MIT | ~$0.02 |
| GPT-OSS | OpenAI | Ago 2025 | MoE de 120B / 20B | Razonamiento, uso de herramientas, ejecución local | Apache 2.0 | ~$0.01 |
| Kimi K2 | Moonshot | 2025 | MoE de 1T (32B activos) | Agentes, programación | MIT modificada | ~$0.02 |
| Kimi K3 | Moonshot | Jul 2026 | MoE de 2.8T (16 de 896 expertos activos) | Agentes de vanguardia, programación, contexto de 1M, visión | Kimi K3 License | ~$0.03 |
| Hy3 | Tencent | Jul 2026 | MoE de 295B (21B activos) | Razonamiento, programación mediante agentes, contexto de 256K | Apache 2.0 | ~$0.02 |
| Gemma 3 | 2025 | 1B-27B | Ejecución local, 140 idiomas, visión | Gemma | ~$0.01 | |
| Gemma 4 | Abr 2026 | De E2B a 31B (MoE 26B-A4B) | Ejecución local, más de 140 idiomas, visión + audio, 256K | Apache 2.0 | ~$0.01 | |
| Qwen3 | Alibaba | 2025 | MoE de 235B (22B activos) | Multilingüe, código | Apache 2.0 | ~$0.01 |
| Qwen3.5 / 3.6 / 3.8 | Alibaba | Feb-Ago 2026 | De 0.8B a 2.4T-A95B | Multimodal, agentes, modelo insignia abierto de categoría Qwen-Max | Apache 2.0 | ~$0.02 |
| Mistral Small 4 | Mistral | Mar 2026 | MoE de 119B (6B activos) | Razonamiento + visión + programación mediante agentes, 256K | Apache 2.0 | ~$0.01 |
| Qwen3-Coder | Alibaba | 2025 | MoE de 480B (35B activos) | Programación mediante agentes, contexto de 256K | Apache 2.0 | ~$0.02 |
| Llama 4 | Meta | 2025 | Varios | Agentes, contexto de hasta 10M | Llama Community | ~$0.01 |
| Muse Glimmer 30B | Meta | Ago 2026 | Denso de ~30B | Agentes en el dispositivo, visión, contexto de más de 128K | Apache 2.0 | ~$0.01 |
| Qwen3-VL | Alibaba | 2025 | 2B-235B | Visión + lenguaje | Apache 2.0 | ~$0.02 |
| InternVL3 | Shanghai AI Lab | 2025 | 1B-78B | Visión, OCR, posicionamiento en interfaces | MIT | ~$0.02 |
Empieza aquí: Qwen3-8B en HuggingFace ↗ · DeepSeek-V3 en HuggingFace ↗ · GLM-5 en HuggingFace ↗
Para crear juegos
Qwen3 es la opción práctica para la mayoría de usos en juegos. Tiene licencia Apache 2.0, lo que significa que tu integración te pertenece. Ofrece una sólida compatibilidad multilingüe, algo importante si estás pensando en la localización. Sigue bien las instrucciones estructuradas. Las variantes 7B y 14B se ejecutan localmente en GPU de consumo.
Qwen3.5, 3.6 y 3.8 mantuvieron la línea Apache 2.0 durante 2026. Qwen3.5 (16 de febrero de 2026) debutó con un MoE 397B-A17B y después añadió variantes densas de 27B, 9B y 4B. Qwen3.6 (abril) ajustó la misma familia para mejorar su estabilidad, y su versión 35B-A3B es el punto ideal para la ejecución local: 35B de conocimiento con solo 3B activos por token, por lo que funciona a toda velocidad en una sola tarjeta de 24 GB. Qwen3.8 (12-14 de agosto de 2026) es el modelo grande, descrito en el repositorio de Qwen3.8 como el primer modelo de categoría Qwen-Max publicado de forma abierta: un modelo insignia 2.4T-A95B junto con otro modelo denso de 27B, ambos con Apache 2.0 y un contexto de 262K.
DeepSeek-V3 iguala o supera a GPT-4 en la mayoría de las pruebas de referencia. Su arquitectura es ingeniosa: solo activa 37B parámetros por token, pese a tener 671B en total. Necesitas hardware potente (varias GPU), pero ofrece calidad de vanguardia sin depender de una API.
DeepSeek-V3.2 (diciembre de 2025) combina el razonamiento y el uso de herramientas en un solo modelo e introduce DeepSeek Sparse Attention (DSA) para abaratar la inferencia con contextos largos, además de una variante Speciale de alto cómputo dirigida a las pruebas de razonamiento más exigentes. Para la lógica y los diálogos de juegos, sustituye a V3 con mayores capacidades y un mejor funcionamiento como agente.
DeepSeek-V4 (abril de 2026) volvió a desplazar la frontera abierta. V4-Pro es un MoE de 1.6T parámetros con solo 49B activos por token, una ventana de contexto de un millón de tokens y modos de razonamiento seleccionables, todo bajo licencia MIT. La variante V4-Flash (284B en total, 13B activos) conserva el contexto de 1M en un paquete que no exige un clúster completo de GPU. Si hoy estás eligiendo un modelo abierto para lógica compleja de misiones o contextos extensos del estado de una partida, este marca el techo actual.
GLM-5 (Zhipu AI, febrero de 2026) es el modelo abierto de referencia para programación y trabajo con agentes, y la actualización GLM-5.2 elevó sus resultados de uso de herramientas y planificación a largo plazo hasta acercarlos a los modelos cerrados de vanguardia. Es un MoE de 744B parámetros con 40B activos por token, un contexto de 200K tokens y licencia MIT. El propio GLM-5.2 se publicó el 17 de junio de 2026 como un MoE de 753B con un contexto de 1M tokens, todavía bajo MIT y sin restricciones regionales; después llegó GLM-5.3, una actualización de posentrenamiento sobre la misma base, con sus pesos en Hugging Face bajo la licencia GLM-5.3 de Z.ai en lugar de MIT, así que revisa ese texto si alojas por tu cuenta la versión más reciente. Z.ai es la primera empresa de modelos fundacionales que cotiza en bolsa y ofrece su API alojada a precios muy competitivos (alrededor de $1.40 por millón de tokens de entrada), pero los pesos están en Hugging Face si prefieres alojarlos por tu cuenta. Si tu juego depende de un LLM para escribir misiones, usar agentes que llaman a herramientas o controlar sistemas basados en código, GLM-5 es una alternativa sólida a OpenAI que puedes controlar por completo. GPT-OSS (OpenAI, agosto de 2025) es el primer lanzamiento de pesos abiertos de OpenAI y encaja de lleno con el tema de esta guía. El modelo gpt-oss-120b razona y utiliza herramientas aproximadamente al nivel de o4-mini en una sola GPU de 80 GB, mientras que gpt-oss-20b funciona en una tarjeta de consumo de 16 GB; ambos se publican bajo Apache 2.0. Si quieres un modelo de un laboratorio occidental que puedas alojar tú mismo para la lógica de los NPC o para agentes que utilizan herramientas, este es el indicado.
Kimi K2 (Moonshot) es el otro gran peso pesado abierto para agentes junto con GLM-5 y DeepSeek. Es un MoE de 1 billón de parámetros con 32B activos, muy optimizado para programación y uso de herramientas, y su licencia MIT modificada solo añade restricciones por encima de los 100 millones de usuarios mensuales, así que para estudios independientes es efectivamente MIT. Úsalo cuando un agente tenga que planificar a lo largo de muchos pasos.
Kimi K3 (Moonshot, julio de 2026) es el modelo de pesos abiertos más grande jamás anunciado y se acerca más a la frontera cerrada que cualquier modelo abierto anterior. Es un MoE de 2,8 billones de parámetros con solo unos 50B activos por token (16 de 896 expertos), un contexto de 1 millón de tokens y visión nativa, construido sobre dos nuevos diseños de atención llamados Kimi Delta Attention y Attention Residuals. En las pruebas de Moonshot de julio superaba a las versiones de Claude Opus y GPT-5.5 de aquel momento en tareas de programación y de agentes, y solo quedaba por detrás de los mejores modelos propietarios, unos objetivos que volvieron a avanzar en septiembre con Claude Fable 5.1 y GPT-6 Astra. Los pesos llegaron a Hugging Face el 27 de julio de 2026 en MXFP4, bajo la licencia Kimi K3 en lugar de MIT. Es permisiva para la mayoría de los usos, pero un negocio de modelo como servicio con más de $20 millones de ingresos durante cualquier periodo de 12 meses necesita un acuerdo separado con Moonshot, y los productos con más de 100 millones de usuarios mensuales o $20 millones de ingresos mensuales deben mostrar "Kimi K3" en la interfaz. Alojar por tu cuenta un modelo de 2,8T sigue requiriendo un clúster de GPU con varios nodos, así que la mayoría de los equipos accederán a él mediante la API, a $3 por millón de tokens de entrada y $15 por millón de tokens de salida. Para agentes que realmente puedas ejecutar tú mismo, K2 sigue siendo la opción práctica de Moonshot, pero K3 redefine lo que puede significar "abierto" en la gama más alta.
Gemma 3 (Google) es la mejor opción cuando necesitas ejecutarlo en el hardware del jugador o localizarlo ampliamente. Está disponible en tamaños de 1B, 4B, 12B y 27B, por lo que escala desde una tarjeta de 8 GB en adelante, admite 140 idiomas, puede llamar a funciones y las variantes de 4B o más también procesan imágenes, así que además sirve como modelo de visión pequeño. La licencia de Gemma permite el uso comercial.
Gemma 4 (Google, 2 de abril de 2026) lo reemplaza para proyectos nuevos y resuelve definitivamente la cuestión de la licencia: toda la familia utiliza Apache 2.0, según la ficha del modelo. Se distribuye como E2B y E4B para teléfonos y portátiles, un 12B, un MoE 26B-A4B con menos de 4B activos y un modelo denso 31B, con un contexto de 128K en los modelos pequeños y de 256K en el resto, entrada nativa de imágenes en todos los tamaños, audio en los pequeños y más de 140 idiomas. Para el cerebro de un NPC ejecutado en el dispositivo que también tenga que mirar una captura de pantalla, el 26B-A4B es la opción indicada.
La línea Llama de Meta está prácticamente pausada. Llama 4 (abril de 2025) sigue siendo el último Llama, y en abril de 2026 Meta Superintelligence Labs lanzó su sucesor, Muse Spark, como modelo cerrado. Meta volvió en parte en agosto de 2026 con Muse Glimmer 30B, un modelo multimodal denso de aproximadamente 30B bajo Apache 2.0, con un contexto de más de 128K y versiones de 4 bits que caben en una tarjeta de 24 GB. Es un potente modelo local para agentes, pero si estabas esperando Llama 5, deja de esperar y elige entre Qwen, Gemma 4 o Glimmer.
Hy3 (Tencent, julio de 2026) es la otra gran llegada bajo Apache 2.0. Es un MoE de 295B con 21B activos y un contexto de 256K, según su ficha del modelo, y la versión de julio eliminó las exclusiones regionales de la vista previa de abril, por lo que, a diferencia de las licencias Hunyuan3D y GameCraft de Tencent, puede utilizarse en la UE, el Reino Unido y Corea del Sur.
Qwen3-Coder (Alibaba) es el modelo abierto dedicado a programación y reemplaza a la antigua línea DeepSeek-Coder para la mayoría de los usos. Es un MoE de 480B con 35B activos, un contexto nativo de 256K (ampliable a 1M), licencia Apache 2.0 y un rendimiento de la categoría de Claude Sonnet en pruebas de programación con agentes. Si tu juego genera o ejecuta código, este es el techo entre los modelos abiertos. La familia europea Mistral es una sólida alternativa que puedes alojar tú mismo: Devstral para programación y Mistral Small 4 (16 de marzo de 2026), un MoE de 119B con 6B activos que reúne razonamiento, visión y programación con agentes en un único modelo Apache 2.0 con un contexto de 256K.
Qwen3-VL añade comprensión visual, con tamaños densos y MoE desde 2B hasta 235B bajo Apache 2.0. Resulta útil para juegos que necesiten analizar capturas de pantalla, comprender contenido dibujado por los jugadores o procesar la entrada de una cámara. La variante 8B funciona en una sola GPU. InternVL3 (Shanghai AI Lab, MIT) es la otra gran opción abierta de visión y lenguaje, especialmente buena en OCR y asociación con elementos de interfaz, algo importante si tus herramientas necesitan leer interfaces de juegos; Pixtral 12B de Mistral (Apache 2.0) es una alternativa más ligera y segura para uso comercial.
Para NPC ejecutados en el dispositivo y personajes que responden en tiempo real sin llamadas a la nube, Qwen3-8B mediante NVIDIA ACE es actualmente la opción más práctica. Se ejecuta junto a tu juego en el hardware del jugador.
Modelos auxiliares
Estos modelos no generan contenido directamente, pero hacen funcionar tus flujos de trabajo.
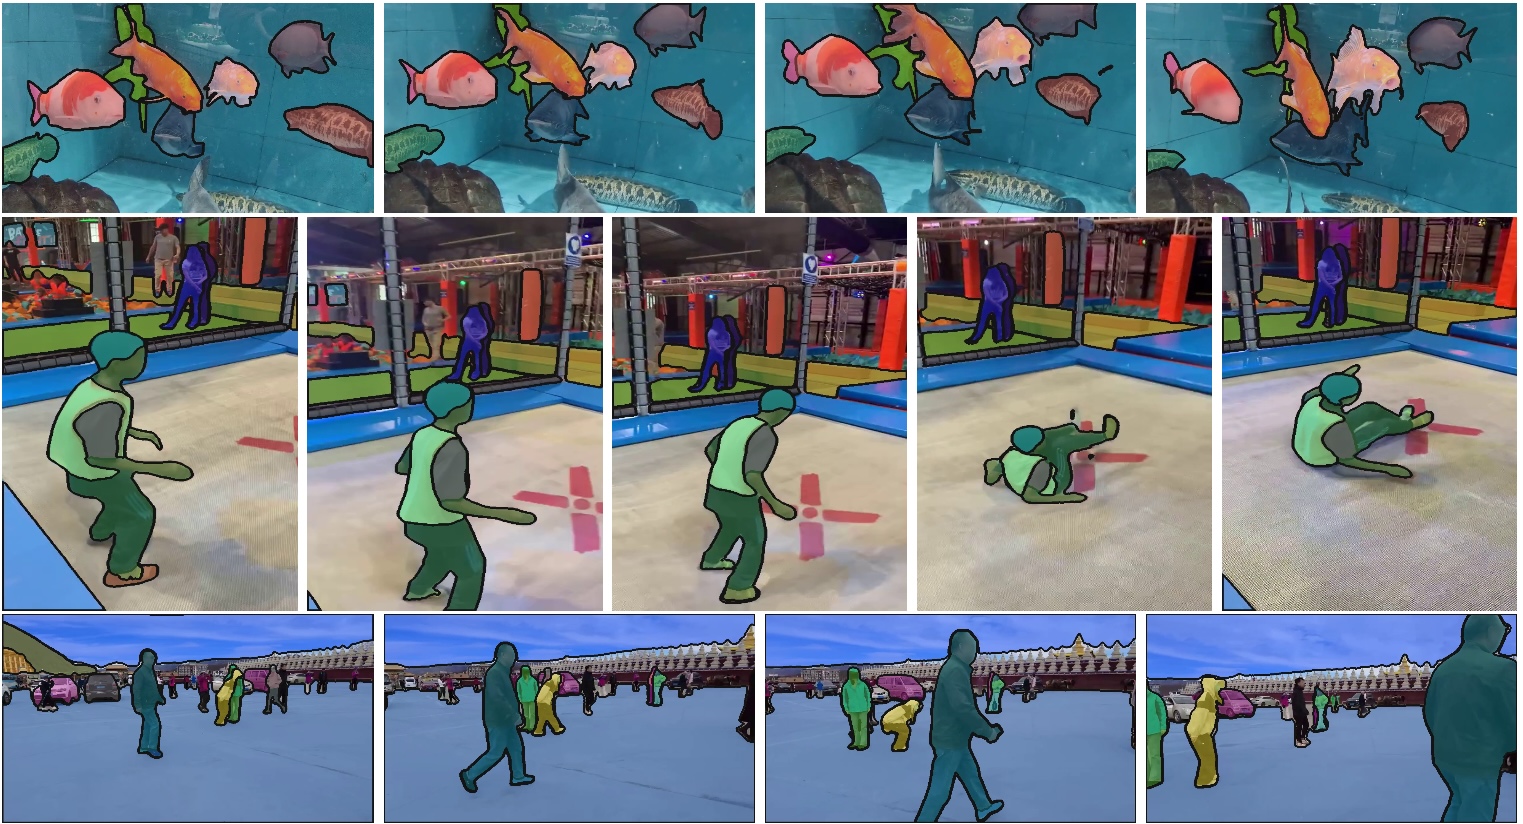 SAM 2 segmenta cualquier objeto en imágenes y vídeos. Haz clic una vez y obtén una máscara perfecta
| Modelo | Organización | Lanzamiento | Qué hace |
|---|---|---|---|
| SAM 2 | Meta | Agosto de 2024 | Segmenta cualquier elemento en imágenes y vídeos |
| Depth Pro | Apple | Octubre de 2024 | Obtiene profundidad métrica a partir de una sola imagen |
| gsplat | Nerfstudio | 2024+ | Splatting gaussiano acelerado mediante CUDA |
SAM 2 segmenta objetos en vídeo en tiempo real. Haz clic en algo y obtendrás una máscara perfecta. Resulta útil para rotoscopia, composición o extracción de objetos de grabaciones para utilizarlos como recursos del juego. Prueba SAM 2 ↗
Depth Pro de Apple produce mapas de profundidad métrica a partir de una sola imagen en menos de un segundo. Esto abre muchas posibilidades: convertir arte 2D en 2,5D con efectos de paralaje, generar datos de profundidad para reconstrucción 3D y crear mapas de normales a partir de imágenes planas. Depth Pro en Hugging Face ↗
gsplat es la implementación rápida del splatting gaussiano. Si estás capturando entornos reales para juegos, ya sea mediante fotogrametría o escaneado de escenarios, esta es la biblioteca que lo hace viable.
Lo que usaría realmente
Si empiezas hoy un proyecto de juego, esta es la combinación de herramientas que tiene sentido:
Texturas y sprites: FLUX.1 [schnell], Apache 2.0, iteración rápida y calidad lista para publicar
Arte conceptual: SD 3.5 Large con LoRA para controlar el estilo
Recursos 3D: Hunyuan3D 2.1 o TRELLIS.2 para mallas con texturas, SAM 3D cuando partes de una fotografía y después Blender para el retoque final
Rigging automático: UniRig o NVIDIA SOMA-X para crear el esqueleto y asignar pesos a las mallas generadas (ambos son abiertos), en lugar de depender de Mixamo
Efectos de sonido: el modelo abierto Small-SFX de Stable Audio, se ejecuta localmente y tiene licencia comercial
Música: ACE-Step para prototipos y después un compositor para la producción final
Voz: Qwen3-TTS para clonación y diálogos ambientales (Apache 2.0), Chatterbox (MIT) cuando una frase necesite emoción real y actores de voz para las líneas que importan
Diálogos de NPC: Qwen3.6-35B-A3B, Gemma 4 26B-A4B o Muse Glimmer 30B en local, o un LLM en la nube que puedas alojar tú mismo (GLM-5.2, DeepSeek-V4 o Kimi K3) para razonamiento complejo y uso de herramientas
Vídeo (cinemáticas): Mochi 1 o Wan 2.2 5B en local, LTX-2.5 o HunyuanVideo-1.5 en la nube cuando necesites calidad final
La cuestión con todo esto es que el error habitual consiste en intentar usar IA para todo. Son herramientas, no sustitutos. Reducen el trabajo tedioso de las iteraciones, las variaciones y los recursos provisionales, para que puedas dedicar tu tiempo a las decisiones creativas que realmente importan. Las partes que hacen que tu juego sea tuyo.
Una evaluación realista del hardware
Seamos sinceros sobre lo que realmente necesitas para ejecutar todo esto:
8 GB de VRAM (RTX 3060, 4060): SD 1.5/SDXL, Wan 2.1 pequeño, AudioGen, Fish Speech y LLM pequeños (7B cuantizados). Este es el terreno de los portátiles gaming y basta para empezar.
12 GB de VRAM (RTX 3080, 4070): SD 3.5, FLUX schnell, Mochi 1, MusicGen, TripoSR y Qwen 14B cuantizado. Aquí es donde todo empieza a resultar cómodo. La mayoría de los modelos útiles funcionan con esta capacidad.
24 GB de VRAM (RTX 3090, 4090): la mayoría de los modelos a precisión completa, InstantMesh, LLM más grandes y la gama de agentes locales de 2026: Qwen3.6-35B-A3B, Gemma 4 31B a 4 bits y Muse Glimmer 30B a 4 bits. Si te tomas en serio este flujo de trabajo, este es el punto ideal.
48-80 GB de VRAM (A100, H100): HunyuanVideo, LTX-2, DeepSeek-V3 y generación a escala de producción. Hardware empresarial. No vas a comprarlo, sino a alquilarlo.
Las instancias en la nube de RunPod, Lambda Labs o Modal cuestan entre $2 y $4 por hora para las A100. Para un uso ocasional, resulta más barato que comprar hardware. Inicia una instancia cuando necesites calidad final y apágala cuando termines.
Sobre las estimaciones de costes de esta guía: los costes por generación presuponen inferencia autoalojada en GPU en la nube a unos ~$2-3 por hora (A100) o ~$0.40 por hora (RTX 4090). Los costes reales varían según el hardware, la optimización y el tamaño de los lotes. Son cifras aproximadas para planificar, así que tus resultados pueden variar.
Novedades de 2026
Lanzamientos recientes: LTX-2 y LTX-2.3 introdujeron audio y vídeo sincronizados abiertos con 4K nativo. TRELLIS.2 de Microsoft (diciembre de 2025) se convirtió en el referente abierto para convertir imágenes en 3D, y SAM 3D de Meta (noviembre de 2025) hizo viable la reconstrucción 3D a partir de una sola fotografía. FLUX.2 sustituyó a FLUX.1 para la generación de imágenes, y SOMA-X de NVIDIA introdujo rigging y retargeting automáticos abiertos. La primera mitad de 2026 mantuvo el ritmo: Qwen3-TTS (enero) dio a la clonación de voz un verdadero hogar bajo Apache 2.0, GLM-5 de Zhipu (febrero) presentó un modelo abierto de 744B para programación y agentes bajo MIT, Matrix-Game 3.0 de Skywork (marzo) publicó con pesos abiertos un modelo de mundos interactivo en tiempo real, DeepSeek-V4 (abril) llevó los LLM abiertos a un contexto de 1 millón de tokens bajo MIT, Stable Audio 3.0 (mayo) lanzó tres modelos de audio abiertos entrenados con datos licenciados e Ideogram publicó su primer modelo de imágenes con pesos abiertos (junio). Después, en julio, Moonshot anunció Kimi K3, un modelo de pesos abiertos con 2,8T de parámetros, cuyos pesos llegaron el 27 de julio bajo la licencia Kimi K3; ese mismo mes, Tencent pasó el modelo Hy3 de 295B a Apache 2.0, unas semanas después de que Z.ai lanzara GLM-5.2 bajo MIT (17 de junio). Agosto también fue un mes intenso para los modelos abiertos: Alibaba lanzó Qwen3.8 (un modelo insignia 2.4T-A95B y un modelo denso de 27B, Apache 2.0), Meta publicó Muse Glimmer 30B bajo Apache 2.0, MiniMax abrió los pesos de vídeo de H3 33B y Lightricks lanzó LTX-2.5. Anteriormente, Gemma 4 de Google (abril, Apache 2.0) y Mistral Small 4 (marzo, Apache 2.0) habían redefinido la gama para ejecución en dispositivos.
La tendencia que debes vigilar: los principales laboratorios reservan cada vez más sus modelos más recientes para las API, incluso cuando las versiones anteriores eran abiertas. Wan pasó a ser cerrado con la versión 2.5 y ha seguido así hasta la 3.0 (agosto de 2026), Qwen-Image se cerró con la versión 2.0 y Hunyuan3D con la 2.5. Muse Spark, el sucesor de Llama de Meta, se lanzó como modelo cerrado en abril de 2026 antes de que el Muse Glimmer más pequeño volviera a ser abierto en agosto; Black Forest Labs está distribuyendo FLUX 3 primero mediante su API y ha prometido un FLUX 3 Dev abierto para más adelante en 2026, mientras que Skywork anunció SkyReels V4 en febrero sin publicar los pesos. El ecosistema abierto sigue siendo dinámico y avanza con rapidez, pero ya no es seguro asumir que "la versión más reciente es abierta", así que comprueba la disponibilidad de los pesos antes de construir un flujo de trabajo en torno a un modelo.
La trayectoria está clara: todas las capacidades presentes en los modelos cerrados aparecen en modelos abiertos entre 6 y 12 meses después. La pregunta no es si los modelos abiertos llegarán a ser lo bastante buenos. Ya lo son para la mayoría de los usos. La pregunta es con qué rapidez se convertirán en la opción predeterminada.
Y esto es lo que significa para los creadores: las herramientas que antes exigían presupuestos empresariales o suscripciones mensuales se están convirtiendo en algo que simplemente puedes... ejecutar. En tu propio hardware. Sin necesitar el permiso de nadie.
Ese es el cambio. Hacia eso estamos construyendo.
Preguntas frecuentes
¿Cuál es el mejor modelo de IA de código abierto para generar recursos de juegos?
Depende del recurso. Para modelos 3D, Hunyuan3D es la opción abierta más potente en 2026. Para arte 2D y texturas, FLUX lidera en calidad. Para efectos de sonido y música, los modelos de audio abiertos han avanzado rápidamente hasta ponerse al día. No existe un único modelo "mejor" porque los juegos necesitan muchos tipos de recursos, así que la mayoría de los creadores encadenan varios en lugar de depender de uno solo.
¿Son los modelos de IA de código abierto lo bastante buenos como para sustituir a las API cerradas?
Para la mayor parte del trabajo con recursos de juegos en 2026, sí. Los modelos abiertos ya igualan a las API cerradas en generación de imágenes, 3D y audio, y puedes ejecutarlos en tu propio hardware sin tarifas por llamada ni cambios inesperados de precios. Los modelos cerrados todavía lideran en algunas tareas de vanguardia, como los vídeos largos, pero la diferencia suele desaparecer en un plazo de entre 6 y 12 meses.
¿Puedo ejecutar estos modelos de IA generativa en mi propia GPU?
Muchos de ellos, sí. Los modelos de imagen y audio funcionan cómodamente en una sola GPU de consumo como la RTX 4090. Los modelos de vídeo y 3D más grandes necesitan más VRAM y, con frecuencia, una GPU en la nube de la categoría de la A100. La sección anterior sobre hardware indica qué necesita cada modelo para que puedas planificar antes de comprometerte.
¿Cuál es el mejor modelo de frontera de código abierto en 2026?
En septiembre de 2026, la frontera abierta es una carrera entre cuatro competidores, y la respuesta depende de lo que puedas ejecutar. Kimi K3 (MoE de 2,8T) es el más grande y el que obtiene resultados más cercanos a los líderes cerrados, pero su licencia Kimi K3 añade condiciones para las grandes empresas que ofrecen modelos como servicio. DeepSeek-V4-Pro (1,6T, 49B activos) y Qwen3.8-2.4T-A95B tienen las licencias más claras a esa escala: MIT y Apache 2.0, respectivamente. GLM-5.2 (753B, MIT) es el especialista en programación y agentes. Ninguno cabe en una sola GPU, así que, para cualquier modelo que alojes por tu cuenta, el «mejor» está realmente un nivel por debajo: Qwen3.6-35B-A3B, Gemma 4 31B o Muse Glimmer 30B.
¿Cuáles son los mejores modelos de frontera abiertos y cerrados para generar imágenes?
Abiertos: FLUX.2 [klein] 4B (Apache 2.0, menos de un segundo) para crear arte de juegos con garantías de uso comercial, Qwen-Image-2512 (Apache 2.0) cuando necesites texto legible, y FLUX.2 [dev] o Chroma1-HD para obtener la máxima calidad si la licencia encaja con tu proyecto. Cerrados: FLUX.2 [pro] y Qwen-Image-2.0, disponible únicamente mediante API, además de novedades de 2026 como Kling IMAGE 3.0 (hasta 10 imágenes de referencia según la guía de Kling) y Grok Imagine Image 2.0 de xAI. Por ahora, el modelo de imágenes de FLUX 3 solo está disponible mediante la API de BFL, aunque se ha prometido una versión Dev abierta para más adelante en 2026. Para crear juegos, el nivel abierto ya es lo bastante bueno, por lo que los modelos cerrados aportan principalmente comodidad.
¿Qué modelos de vídeo con pesos abiertos permiten una implementación comercial completa y bajo qué licencia?
Si necesitas un modelo de vídeo abierto que puedas implementar comercialmente a escala empresarial sin límite de ingresos, las opciones seguras son Wan 2.2 (Apache 2.0, incluidas las variantes MoE de 5B y 14B), Mochi 1 (Apache 2.0), Step-Video-T2V (MIT) y CogVideoX 2B (Apache 2.0). LTX-2 y LTX-2.5 pueden utilizarse comercialmente de forma gratuita con ingresos anuales inferiores a $10M y exigen un acuerdo de pago por encima de esa cifra, que es la vía de «comprar acceso» que Lightricks ofrece realmente. MiniMax H3 es abierto bajo la licencia comunitaria MiniMax H3, pero pide a los usuarios de EE. UU., la UE, el Reino Unido y Corea del Sur que presenten primero una solicitud; HunyuanVideo, por su parte, utiliza la licencia comunitaria de Tencent con exclusiones regionales, así que lee ambas antes de comprometerte. Wan 2.5 a 3.0, Veo, Kling y Seedance no tienen pesos públicos. Nuestra guía de modelos de vídeo con referencias compara las opciones alojadas.
¿Qué IA generativa debería utilizar para recursos y entornos de juegos en 2026?
Encadena varios modelos especializados en lugar de buscar uno que lo haga todo. Para objetos y personajes, procesa un concepto de FLUX.2 klein o Qwen-Image con Hunyuan3D 2.1 o TRELLIS.2 y crea el rig con UniRig. Para los entornos, genera un skybox o HDRI (nuestro generador de skyboxes lo hace en el navegador), crea el terreno mediante procedimientos o con una pasada de difusión como se explica en nuestra guía de generación de terrenos, y genera las texturas con un modelo de imágenes y un extractor PBR, como describimos en nuestra guía de generadores de texturas con IA. El audio puede generarse con Stable Audio 3.0 Small-SFX y ACE-Step, y las voces con Qwen3-TTS o Chatterbox. En septiembre de 2026, todos los modelos de esa cadena son abiertos y permiten el uso comercial.
¿Cuál es el mejor LLM para ejecutar localmente en 2026?
Elige primero según la VRAM. Con 8 GB, Qwen3.5-4B o Gemma 4 E4B. Con 16 GB, gpt-oss-20b (Apache 2.0, diseñado para 16 GB) o Gemma 4 12B. Con 24 GB, Qwen3.6-35B-A3B es el modelo polivalente que debería ejecutar la mayoría de la gente, mientras que Muse Glimmer 30B cuantizado a 4 bits es adecuado para tareas agénticas con visión y Gemma 4 31B cuantizado cuando quieras el modelo denso más potente. Por encima de eso, DeepSeek-V4-Flash (284B, 13B activos) es la opción más pequeña para obtener un contexto de 1M de tokens en una estación de trabajo. Todos usan Apache 2.0 o MIT, y Ollama o LM Studio permiten ejecutar cualquiera de ellos con un solo comando.
¿Es legal utilizar recursos generados por IA en un juego comercial?
Por lo general, sí, en el caso de modelos de código abierto que ejecutes por tu cuenta, pero depende de la licencia del modelo y de tus supuestos sobre los datos de entrenamiento. Comprueba siempre la licencia específica del modelo e informa del contenido generado por IA cuando tu plataforma lo exija. Consulta nuestra política de contenido generado por IA para saber cómo lo gestionamos.
Más lecturas
- Controversia sobre la IA, confianza y economía pos-IA: nuestra postura sobre la IA en los juegos
- Política de contenido generado por IA: cómo gestionamos la divulgación del uso de IA
- Mejores modelos de vídeo con IA compatibles con imágenes de referencia: comparación de los modelos de vídeo alojados
- Mejores generadores de modelos 3D con IA: Meshy, Tripo y Rodin alojados frente a los modelos abiertos
- Stack tecnológico para juegos web en 2026: WebGL, WebGPU y Wasm para juegos
- Tecnología para mundos abiertos 3D en el navegador: cómo utilizar recursos 3D generados por IA en mundos para navegador
- Generación de paisajes para mundos abiertos en el navegador: síntesis de terrenos basada en difusión
- Dónde encontrar recursos gratuitos para juegos: fuentes tradicionales de recursos junto con la generación mediante IA
- Herramientas agénticas de IA para programar: IA para escribir código de juegos, no solo para generar recursos
Los modelos generativos son más divertidos cuando el resultado se puede jugar.