Beste Open-Source-Modelle für generative KI in Spielen (2026)
Zuletzt aktualisiert: September 2026.
Das ist der entscheidende Punkt bei generativer KI: Jahrelang waren die besten Modelle nur hinter API-Schlüsseln und unvorhersehbaren Preismodellen verfügbar. Man baute seinen Workflow rund um ein Tool auf, gewöhnte sich daran und wachte dann eines Morgens mit einer E-Mail auf, die eine Preisänderung ankündigte. Oder schlimmer noch: Das Unternehmen änderte seine Ausrichtung vollständig.
Das änderte sich Ende 2024. Tencent, Alibaba und DeepSeek begannen, Modelle zu veröffentlichen, die man tatsächlich herunterladen kann. Modelle, die mit den geschlossenen Alternativen mithalten. Und plötzlich haben Kreative Optionen, die nicht vom Geschäftsmodell eines anderen Unternehmens abhängen.
Was wäre, wenn du Videos, 3D-Assets, Musik und Stimmen vollständig mit Modellen erzeugen könntest, die du selbst kontrollierst? Genau da stehen wir heute. Dieser Leitfaden zeigt, was tatsächlich existiert, was funktioniert und was du schon heute einsetzen kannst.
Videogenerierung
Jahrelang bedeutete Videogenerierung Runway oder Pika: geschlossene Plattformen, Abogebühren und Einschränkungen bei der Nutzung der Ergebnisse. Heute kannst du vergleichbare Modelle auf deiner eigenen Hardware ausführen.
Text-zu-Video-Generierung mit HunyuanVideo, 720p-Ausgabe des führenden Open-Source-Videomodells
| Modell | Organisation | Parameter | Spezifikationen | Hardware | Kosten |
|---|---|---|---|---|---|
| HunyuanVideo | Tencent | 13B | 720p, Text+Bild | 80GB | ~$0.20 |
| HunyuanVideo-1.5 | Tencent | 8.3B | 480p-1080p, Text+Bild | 14GB | ~$0.05 |
| Mochi 1 | Genmo | 10B | 480p@30fps | 12GB+ | ~$0.10 |
| LTX-Video | Lightricks | — | 768x512, Echtzeit | 12GB | ~$0.02 |
| LTX-2 / LTX-2.5 | Lightricks | 19B (2) / 22B (2.5) | 4K, synchronisiertes Audio, mehrere Einstellungen in 2.5 | High-End | ~$0.30 |
| Wan 2.1 | Alibaba | 1.3-14B | 480p-720p | 8GB+ | ~$0.03 |
| Wan 2.2 | Alibaba | 27B MoE (14B aktiv) | 720p, MoE | 8GB+ | ~$0.03 |
| CogVideoX1.5-5B | Tsinghua | 5B | 1360x768@16fps, bis zu 10s | 12GB | ~$0.04 |
| SkyReels-V3 | Skywork | 14-19B | Audiogesteuert, Referenz-zu-Video, V2V | High-End | ~$0.10 |
| MiniMax H3 | MiniMax | 33B | 2K, 4-15s, Stereo-Audio, bis zu 9 Referenzbilder | High-End | nicht getestet |
| Step-Video-T2V | StepFun | 30B | Größtes offenes T2V-Modell, 204 Frames | High-End | ~$0.15 |
| Open-Sora 2.0 | HPC-AI | 11B | Flux-Integration | High-End | ~$0.20 |
Gewichte: HunyuanVideo ↗ · Mochi 1 ↗ · Wan 2.1 ↗ · Open-Sora ↗
Beispiele ansehen: HunyuanVideo-Galerie ↗ · Mochi-Beispiele ↗ · CogVideoX-Beispiele ↗
Was das für Kreative bedeutet
HunyuanVideo übertrifft Runway Gen-3 in professionellen Bewertungen und ist vollständig offen. Der Haken? Du brauchst leistungsstarke Hardware: eine A100 oder H100 mit 80GB VRAM. Für die meisten von uns bedeutet das, bei Bedarf Cloud-GPUs zu mieten.
HunyuanVideo-1.5 hat die Hardware-Rechnung verändert. Tencent veröffentlichte es im November 2025 als offenes Modell mit 8.3B Parametern, das auf einer Consumer-GPU mit 14GB läuft und Text-zu-Video sowie Bild-zu-Video in 480p/720p mit optionaler Hochskalierung auf 1080p unterstützt. Ein neuer Mechanismus namens Selective and Sliding Tile Attention (SSTA) sorgt für eine ungefähr doppelt so hohe Inferenzgeschwindigkeit wie beim ursprünglichen HunyuanVideo. Wenn du die Qualität von HunyuanVideo wolltest, aber keine Grafikkarte mit 80GB rechtfertigen konntest, ist dies die Version, die du tatsächlich zu Hause ausführen kannst.
Mochi 1 kannst du wirklich selbst ausführen. Eine GPU mit 12GB – also etwa eine RTX 3060 – bewältigt das Modell problemlos. Die Ausgabe ist ausgesprochen kreativ und besitzt eine unverwechselbare künstlerische Qualität. Sie erreicht nicht ganz die Detailtreue von HunyuanVideo, aber dafür kontrollierst du den gesamten Prozess.
LTX-2 wird für Spiele besonders interessant. Es ist das erste offene Modell, das synchronisiertes Audio zusammen mit dem Video erzeugt. Stell dir Zwischensequenzen vor, bei denen der Ton einfach ... passt. Keine nachträgliche Synchronisation. Lightricks veröffentlichte im Januar 2026 die vollständigen Gewichte sowie den Inferenz- und Trainingscode als Open Source. Das Modell bietet native 4K-Ausgabe mit bis zu 50fps und bis zu 20 Sekunden synchronisiertes Audio. Eine Einschränkung der Lizenz: Die offenen Gewichte von LTX-2 sind für akademische Zwecke kostenlos, kommerziell jedoch nur für Unternehmen mit einem Jahresumsatz von weniger als $10M. Prüfe diese Grenze also, bevor du dein Geschäft darauf aufbaust. Der aktuelle Checkpoint vom September 2026 ist LTX-2.5, ein 22B-Modell mit nativer Generierung mehrerer Einstellungen – also mehreren zusammenhängenden Aufnahmen mit derselben Figur und demselben Look –, einem Diffusions-Videodecoder anstelle einer einfachen VAE-Rekonstruktion und einem Gemma 4 12B-Textencoder für längere Prompts. All das steht weiterhin unter der LTX-2.x Community License mit derselben Umsatzgrenze von $10M und einer kostenpflichtigen Vereinbarung für Unternehmen oberhalb dieser Grenze.
SkyReels-V3 (Skywork, Januar 2026) ist die bemerkenswerte neuere offene Modellreihe. Es handelt sich um ein einheitliches multimodales Modell für audiogesteuerte Videos, Referenz-zu-Video und Video-zu-Video in Varianten mit 14B und 19B. Damit ist es besonders stark, wenn eine Figur oder ein Referenzbild die Aufnahme bestimmen soll. Step-Video-T2V (StepFun) ist mit 30B das größte offene Text-zu-Video-Modell und wird unter einer klaren MIT-Lizenz veröffentlicht. Es ist einen Blick wert, wenn dir eine freizügige Lizenz wichtiger ist als die Ausführung auf einer kleinen GPU.
MiniMax H3 (Hailuo 3.0) ist der neueste offene Neuzugang und besonders für referenzgesteuerte Zwischensequenzen interessant. MiniMax startete es am 31. Juli 2026 als API und veröffentlichte die 33B-Basisgewichte im August auf Hugging Face. Es gibt zwei Checkpoints: FL2VA für die Generierung anhand des ersten und letzten Frames sowie Ref2VA, das bis zu 9 Referenzbilder, 3 Referenzvideoclips und 3 Audioclips – insgesamt 12 Dateien – verarbeitet und 4 bis 15 Sekunden lange Videos mit bis zu 2K und nativem Stereo-Audio erzeugt. Es gilt die MiniMax H3 Community License. Laut Model Card müssen Nutzer in den USA, der EU, dem Vereinigten Königreich und Südkorea zunächst ein Antragsformular einreichen. Das Modell ist daher nicht für jedes Studio sofort einsatzbereit.
Wan 2.1 läuft auf einem Gaming-Laptop. Für die kleineren Varianten reicht eine GPU mit 8GB. Wenn du schon immer einen Prototyp mit Videogenerierung erstellen wolltest, aber die nötige Hardware nicht rechtfertigen konntest, ist das dein Einstieg.
Wan 2.2 (Alibaba, Juli 2025) ist das erste Open-Source-Videomodell auf Basis einer Mixture-of-Experts-Architektur: insgesamt 27B Parameter, von denen pro Schritt nur 14B aktiv sind. Es ist als Text-zu-Video-Modell (T2V-A14B), Bild-zu-Video-Modell (I2V-A14B) und als hybride 5B-Variante für Consumer-GPUs erhältlich. Alle Varianten stehen für die kommerzielle Nutzung unter Apache 2.0.
Eine wichtige Einschränkung: Wan 2.2 ist weiterhin das letzte offene Wan-Modell. Die neueren Versionen Wan 2.5 (September 2025), 2.6 (Dezember 2025), 2.7 (April 2026) und inzwischen Wan 3.0 (August 2026, mit bis zu 30 Sekunden langen One-Take-Clips in bis zu 1080p und Referenzeingaben, laut Alibaba Cloud Model Studio) ergänzten synchronisiertes Audio, 1080p und eine feinere Frame-Steuerung, sind jedoch nur per API verfügbar und besitzen keine öffentlichen Gewichte. Die Wan-AI-Organisation auf Hugging Face endet im September 2026 weiterhin bei Version 2.2, ganz gleich, was Affiliate-Websites behaupten. Wenn Self-Hosting für dich wichtig ist, bildet 2.2 die Obergrenze. Wenn du 4K und synchronisiertes Audio brauchst, solltest du zum offenen Modell LTX-2.5 greifen.
Der sinnvolle Workflow: Mochi 1 oder Wan 2.1 für lokale Prototypen. HunyuanVideo-1.5 oder LTX-2.5 auf Cloud-GPUs, wenn du finale Qualität brauchst.
Bildgenerierung
Hier hat Open Source bereits gewonnen. Die Modelle, die du heute herunterladen kannst, können tatsächlich mit Midjourney konkurrieren. Nicht „fast genauso gut“, sondern wirklich konkurrenzfähig.
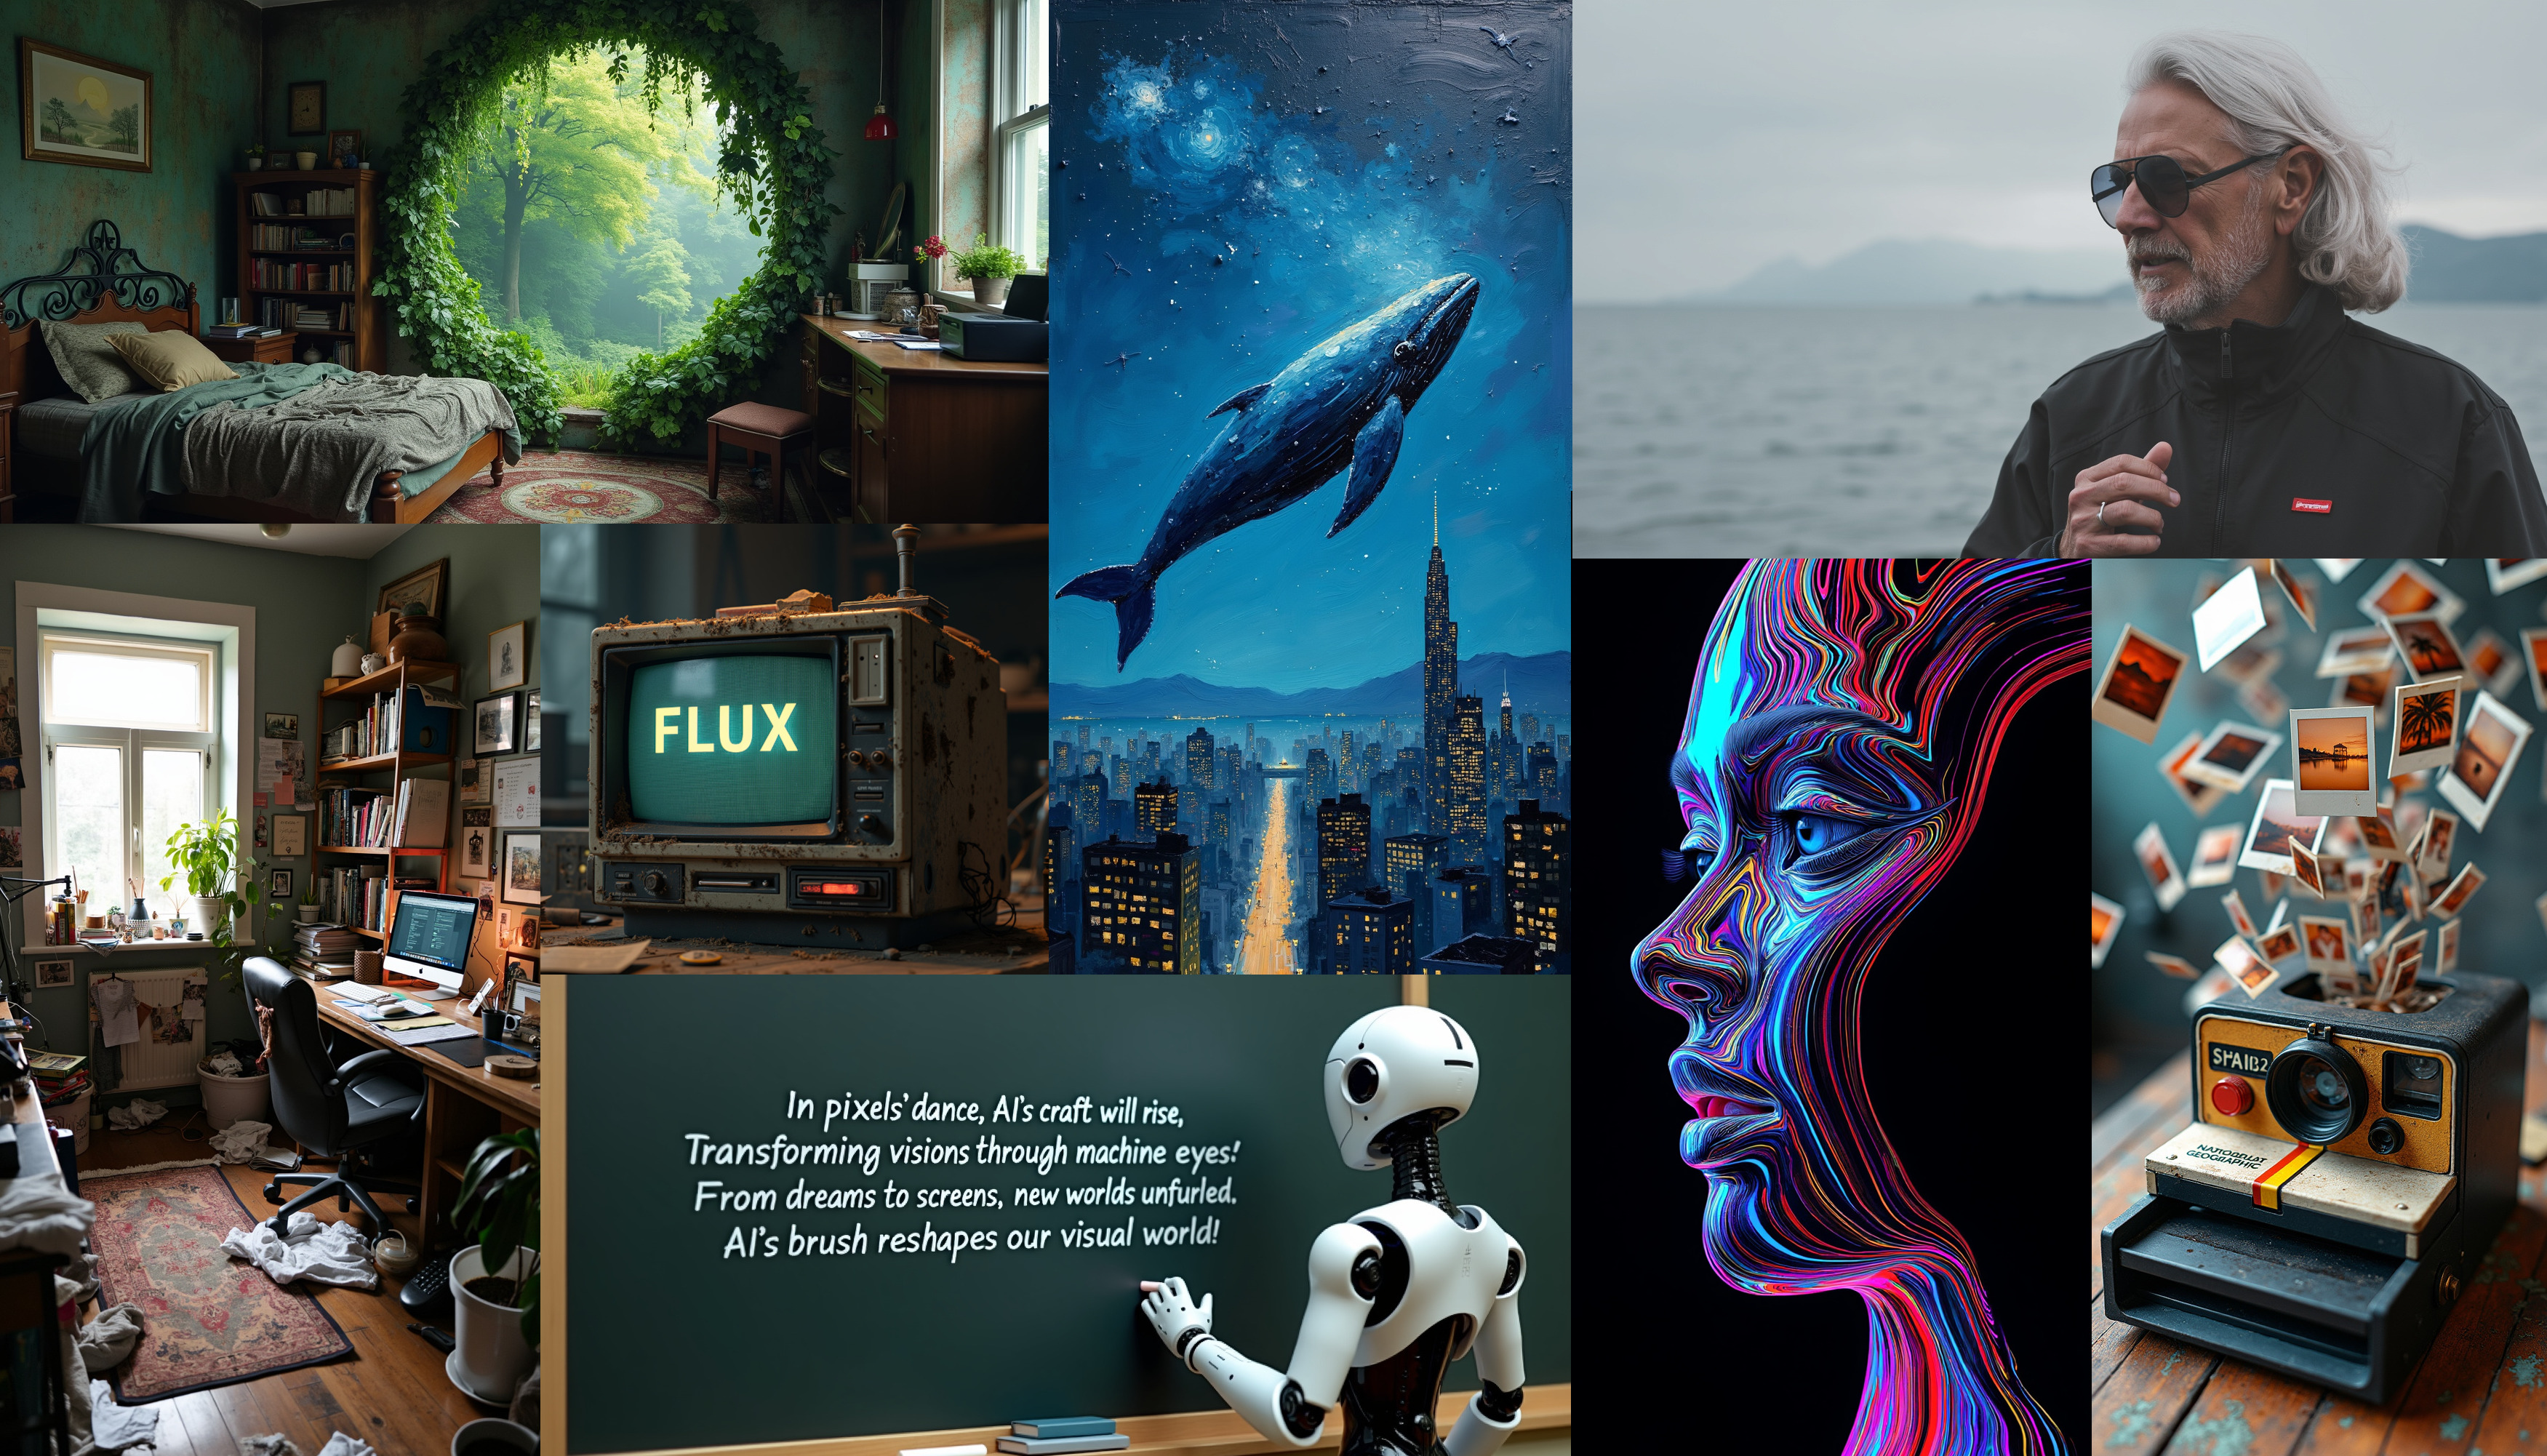 FLUX.1-Beispiele, fotorealistische Qualität aus einem unter Apache 2.0 lizenzierten Modell
| Modell | Organisation | Veröffentlicht | Parameter | Hauptmerkmal | Lizenz | Kosten/Bild |
|---|---|---|---|---|---|---|
| FLUX.1 [schnell] | Black Forest Labs | Aug. 2024 | 12B | Generierung in 4 Schritten, schnell | Apache 2.0 | ~$0.001 |
| FLUX.1 [dev] | Black Forest Labs | Aug. 2024 | 12B | Qualität nahe an Pro | Nicht kommerziell | ~$0.002 |
| SD 3.5 Large | Stability AI | Okt. 2024 | 8B | Textdarstellung, vielfältige Stile | Stability-Lizenz | ~$0.002 |
| SD 3.5 Large Turbo | Stability AI | Okt. 2024 | 8B | 4 Schritte, schnell | Stability-Lizenz | ~$0.001 |
| HiDream-I1 | HiDream.ai | Apr. 2025 | 17B | Hohe Qualität, Varianten Full/Dev/Fast | MIT | ~$0.002 |
| CogView4 | Tsinghua / Zhipu | März 2025 | 6B | Native chinesische Texte, bis zu 2048px | Apache 2.0 | ~$0.002 |
| Qwen-Image | Alibaba | Aug. 2025 | 20B | Führende Textdarstellung, Bildbearbeitung | Apache 2.0 | ~$0.002 |
| FLUX.2 | Black Forest Labs | Nov. 2025 | 32B | Text+Bearbeitung, 4MP, mehrere Referenzen | dev: Nicht kommerziell / klein 4B: Apache 2.0 | ~$0.003 |
| Ideogram 4.0 | Ideogram | Juni 2026 | 9.3B | Designarbeiten, Textdarstellung, JSON-Layoutsteuerung | Nicht kommerziell | ~$0.002 |
Direkt ausprobieren: FLUX.1-schnell-Demo ↗ · SD-3.5-Large-Demo ↗ · GitHub (FLUX) ↗
Beispiele ansehen: FLUX-Galerie ↗ · FLUX-LoRA-Galerie ↗ · Replicate-Beispiele ↗
Zur Erstellung von Spiel-Assets
FLUX.1 [schnell] ist das wichtigste Modell in dieser Kategorie. Die Apache-2.0-Lizenz bedeutet, dass du kommerzielle Spiele veröffentlichen kannst, ohne dir über Lizenzprobleme Gedanken machen zu müssen. Es generiert Bilder in nur 4 Schritten, sodass du schnell iterieren kannst: Beschreibe, was du möchtest, sieh dir das Ergebnis an, passe den Prompt an und wiederhole den Vorgang.
SD 3.5 Large kann Text endlich korrekt darstellen. Frühere Versionen verstümmelten praktisch jeden Text, den man einfügen wollte. Das ist wichtig für UI-Mockups, Beschilderungen im Spiel, Titelbildschirme und alle anderen Bilder, in denen lesbare Wörter benötigt werden.
FLUX.2 (Black Forest Labs, November 2025) ist der größere Nachfolger: ein 32B-Modell, das Text-zu-Bild und Bildbearbeitung in einem einzigen Checkpoint vereint. Es bietet eine starke Konsistenz von Figuren und Stilen über mehrere Referenzen hinweg und zuverlässige Textdarstellung bei bis zu 4 Megapixeln. FLUX.2 [dev] mit offenen Gewichten verwendet eine nicht kommerzielle Lizenz. Das größendestillierte FLUX.2 [klein] (Januar 2026) stellt seine 4B-Version dagegen unter Apache 2.0 bereit, generiert Bilder in weniger als einer Sekunde und benötigt ungefähr 8GB VRAM. Damit gibt es weiterhin eine kommerziell sichere Option für die Veröffentlichung von Spielgrafiken. Nimm ausdrücklich die 4B-Version von klein: Die größere 9B-Version von klein bleibt unter der nicht kommerziellen FLUX-Lizenz. Quantisierte Pipelines reduzieren den Hardwarebedarf von [dev] auf GPUs mit 18-24GB. Die nächste Generation von Black Forest Labs, FLUX 3, ist ein gemeinsames Bild-, Video- und Audiomodell, das am 23. Juli 2026 angekündigt wurde. Im September 2026 ist es nur per API verfügbar: Video mit synchronisiertem Audio ging am 4. August als Vorschau online, während FLUX 3 Dev mit offenen Gewichten laut den BFL-Versionshinweisen „für später im Jahr 2026 geplant“ ist. Bis es erscheint, bleibt klein 4B die kommerziell sichere FLUX-Variante.
Zwei weitere offene Optionen solltest du kennen. Chroma1-HD (8.9B, Apache 2.0) ist ein vollständig offener Ableger von FLUX.1-schnell und damit eine kommerziell sichere Möglichkeit, Qualität aus der FLUX-Familie ohne die [dev]-Lizenz zu erhalten. OmniGen2 (Apache 2.0) ist ein einheitliches Modell, das Text-zu-Bild und anweisungsbasierte Bearbeitung an einem Ort vereint. Damit ist es der schnellste Weg, wenn du ein bestehendes Asset überarbeitest („Lass das Schwert blau leuchten“), statt es von Grund auf neu zu generieren.
Qwen-Image (Alibaba, August 2025) ist das offene Modell der Wahl, wenn deine Grafik lesbaren Text enthalten soll, etwa auf Schildern, Benutzeroberflächen, Postern oder Gegenstandsbeschriftungen. Es ist ein 20B-Modell unter Apache 2.0 mit führender Textdarstellung und einer leistungsfähigen Variante für anweisungsbasierte Bildbearbeitung. Damit ist es kommerziell sicher und ungewöhnlich gut in genau dem Bereich, an dem die meisten Bildmodelle noch scheitern. Die Aktualisierung vom Dezember 2025, Qwen-Image-2512, verbesserte den Realismus von Menschen und das Textlayout und behielt die Apache-2.0-Lizenz bei. Wenn du das Modell selbst hostest, solltest du daher diesen Checkpoint verwenden. Das neuere Qwen-Image-2.0 (Februar 2026) ist nur per API verfügbar. Im September 2026 führt das QwenLM-Repository Qwen-Image-2512 und Qwen-Image-Edit-2511 weiterhin als die neuesten Checkpoints mit öffentlichen Gewichten auf. Ideogram 4.0 (Juni 2026) ist Ideograms erste Veröffentlichung mit offenen Gewichten: ein Diffusion Transformer mit 9,3 Milliarden Parametern, der für Designarbeiten entwickelt wurde und eine starke mehrsprachige Textdarstellung sowie eine explizite Layout- und Farbsteuerung über strukturierte JSON-Prompts bietet. Einen Haken gibt es, bevor du darauf aufbaust: Der Inferenzcode steht unter Apache 2.0, die Gewichte jedoch unter einer nicht kommerziellen Lizenz. Damit ist es ein Werkzeug für Forschung und Prototyping, sofern du keine kommerzielle Lizenz kaufst.
Das Ökosystem rund um Stable Diffusion ist nach wie vor unerreicht. ControlNet für präzise Kompositionen. Inpainting für Korrekturen. LoRA-Fine-Tuning für individuelle Stile. FLUX holt auf, aber wenn du heute tiefgreifende Anpassungen brauchst, bietet dir das ausgereifte Tooling von SD mehr Möglichkeiten.
So würde ich es betrachten: Für Texturen und Sprites funktionieren beide. Für Concept Art mit konkreten Stilanforderungen eignet sich SD 3.5 mit LoRAs. Für höchste Qualität bei kommerziellen Veröffentlichungen: FLUX schnell.
3D-Generierung
Wenn du schon einmal acht Stunden damit verbracht hast, ein Requisit zu modellieren, das in deinem Spiel drei Sekunden lang auftaucht, ist dieser Abschnitt für dich. Die 3D-Generierung hat sich schon vor einiger Zeit von „interessanter Forschung“ zu einem echten Produktionswerkzeug entwickelt, und 2026 sind die offenen Modelle wirklich gut. Du kannst in weniger als einer Minute von einer Skizze zu einem texturierten Mesh gelangen.
Diese Seite behandelt offene Modelle, die du selbst hosten kannst. Wenn du eher ein Tool als ein Modell auswählst, vergleicht unser Leitfaden zu den besten KI-3D-Modellgeneratoren die gehosteten Optionen (Meshy, Tripo, Rodin, Hi3D) mit den offenen Alternativen – einschließlich Preisen und kommerziellen Nutzungsrechten.
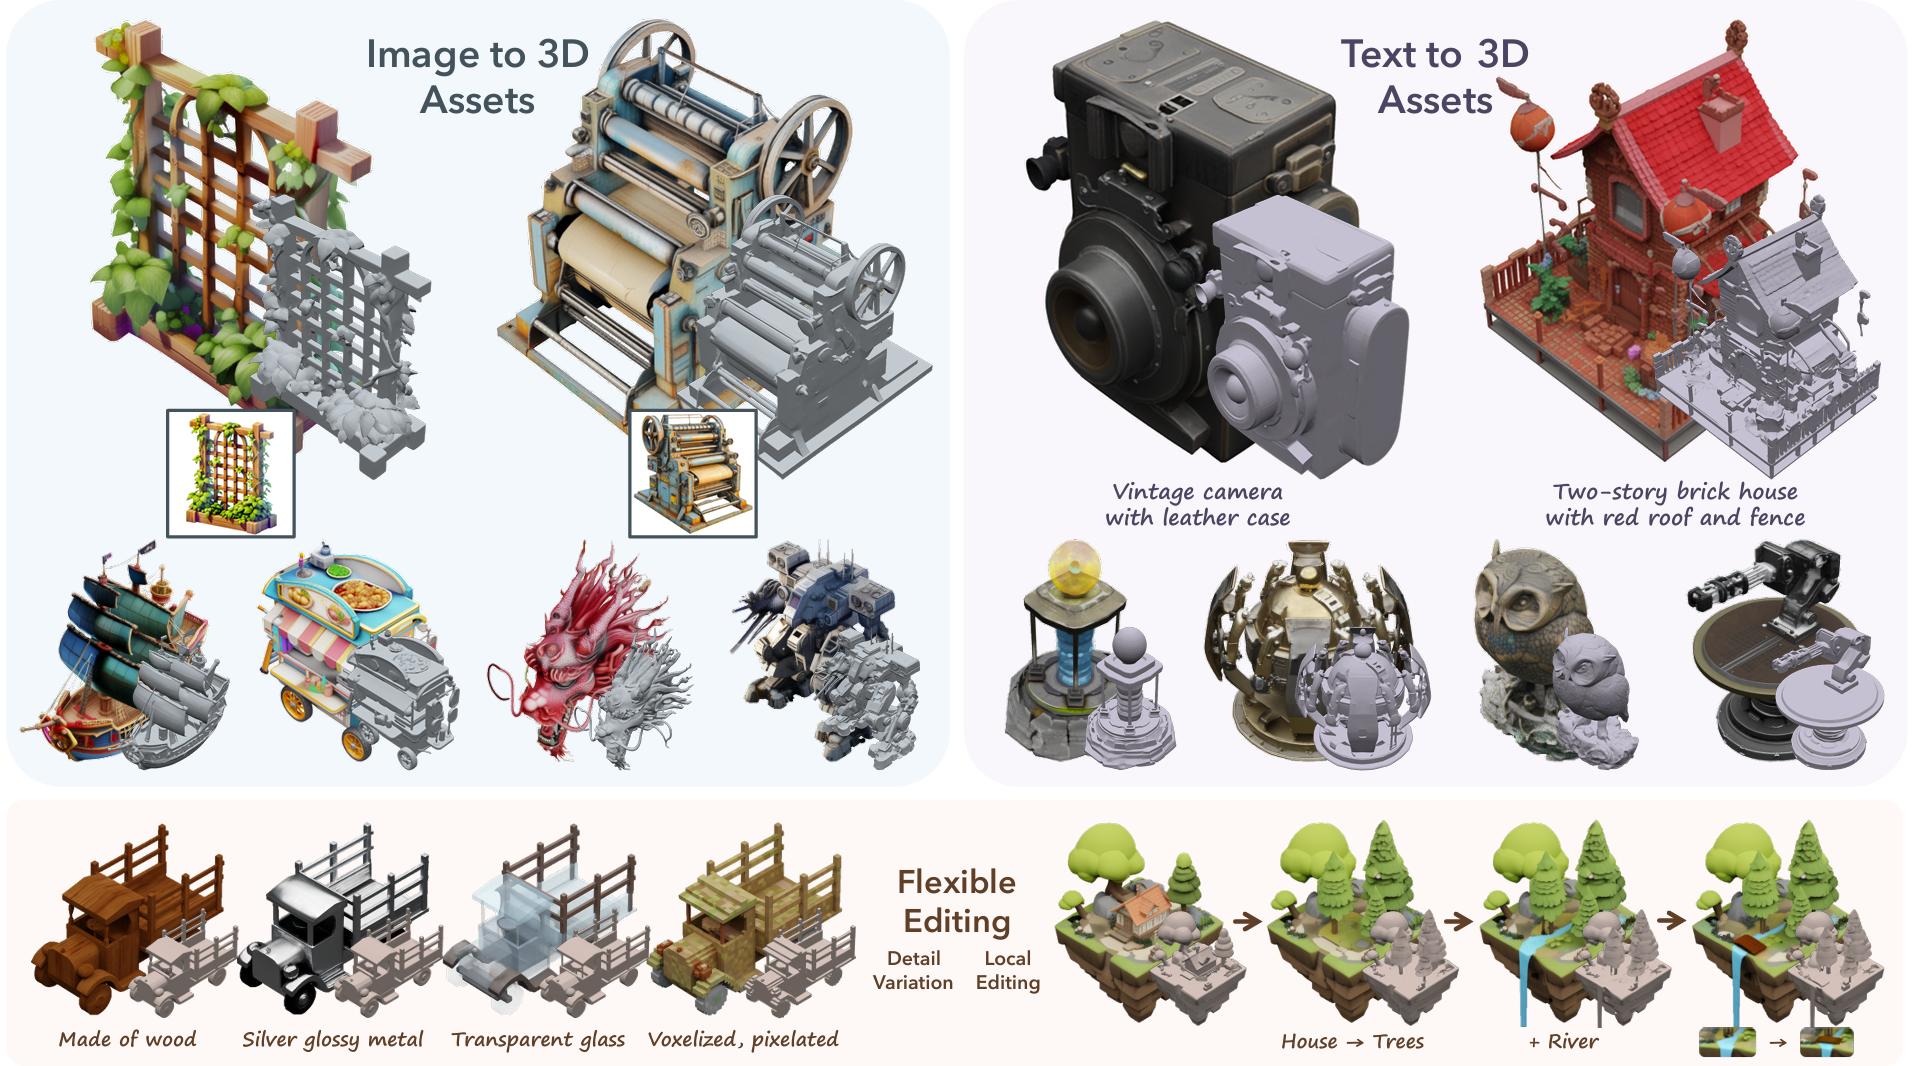 TRELLIS erzeugt aus einzelnen Bildern texturierte 3D-Meshes mit PBR-Materialien
| Modell | Organisation | Veröffentlicht | Hauptmerkmal | Ausgabe | Kosten/Mesh |
|---|---|---|---|---|---|
| TRELLIS.2-4B | Microsoft | Dez. 2025 | 4 Mrd. Parameter, natives PBR, bis zu 1536³ | Texturiertes Mesh mit Normalen | ~$0.03 |
| Hunyuan3D 2.1 | Tencent | Juni 2025 | Produktionsreifes PBR, vollständige Gewichte + Trainingscode | Hochauflösendes texturiertes Mesh | ~$0.05 |
| SAM 3D | Meta | Nov. 2025 | Einzelbild zu 3D (Objekte + menschlicher Körper) | Mesh aus einem Foto | ~$0.02 |
| Stable Fast 3D | Stability AI | Aug. 2024 | Einzelbild → Mesh in ~0,5 s | Schnell erzeugtes texturiertes Mesh | ~$0.001 |
| TripoSG | VAST-AI | März 2025 | Rectified-Flow-Formgenerierung mit 1,5 Mrd. Parametern | Hochwertiges Mesh | ~$0.01 |
| TripoSR | Stability / Tripo | 2024 | Schnelle Rekonstruktion aus einem Einzelbild | Mesh (ohne Textur) | ~$0.001 |
| UniRig | Tsinghua / Tripo | 2025 | Auto-Rigging: Skelett + Skinning-Gewichte | Geriggtes, animierbares Mesh | ~$0.01 |
Direkt ausprobieren: TRELLIS.2-Demo ↗ · Hunyuan3D-Demo ↗ · InstantMesh-Demo ↗
Beispiele ansehen: TRELLIS.2-Projektseite ↗ · Galerie von 3D AI Studio ↗
Ein Workflow, der tatsächlich funktioniert
Der Ansatz, der bei Kreativen derzeit funktioniert, verkettet mehrere Modelle miteinander. Beginne mit einem Bild – ob generiert oder fotografiert, spielt keine Rolle. Verarbeite es mit Stable Zero123 oder Wonder3D, um mehrere Ansichten zu erhalten. Übergib diese Ansichten für das Mesh an InstantMesh oder TripoSR. Nutze anschließend TRELLIS.2 oder Hunyuan3D für richtige Materialien.
TRELLIS.2 von Microsoft ist der neue Spitzenreiter für produktionsreife Assets. Es bewältigt Geometrien, an denen andere Modelle scheitern: dünne Flächen, Löcher und komplexe Topologien. Die Version mit 4 Milliarden Parametern gibt Meshes mit echten PBR-Texturen aus und nicht nur Vertex-Farben, die Materialien imitieren.
Bei Stable Fast 3D geht es vor allem um Geschwindigkeit. Vom Bild zum Mesh dauert es ungefähr eine halbe Sekunde. Das Mesh muss noch bereinigt und texturiert werden, aber fürs Prototyping? Um herauszufinden, ob eine Idee funktioniert, bevor du Stunden investierst? Unschlagbar. TripoSG ist die nächste Stufe, wenn du aus einem einzelnen Bild sauberere Geometrie erzeugen möchtest.
Hunyuan3D 2.1 ist das offene Tencent-Modell der Wahl: Es wird mit vollständigen Gewichten und Trainingscode sowie produktionsreifer PBR-Texturierung ausgeliefert. Achte auf die Namensgebung, denn sie sorgt häufig für Verwirrung. Hunyuan3D 2.5, 3.0 und 3.1 existieren zwar, sind aber ausschließlich per API und ohne öffentliche Gewichte verfügbar. Für Self-Hosting bleibt der Basisgenerator daher bei Version 2.1 stehen. Ein GitHub-Thread, in dem Tencent nach einer Open-Source-Veröffentlichung von 2.5 gefragt wird, war im September 2026 noch unbeantwortet. Wenn du es lieber ausprobieren als selbst hosten möchtest, läuft unser 3D-Generator mit Hunyuan3D direkt im Browser. Tencent hat zudem zwei nützliche Erweiterungen auf Basis von 2.1 geöffnet: Hunyuan3D-Omni ergänzt die Steuerung über mehrere Bedingungen (Punktwolke, Voxel, Skelett, Begrenzungsrahmen), und Hunyuan3D-Part zerlegt ein Mesh in bearbeitbare Teile. Die Lizenz schließt außerdem die EU, das Vereinigte Königreich und Südkorea aus. Prüfe daher die Bedingungen, bevor du dein Spiel in diesen Regionen veröffentlichst.
SAM 3D (Meta, November 2025) bietet den neuesten Einstieg: Ein einzelnes Foto wird zu einem 3D-Mesh, wobei separate Modelle für Objekte und menschliche Körper verfügbar sind. In Kombination mit Metas Segmentierungsarbeit kannst du ein Objekt in einem Bild isolieren und ausschließlich dieses Objekt rekonstruieren.
UniRig (Tsinghua und Tripo, MIT) schließt die Lücke, auf die alle direkt nach der Mesh-Erstellung stoßen: das Rigging. Es erzeugt automatisch ein gültiges Skelett und Skinning-Gewichte für ein Eingabe-Mesh, sodass sich ein generierter Charakter tatsächlich animieren lässt, anstatt nur als statisches Requisit herumzustehen. Kombiniere es mit der Auto-Animationsarbeit in NVIDIAs SOMA-X, und ein vollständig generierter und geriggter Charakter ist keine reine Forschungsdemo mehr.
Das ist die realistische Erwartung für Indie-Entwickler: Erzeuge Concept Art mit FLUX, verarbeite es mit InstantMesh zur Geometrieerstellung und texturiere es anschließend in Blender oder verwende TRELLIS für automatisiertes PBR. So benötigst du pro Asset 30–60 Minuten statt 4–8 Stunden. Nicht gar keine Zeit, aber ein echter Unterschied.
Audio und Musik
Die Audiogenerierung hat noch nicht zu Bildern und Videos aufgeschlossen. Aber es gibt inzwischen genug Möglichkeiten, um deine Arbeitsweise zu verändern – besonders beim Prototyping und bei Soundeffekten.
KI-generiertes Musikbeispiel. Beschreibe die gewünschte Stimmung und erhalte passende Musik
| Modell | Organisation | Veröffentlicht | Funktion | Lizenz | Kosten/30 s |
|---|---|---|---|---|---|
| ACE-Step 1.5 | StepFun/ACE Studio | Jan. 2026 | Schnelle Generierung von ~4 Min. Musik, 19 Sprachen, Stimmklonen | MIT | ~$0.02 |
| Stable Audio 3.0 | Stability AI | Mai 2026 | Songs mit bis zu ~6 Min.; offene Small-, Small-SFX- und Medium-Modelle | Stability Community | ~$0.02 |
| YuE | MAP | Jan. 2025 | Vollständige Songs aus Liedtexten, Gesang + Begleitung | Apache 2.0 | ~$0.05 |
| MusicGen | Meta | 2023 | Text-zu-Musik, steuerbar | Code MIT / Gewichte CC-BY-NC | ~$0.01 |
| DiffRhythm 2 | ASLP-lab | Feb. 2026 | Schnelle Generierung vollständiger Songs | Apache 2.0 | ~$0.02 |
| Magenta RealTime | Juni 2025 | Echtzeitmusik, per Prompt steuerbar | Code Apache / Gewichte CC-BY | ~$0.02 |
Direkt ausprobieren: MusicGen-Demo ↗ · AudioCraft-Playground ↗
Beispiele ansehen: MusicGen-Beispiele ↗ · AudioGen-Beispiele ↗
Was du tatsächlich veröffentlichen kannst
MusicGen von Meta ist weiterhin eine praktische Wahl für das Prototyping von Spielaudio. Beschreibe die gewünschte Stimmung, erhalte passende Musik, und das Modell läuft problemlos auf einer GPU mit 12 GB. Eine wichtige Lizenzfalle: Der MusicGen-Code steht unter MIT, die Modellgewichte jedoch unter CC-BY-NC (nicht kommerziell). Nutze es daher für Prototypen und wechsle für alles, was du veröffentlichst, zu einem kommerziell lizenzierten Modell wie ACE-Step oder Stable Audio.
Das offene Soundeffektmodell Small-SFX von Stable Audio verarbeitet Schritte, knarrende Türen, Windgeräusche und mechanische Klänge, läuft lokal und wird unter der Community-Lizenz von Stability veröffentlicht. Damit ist es die offene SFX-Option, wenn du Sounds brauchst, die du tatsächlich kommerziell verwenden kannst. Es ist die beste Wahl, weil die anderen offenen SFX-Modelle Einschränkungen mitbringen: Metas AudioGen steht unter CC-BY-NC und TangoFlux unter der nicht kommerziellen Community-Lizenz von Stability. Für ein veröffentlichtes Spiel eignen sich beide daher nur zum Prototyping.
Magenta RealTime (Google) ist im besten Sinne ein Sonderfall: Es ist das einzige Modell mit offenen Gewichten, das für in Echtzeit und kontinuierlich per Prompt steuerbare Musik entwickelt wurde. Statt einen fertigen Track zu rendern, erzeugt es Musik live, die du während der Wiedergabe beeinflussen kannst. Das entspricht genau der Struktur eines adaptiven Spiel-Soundtracks, der sich an die Handlungen der Spieler anpasst. Der Code steht unter Apache 2.0 und die Gewichte unter CC-BY; beides eignet sich für die kommerzielle Nutzung.
YuE ist wirklich spannend. Es ist das erste offene Modell, das vollständige Songs mit Gesang erzeugt. Titelsongs. Hintergrundmusik mit echtem Gesang. Die Qualität schwankt, ist aber allem anderen, was du herunterladen und selbst ausführen kannst, meilenweit voraus.
ACE-Step ist das offene Musikmodell, das du jetzt kennen solltest, und es hat sich schnell weiterentwickelt: Die 1.5-Reihe vom Januar 2026, einschließlich einer größeren 5B-XL-Variante, ersetzt die ursprüngliche Veröffentlichung vom Mai 2025 und steht nun unter der MIT-Lizenz. Sie erzeugt schnell mehrere Minuten Musik, unterstützt 19 Sprachen und beherrscht Stimmklonen, Remixen sowie die Bearbeitung von Liedtexten. Beim Prototyping von Spielen schließt sie viele der Lücken, die YuE und MusicGen offengelassen haben.
Stable Audio 3.0 (Mai 2026) ist das größere Update für Sound. Es kann Songs mit einer Länge von bis zu ungefähr sechs Minuten erzeugen, und Stability hat für drei der vier Varianten offene Gewichte veröffentlicht: Small und das spezielle Soundeffektmodell Small-SFX laufen beide auf dem Endgerät, während Medium eine bessere musikalische Struktur und die volle Tracklänge bietet. Nur das Large-Modell blieb ausschließlich per API verfügbar. Small-SFX ist jetzt die stärkste offene Option speziell für Spiel-SFX. Die drei offenen Modelle werden unter der Stability AI Community License veröffentlicht. Diese erlaubt es dir, die generierten Inhalte zu verwenden und zu verkaufen; Unternehmen mit einem Jahresumsatz von mehr als $1M benötigen laut Ankündigung von Stability eine Enterprise-Lizenz. Die gesamte Modellfamilie wurde mit lizenzierten Daten trainiert, sodass die rechtliche Grundlage solider ist als bei Musikgeneratoren mit noch ungeklärten Klagen.
Die ehrliche Einschätzung: Der Abstand zwischen offenen und geschlossenen Modellen (Suno, Udio) wird bei vollständigen Songs mit Gesang kleiner, ist aber weiterhin deutlich. Bei diesen geschlossenen Tools sind außerdem Rechtsstreitigkeiten über die Trainingsdaten noch nicht geklärt. Bei Soundeffekten sind offene Modelle – insbesondere das SFX-Modell von Stable Audio – tatsächlich konkurrenzfähig. Bei Songs, die du veröffentlichen möchtest, solltest du mit vielen Iterationen rechnen oder für die finale Produktion einen Musiker hinzuziehen und diese Tools für alles andere nutzen.
Sprache und Stimmen
Die Stimmerzeugung hat die Schwelle „gut genug für Spiele“ längst überschritten, und das verändert die Möglichkeiten kleiner Teams.
KI-generierte Spiel-Erzählstimme mit natürlicher Sprache, angemessenem Sprechtempo und Emotionen
| Modell | Organisation | Veröffentlicht | Hauptmerkmal | Lizenz | Kosten/Min. |
|---|---|---|---|---|---|
| Qwen3-TTS | Alibaba | Jan. 2026 | Stimmklonen mit 3 s Referenzmaterial, Stimmdesign, 10 Sprachen | Apache 2.0 | ~$0.002 |
| Chatterbox | Resemble AI | 2025 | Emotionssteuerung, Klonen aus ~5 s, 23 Sprachen | MIT | ~$0.003 |
| CSM | Sesame AI | März 2025 | Natürlicher Gesprächsfluss und natürliche Pausen | Apache 2.0 | ~$0.005 |
| Fish Speech 1.5 | Fish Audio | 2024 | Zero-Shot-Klonen aus 10–30 s | Code Apache / Gewichte CC-BY-NC-SA | ~$0.002 |
| OpenVoice V2 | MyShell/MIT | Apr. 2024 | Steuerung von Emotionen und Akzenten | MIT | ~$0.003 |
| XTTS-v2 | Coqui (Community) | 2024 | 17 Sprachen, Stimmklonen | CPML (nicht kommerziell) | ~$0.005 |
Beispiele anhören: Stimmen von Fish Audio ↗ · OpenVoice-Demo ↗
So klingen NPCs wie echte Menschen
CSM (Conversational Speech Model) von Sesame wurde speziell für Dialoge entwickelt. Es erzeugt natürliche Pausen. Wechsel in der Intonation. Den Rhythmus echter Gespräche. Die meisten TTS-Systeme klingen wie jemand, der ein Skript vorliest, und das hört man sofort. CSM klingt wie jemand, der tatsächlich spricht. Dieser Unterschied ist wichtiger, als du vielleicht denkst.
Qwen3-TTS (Alibaba, Januar 2026) ist die erste Wahl für kommerzielle Projekte. Die gesamte Modellfamilie steht unter Apache 2.0, klont eine Stimme aus etwa drei Sekunden Referenzmaterial, spricht zehn Sprachen und unterstützt beschreibungsbasiertes Stimmdesign. So kannst du die Stimme eines NPCs in normalem Text festlegen, statt nach passenden Referenzaufnahmen zu suchen. Die Modelle mit 0,6 und 1,7 Milliarden Parametern laufen auf moderater Hardware. Chatterbox (Resemble AI) ist die erste Wahl für ausdrucksstarke Stimmen. Da es unter der MIT-Lizenz steht, kannst du es in veröffentlichten Spielen einsetzen. Es klont eine Stimme anhand von etwa 5 Sekunden Audiomaterial, arbeitet mit einer Latenz von unter 200 ms, unterstützt 23 Sprachen und ist das erste offene Modell mit einer Steuerung zur Verstärkung von Emotionen. Dadurch kann ein NPC tatsächlich wütend oder verängstigt klingen, statt ausdruckslos zu bleiben. Zwei weitere Optionen unter Apache 2.0 decken bestimmte Nischen ab: Orpheus (Canopy) verarbeitet eingebettete Emotions-Tags wie <laugh> und <sigh>, die sich sauber auf kurze NPC-Ausrufe abbilden lassen, und bietet eine 150M-Variante für leistungsschwache Hardware. Dia (Nari Labs) ist für Dialoge mit mehreren Sprechern konzipiert und erzeugt nonverbale Laute wie Husten und Lachen in einem einzigen Durchlauf. Mistrals Voxtral TTS (März 2026) ist ein neueres Modell mit offenen Gewichten, das sich laut Mistrals News-Seite an Sprachagenten richtet. Lies vor der Veröffentlichung jedoch die Lizenz.
Fish Speech und OpenVoice übernehmen das Klonen von Stimmen. Nimm 10–30 Sekunden eines Sprechers auf und generiere anschließend unbegrenzt viele Dialogzeilen mit dieser Stimme. Denk darüber nach, was das bedeutet: Du kannst Sprecher für zentrale Dialogzeilen engagieren und ihre Darbietung anschließend auf Hunderte Variationen und Umgebungsdialoge ausweiten. Ein Hinweis zur Lizenz von Fish Speech: Der Code ist offen, aber die Gewichte der Version 1.5 stehen unter CC-BY-NC-SA. Damit eignet es sich nur als Prototyping-Werkzeug. Verwende für veröffentlichte Spiele stattdessen OpenVoice (MIT) oder Qwen3-TTS (Apache 2.0).
NVIDIA ACE (nicht vollständig offen, aber erwähnenswert) unterstützt mittlerweile Qwen3-8B für die lokale Bereitstellung von NPCs. Lokales LLM + lokale TTS + Lippensynchronisation – alles läuft auf Consumer-GPUs. Das ist der passende Stack für NPC-Gespräche in Echtzeit, die keine Cloud-Aufrufe benötigen.
Der sinnvolle Ansatz für Indie-Entwickler: Engagiere Sprecher für Hauptfiguren und besonders wichtige Dialogzeilen. Nutze Qwen3-TTS oder OpenVoice, um die Abdeckung auf Umgebungsdialoge, Variationen und all die beiläufigen Zeilen auszuweiten, die andernfalls stumm bleiben oder unerschwinglich teuer wären.
Weltmodelle und Spielsimulation
Hier wird es wirklich seltsam – und wirklich spannend. Diese Modelle generieren keine statischen Assets. Sie generieren Erlebnisse, die sich wie Spiele anfühlen.
🎮 Oasis spielen: KI-generiertes MinecraftEchtzeit-Weltgenerierung ohne Spiele-Engine, allein durch KI-Vorhersagen
| Modell | Organisation | Veröffentlicht | Funktionsweise | Status | Kosten/Frame |
|---|---|---|---|---|---|
| DIAMOND | Forschung | 2024 | Diffusions-Weltmodell, Atari-Simulation | Offene Gewichte | ~$0.001 |
| Oasis | Decart/Etched | Okt. 2024 | Minecraft-Generierung in Echtzeit | 500M-Gewichte offen | ~$0.002 |
| MineWorld | Microsoft | Apr. 2025 | Minecraft in Echtzeit, offene Oasis-Alternative | MIT | ~$0.002 |
| Hunyuan-GameCraft | Tencent | Aug. 2025 | Interaktives Spielvideo, Tastatur-/Maussteuerung | Tencent Community | ~$0.005 |
| GameGen-X | Forschung | 2024 | Open-World-Videogenerierung | Offener Code + Datensatz | ~$0.005 |
| NVIDIA Cosmos | NVIDIA | Okt. 2025 | Simulation physischer KI (Predict2.5) | NVIDIA Open Model License | ~$0.01 |
| Matrix-Game 3.0 | Skywork | März 2026 | Interaktive 720p-Welten in Echtzeit, Langzeitgedächtnis | Offene Gewichte | ~$0.005 |
| Genie 2 | DeepMind | Dez. 2024 | Interaktives 3D aus Bildern | Nicht veröffentlicht | k. A. |
| Genie 3 | DeepMind | Aug. 2025 | 720p-Welten in Echtzeit, per Prompt steuerbare Ereignisse | Geschlossen (Project Genie) | k. A. |
Mehr zur Forschung: DIAMOND-Projektseite ↗ · Cosmos-Blog ↗
Ausprobieren: Oasis-Live-Demo ↗ · Genie-2-Beispiele ↗
Warum das für dich wichtig ist
DIAMOND hat etwas bewiesen, das die Sichtweise auf Spiele-KI verändert. Du kannst einen Agenten vollständig innerhalb einer generierten Welt trainieren. Für das Training ist keine echte Spiele-Engine erforderlich. Die KI spielt in der Vorstellungswelt eines Diffusionsmodells und überträgt das Gelernte anschließend auf das reale Spiel. Das hat weitreichende Folgen.
Oasis führt eine Minecraft-ähnliche Welt in Echtzeit aus. Frame für Frame. Keine Spiele-Engine, keine Texturen, keine vorgefertigten Assets. Nur ein Transformer, der vorhersagt, was als Nächstes geschieht. Es ist ein Machbarkeitsnachweis, aber stell dir vor, wohin das führt. Die Version mit 500M Parametern ist bereits offen.
GameGen-X hat den größten Datensatz für Open-World-Spielvideos veröffentlicht. Wenn du eigene Modelle trainieren oder vorhandene Modelle für die Generierung spielähnlicher Inhalte feinabstimmen möchtest, ist dies dein Ausgangspunkt.
NVIDIA Cosmos wurde für Robotik und autonome Fahrzeuge entwickelt, doch seine World-Foundation-Modelle eignen sich auch für Spiele. Sie verstehen Physik, Objektpermanenz und räumliche Beziehungen. Die aktuelle offene Modellreihe ist Cosmos-Predict2.5. Sie wurde im Oktober 2025 unter der NVIDIA Open Model License veröffentlicht, die kommerzielle Nutzung und abgeleitete Werke erlaubt.
Hunyuan-GameCraft (Tencent, August 2025) ist das offene Weltmodell, das am unmittelbarsten auf Spiele zugeschnitten ist. Es wurde mit mehr als einer Million Aufzeichnungen aus über 100 AAA-Spielen trainiert und vereint Tastatur- und Mauseingaben in einem gemeinsamen Steuerungsraum. Dadurch generiert es interaktive Spielvideos, die du tatsächlich steuerst, statt sie nur anzusehen. Es verwendet dieselbe Tencent Community License wie Hunyuan3D, einschließlich desselben Ausschlusses der EU, des Vereinigten Königreichs und Südkoreas. Prüfe daher vor einer Veröffentlichung in diesen Regionen die Bedingungen. MineWorld (Microsoft, MIT) ist das vollständig freizügig lizenzierte Gegenstück zu Oasis: ein Minecraft-Weltmodell in Echtzeit, das du herunterladen und ohne Spiele-Engine ausführen kannst.
Genie 3 (DeepMind, angekündigt im August 2025) ist der erwähnenswerte Technologiesprung: das erste Weltmodell mit Echtzeitinteraktion, das navigierbare 720p-Welten mit 24 fps generiert, die einige Minuten lang konsistent bleiben. Hinzu kommen „per Prompt steuerbare Weltereignisse“, die auf Befehl das Wetter ändern oder Objekte hinzufügen. Im Januar 2026 wurde es in den USA als Project Genie für Abonnenten von Google AI Ultra öffentlich zugänglich. Die Gewichte bleiben geschlossen, aber es zeigt, wohin sich spielbare, generierte Welten entwickeln.
Matrix-Game 3.0 (Skywork, März 2026) ist die offene Antwort auf Genie. Es ist ein gedächtniserweitertes interaktives Weltmodell, das 720p-Inhalte mit 40 fps in Echtzeit streamt und Szenen über minutenlange Sequenzen hinweg konsistent hält. Eine destillierte 5B-Version ermöglicht Echtzeit-Inferenz, während eine größere 2x14B-MoE-Version die Qualität steigert. Die Gewichte sind auf Hugging Face unter Apache 2.0 verfügbar. Wenn du heute mit spielbaren generierten Welten experimentieren möchtest, statt auf DeepMind zu warten, kannst du dieses Modell tatsächlich herunterladen.
Für die praktische Spieleentwicklung sind dies derzeit noch Forschungswerkzeuge. Wenn du jedoch an KI-gesteuerten Inhalten oder prozeduraler Generierung arbeitest oder einfach darüber nachdenkst, wohin die Entwicklung führt, findest du hier den aktuellen Stand der Technik.
Große Sprachmodelle
LLMs ermöglichen Dialoge, Quest-Generierung und Spiellogik. Die offenen Optionen können inzwischen tatsächlich mit GPT-4 konkurrieren. Vor zwei Jahren war das noch nicht der Fall.
| Modell | Organisation | Veröffentlicht | Größe | Am besten geeignet für | Lizenz | Kosten/1K Token |
|---|---|---|---|---|---|---|
| DeepSeek-V3 | DeepSeek | Dez. 2024 | 671B MoE (37B aktiv) | Schlussfolgern, allgemeine Aufgaben | Freizügig | ~$0.02 |
| DeepSeek-R1 | DeepSeek | Jan. 2025 | Basierend auf V3 | Gedankenkette | Freizügig | ~$0.03 |
| DeepSeek-V3.2 | DeepSeek | Dez. 2025 | Sparse Attention (DSA) | Schlussfolgern + Werkzeugnutzung | MIT | ~$0.02 |
| DeepSeek-V4 | DeepSeek | Apr. 2026 | 1.6T MoE (49B aktiv) | Schlussfolgern auf Spitzenniveau, 1M Kontext | MIT | ~$0.02 |
| GLM-5 | Zhipu / Z.ai | Feb. 2026 | 744B MoE (40B aktiv) | Programmierung, Agenten, Werkzeugnutzung | MIT | ~$0.02 |
| GLM-5.2 | Zhipu / Z.ai | Juni 2026 | 753B MoE | Programmierung, Agenten, 1M Kontext | MIT | ~$0.02 |
| GPT-OSS | OpenAI | Aug. 2025 | 120B / 20B MoE | Schlussfolgern, Werkzeugnutzung, lokale Ausführung | Apache 2.0 | ~$0.01 |
| Kimi K2 | Moonshot | 2025 | 1T MoE (32B aktiv) | Agenten, Programmierung | Modifizierte MIT-Lizenz | ~$0.02 |
| Kimi K3 | Moonshot | Juli 2026 | 2.8T MoE (16 von 896 Experten aktiv) | Agenten auf Spitzenniveau, Programmierung, 1M Kontext, Bildverarbeitung | Kimi K3 License | ~$0.03 |
| Hy3 | Tencent | Juli 2026 | 295B MoE (21B aktiv) | Schlussfolgern, agentisches Programmieren, 256K Kontext | Apache 2.0 | ~$0.02 |
| Gemma 3 | 2025 | 1B-27B | Lokale Ausführung, 140 Sprachen, Bildverarbeitung | Gemma | ~$0.01 | |
| Gemma 4 | Apr. 2026 | E2B bis 31B (26B-A4B MoE) | Lokale Ausführung, über 140 Sprachen, Bild + Audio, 256K | Apache 2.0 | ~$0.01 | |
| Qwen3 | Alibaba | 2025 | 235B MoE (22B aktiv) | Mehrsprachigkeit, Code | Apache 2.0 | ~$0.01 |
| Qwen3.5 / 3.6 / 3.8 | Alibaba | Feb.–Aug. 2026 | 0.8B bis 2.4T-A95B | Multimodalität, Agenten, offenes Flaggschiff auf Qwen-Max-Niveau | Apache 2.0 | ~$0.02 |
| Mistral Small 4 | Mistral | März 2026 | 119B MoE (6B aktiv) | Schlussfolgern + Bildverarbeitung + agentisches Programmieren, 256K | Apache 2.0 | ~$0.01 |
| Qwen3-Coder | Alibaba | 2025 | 480B MoE (35B aktiv) | Agentisches Programmieren, 256K Kontext | Apache 2.0 | ~$0.02 |
| Llama 4 | Meta | 2025 | Verschiedene | Agenten, bis zu 10M Kontext | Llama Community | ~$0.01 |
| Muse Glimmer 30B | Meta | Aug. 2026 | ~30B dicht | Lokale Agenten, Bildverarbeitung, über 128K Kontext | Apache 2.0 | ~$0.01 |
| Qwen3-VL | Alibaba | 2025 | 2B-235B | Bildverarbeitung + Sprache | Apache 2.0 | ~$0.02 |
| InternVL3 | Shanghai AI Lab | 2025 | 1B-78B | Bildverarbeitung, OCR, UI-Verankerung | MIT | ~$0.02 |
Erste Schritte: Qwen3-8B auf HuggingFace ↗ · DeepSeek-V3 auf HuggingFace ↗ · GLM-5 auf HuggingFace ↗
Für die Spieleentwicklung
Qwen3 ist für die meisten Anwendungsfälle in Spielen die pragmatische Wahl. Die Apache-2.0-Lizenz bedeutet, dass deine Integration dir gehört. Die starke Unterstützung mehrerer Sprachen ist wichtig, wenn du über Lokalisierung nachdenkst. Das Modell kann strukturierte Anweisungen gut befolgen. Die Varianten mit 7B und 14B laufen lokal auf Consumer-GPUs.
Qwen3.5, 3.6 und 3.8 führten die Apache-2.0-Reihe im Jahr 2026 fort. Qwen3.5 (16. Februar 2026) startete mit einem 397B-A17B-MoE und ergänzte später dichte Varianten mit 27B, 9B und 4B. Qwen3.6 (April) optimierte dieselbe Familie auf Stabilität. Das Modell 35B-A3B ist dabei der ideale Kompromiss für lokale Ausführung: 35B an Wissen, aber nur 3B aktive Parameter pro Token, sodass es auf einer einzelnen Grafikkarte mit 24 GB sehr schnell läuft. Qwen3.8 (12.–14. August 2026) ist die große Variante. Im Qwen3.8-Repository wird sie als erstes Modell auf Qwen-Max-Niveau beschrieben, das offen veröffentlicht wurde: ein 2.4T-A95B-Flaggschiff neben einem dichten 27B-Modell, beide unter Apache 2.0 und mit einem Kontextfenster von 262K.
DeepSeek-V3 erreicht oder übertrifft GPT-4 in den meisten Benchmarks. Die Architektur ist clever: Trotz insgesamt 671B Parametern werden pro Token nur 37B aktiviert. Du benötigst leistungsstarke Hardware mit mehreren GPUs, erhältst dafür jedoch Spitzenqualität ohne Abhängigkeit von einer API.
DeepSeek-V3.2 (Dezember 2025) vereint Schlussfolgern und Werkzeugnutzung in einem Modell und führt DeepSeek Sparse Attention (DSA) für günstigere Langkontext-Inferenz ein. Eine rechenintensive Speciale-Variante zielt auf die anspruchsvollsten Reasoning-Benchmarks. Für Spiellogik und Dialoge ist es ein leistungsfähigerer, besser für Agenten geeigneter Ersatz für V3.
DeepSeek-V4 (April 2026) hat die offene Modellspitze erneut verschoben. V4-Pro ist ein MoE mit 1.6T Parametern, von denen pro Token nur 49B aktiv sind. Es bietet ein Kontextfenster mit 1 Million Token und auswählbare Reasoning-Modi – alles unter der MIT-Lizenz. Die Variante V4-Flash (insgesamt 284B, davon 13B aktiv) behält den 1M-Kontext in einem Paket bei, das keinen vollständigen GPU-Cluster erfordert. Wenn du heute ein offenes Modell für komplexe Quest-Logik oder umfangreiche Spielzustände auswählst, markiert es die derzeitige Obergrenze.
GLM-5 (Zhipu AI, Februar 2026) ist das offene Modell, das es bei Programmierung und agentischen Aufgaben zu schlagen gilt. Die Aktualisierung GLM-5.2 brachte seine Ergebnisse bei Werkzeugnutzung und langfristiger Planung nahe an die geschlossene Modellspitze. Es ist ein MoE mit 744B Parametern, von denen 40B pro Token aktiv sind, einem Kontextfenster von 200K Token und einer MIT-Lizenz. GLM-5.2 selbst erschien am 17. Juni 2026 als 753B-MoE mit einem Kontextfenster von 1M Token, weiterhin unter MIT und ohne regionale Beschränkungen. Danach folgte GLM-5.3, eine Nachtrainings-Aktualisierung auf derselben Basis, deren Gewichte auf Hugging Face unter Z.ais eigener GLM-5.3-Lizenz statt unter MIT veröffentlicht wurden. Prüfe daher den Lizenztext, wenn du die neueste Version selbst hostest. Z.ai ist das erste börsennotierte Unternehmen für Foundation Models und bietet seine gehostete API zu aggressiven Preisen an (etwa $1.40 pro Million Eingabe-Token). Die Gewichte sind jedoch auf Hugging Face verfügbar, falls du das Modell lieber selbst hosten möchtest. Wenn dein Spiel für Quest-Skripte, Agenten mit Werkzeugaufrufen oder codegesteuerte Systeme auf ein LLM setzt, ist GLM-5 eine starke OpenAI-Alternative, die vollständig unter deiner Kontrolle bleibt. GPT-OSS (OpenAI, August 2025) ist die erste Veröffentlichung von OpenAI mit offenen Gewichten und passt genau zum Thema dieses Leitfadens. Das Modell gpt-oss-120b erreicht beim Schlussfolgern und bei Tool-Aufrufen auf einer einzelnen 80-GB-GPU ungefähr das Niveau von o4-mini, während gpt-oss-20b auf einer Consumer-Grafikkarte mit 16 GB läuft – beide unter Apache 2.0. Wenn du ein Modell aus einem westlichen KI-Labor suchst, das du für NPC-Logik oder Agenten mit Tool-Nutzung selbst hosten kannst, ist das die richtige Wahl.
Kimi K2 (Moonshot) ist neben GLM-5 und DeepSeek das andere große offene Modell für agentenbasierte Aufgaben. Es ist ein MoE mit 1 Billion Parametern, von denen 32 Milliarden aktiv sind, und wurde intensiv für Programmierung und Tool-Nutzung optimiert. Seine modifizierte MIT-Lizenz bringt nur bei mehr als 100 Millionen monatlichen Nutzern zusätzliche Einschränkungen mit sich, sodass sie für Indie-Entwickler praktisch einer MIT-Lizenz entspricht. Greif dazu, wenn ein Agent über viele Schritte hinweg planen muss.
Kimi K3 (Moonshot, Juli 2026) ist das größte jemals angekündigte Modell mit offenen Gewichten und kommt der geschlossenen Spitzenklasse näher als jedes offene Modell zuvor. Es ist ein MoE mit 2,8 Billionen Parametern, von denen pro Token nur etwa 50 Milliarden aktiv sind (16 von 896 Experten), einem Kontextfenster von 1 Million Tokens und nativer Bildverarbeitung. Es basiert auf zwei neuen Attention-Architekturen namens Kimi Delta Attention und Attention Residuals. In Moonshots Benchmarks vom Juli übertraf es die damaligen Versionen von Claude Opus und GPT-5.5 bei Programmier- und agentenbasierten Aufgaben und lag nur hinter den allerbesten proprietären Modellen. Diese Zielmarken haben sich mit Claude Fable 5.1 und GPT-6 Astra im September inzwischen erneut verschoben. Die Gewichte erschienen am 27. Juli 2026 im MXFP4-Format auf Hugging Face, unter der Kimi-K3-Lizenz statt MIT. Sie ist für die meisten Einsatzzwecke freizügig, doch ein Model-as-a-Service-Unternehmen mit mehr als $20 Millionen Umsatz innerhalb eines beliebigen Zeitraums von 12 Monaten benötigt eine separate Vereinbarung mit Moonshot. Produkte mit mehr als 100 Millionen monatlichen Nutzern oder $20 Millionen Monatsumsatz müssen außerdem „Kimi K3“ in ihrer Benutzeroberfläche anzeigen. Ein 2,8-T-Modell selbst zu hosten erfordert weiterhin einen GPU-Cluster mit mehreren Knoten, daher werden die meisten Teams über die API darauf zugreifen – für $3 pro Million Eingabe-Tokens und $15 pro Million Ausgabe-Tokens. Für Agenten, die du tatsächlich selbst betreiben kannst, bleibt K2 die praktische Wahl von Moonshot. K3 definiert jedoch neu, was „offen“ in der Spitzenklasse bedeuten kann.
Gemma 3 (Google) eignet sich am besten, wenn das Modell auf der Hardware der Spieler laufen oder umfassend lokalisiert werden soll. Es ist in Größen von 1B, 4B, 12B und 27B verfügbar und skaliert damit von Grafikkarten mit 8 GB aufwärts. Es unterstützt 140 Sprachen und Function Calling; die Varianten ab 4B können außerdem Bilder verarbeiten und dienen somit zugleich als kleine Bildmodelle. Die Gemma-Lizenz erlaubt die kommerzielle Nutzung.
Gemma 4 (Google, 2. April 2026) ersetzt Gemma 3 bei neuen Projekten und klärt die Lizenzfrage endgültig: Laut Modellkarte steht die gesamte Familie unter Apache 2.0. Sie umfasst E2B und E4B für Smartphones und Laptops, ein 12B-Modell, ein 26B-A4B-MoE mit weniger als 4 Milliarden aktiven Parametern sowie ein dichtes 31B-Modell. Die kleinen Modelle besitzen ein Kontextfenster von 128K, die übrigen von 256K. Alle Größen unterstützen native Bildeingaben, die kleinen zusätzlich Audio, und es werden mehr als 140 Sprachen unterstützt. Für ein auf dem Gerät laufendes NPC-Gehirn, das außerdem einen Screenshot betrachten können muss, ist 26B-A4B die richtige Wahl.
Metas Llama-Reihe liegt faktisch auf Eis. Llama 4 (April 2025) ist weiterhin das letzte Llama-Modell. Im April 2026 brachte Meta Superintelligence Labs mit Muse Spark den Nachfolger als geschlossenes Modell heraus. Im August 2026 kehrte Meta teilweise zur Offenheit zurück und veröffentlichte Muse Glimmer 30B, ein dichtes multimodales Modell mit ungefähr 30 Milliarden Parametern unter Apache 2.0, einem Kontextfenster von mehr als 128K und 4-Bit-Versionen, die auf eine 24-GB-Grafikkarte passen. Es ist ein starkes lokales Agentenmodell. Wenn du jedoch auf Llama 5 gewartet hast, solltest du damit aufhören und stattdessen Qwen, Gemma 4 oder Glimmer wählen.
Hy3 (Tencent, Juli 2026) ist die andere große Neuerscheinung unter Apache 2.0. Laut seiner Modellkarte handelt es sich um ein 295B-MoE mit 21 Milliarden aktiven Parametern und einem Kontextfenster von 256K. Mit der Veröffentlichung im Juli entfielen die regionalen Ausschlüsse der Vorschauversion vom April. Anders als Tencents Lizenzen für Hunyuan3D und GameCraft kann es daher in der EU, im Vereinigten Königreich und in Südkorea eingesetzt werden.
Qwen3-Coder (Alibaba) ist das spezialisierte offene Programmiermodell und ersetzt für die meisten Einsatzzwecke die ältere DeepSeek-Coder-Reihe. Es ist ein 480B-MoE mit 35 Milliarden aktiven Parametern, einem nativen Kontextfenster von 256K, das sich auf 1 Million erweitern lässt, und steht unter Apache 2.0. In Benchmarks für agentenbasiertes Programmieren gehört es zur Claude-Sonnet-Klasse. Wenn dein Spiel Code erzeugt oder ausführt, ist dies die Obergrenze unter den offenen Modellen. Europas Mistral-Familie ist eine solide, selbst hostbare Alternative: Devstral für Programmierung und Mistral Small 4 (16. März 2026), ein 119B-MoE mit 6 Milliarden aktiven Parametern, das Schlussfolgern, Bildverarbeitung und agentenbasiertes Programmieren in einem Modell unter Apache 2.0 mit einem Kontextfenster von 256K vereint.
Qwen3-VL ergänzt Bildverständnis und ist unter Apache 2.0 in dichten und MoE-Varianten von 2B bis 235B verfügbar. Es eignet sich für Spiele, die Screenshots analysieren, von Spielern gezeichnete Inhalte verstehen oder Kameraeingaben verarbeiten müssen. Die 8B-Variante läuft auf einer einzelnen GPU. InternVL3 (Shanghai AI Lab, MIT) ist die andere starke offene Vision-Language-Option und besonders gut bei OCR und der räumlichen Zuordnung von UI-Elementen. Das ist wichtig, wenn deine Tools Spieloberflächen lesen müssen. Mistrals Pixtral 12B (Apache 2.0) ist eine leichtere, kommerziell sicher einsetzbare Wahl.
Für NPCs, die direkt auf dem Gerät und ohne Cloud-Aufrufe in Echtzeit reagieren sollen, ist Qwen3-8B über NVIDIA ACE derzeit der praktikabelste Weg. Es läuft parallel zu deinem Spiel auf der Hardware des Spielers.
Hilfsmodelle
Diese Modelle erzeugen nicht direkt Inhalte, sorgen aber dafür, dass deine Pipelines funktionieren.
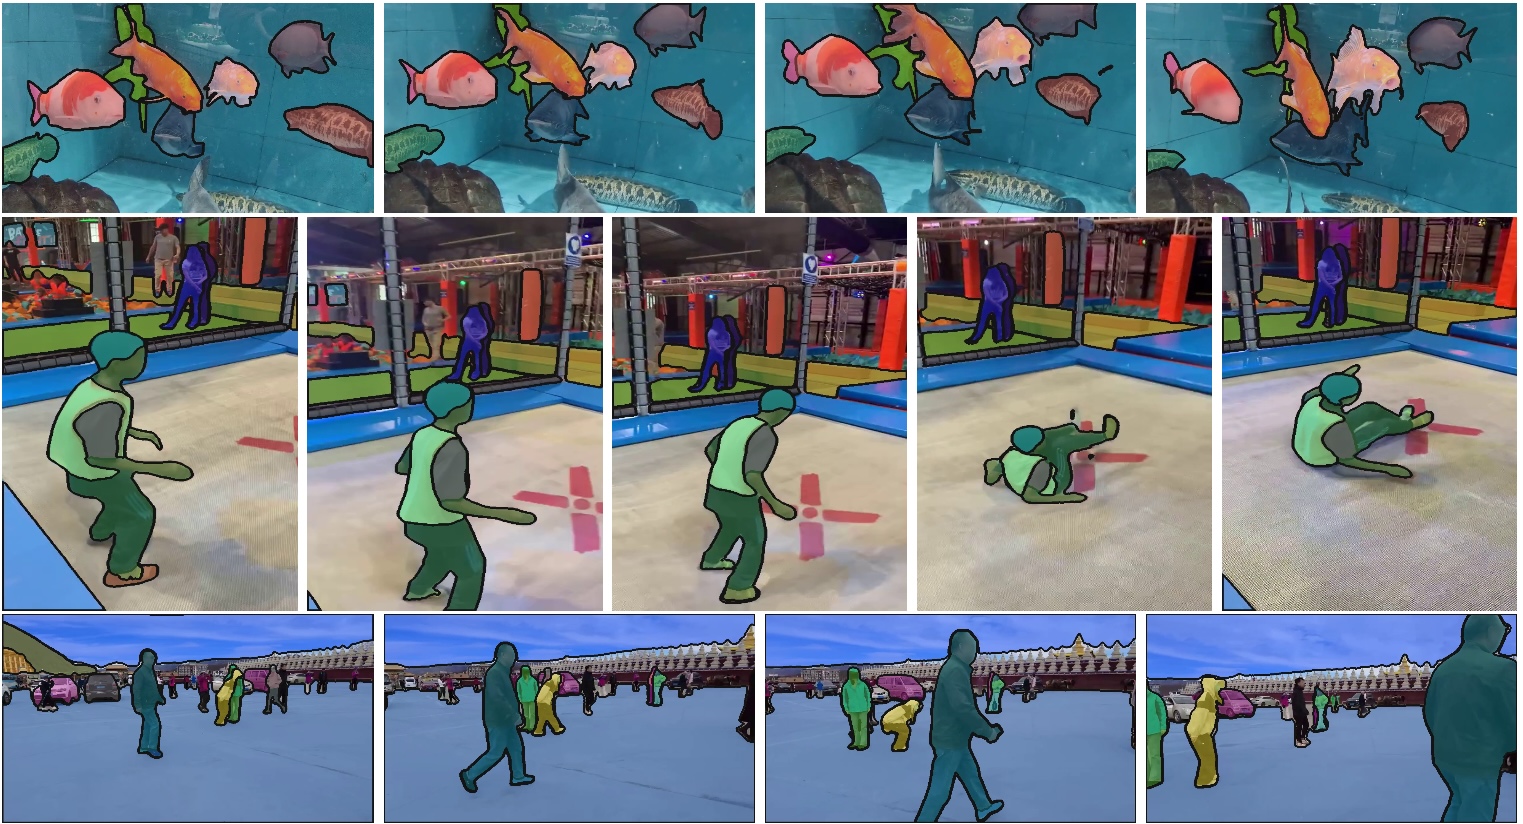 SAM 2 segmentiert beliebige Objekte in Bildern und Videos. Ein Klick genügt für eine perfekte Maske
| Modell | Organisation | Veröffentlicht | Funktion |
|---|---|---|---|
| SAM 2 | Meta | Aug. 2024 | Segmentiert beliebige Elemente in Bildern und Videos |
| Depth Pro | Apple | Okt. 2024 | Erzeugt metrische Tiefeninformationen aus einem einzelnen Bild |
| gsplat | Nerfstudio | 2024+ | GPU-beschleunigtes Gaussian Splatting mit CUDA |
SAM 2 segmentiert Objekte in Videos in Echtzeit. Klicke auf etwas und du erhältst eine perfekte Maske. Das ist nützlich für Rotoskopie, Compositing oder das Extrahieren von Objekten aus Videomaterial zur Verwendung als Spiel-Assets. SAM 2 ausprobieren ↗
Depth Pro von Apple erzeugt in weniger als einer Sekunde metrische Tiefenkarten aus einzelnen Bildern. Das eröffnet viele Möglichkeiten: Du kannst 2D-Grafiken mit Parallaxeneffekten in 2,5D umwandeln, Tiefendaten für 3D-Rekonstruktionen erzeugen und Normal Maps aus flachen Bildern erstellen. Depth Pro auf Hugging Face ↗
gsplat ist die schnelle Implementierung von Gaussian Splatting. Wenn du reale Umgebungen für Spiele erfasst – ob per Photogrammetrie oder Umgebungsscan –, macht diese Bibliothek den Workflow praxistauglich.
Was ich tatsächlich verwenden würde
Wenn du heute ein Spielprojekt beginnst, ist dieser Stack sinnvoll:
Texturen und Sprites: FLUX.1 [schnell], Apache 2.0, schnelle Iteration, veröffentlichungsreife Qualität
Concept Art: SD 3.5 Large mit LoRAs zur Stilsteuerung
3D-Assets: Hunyuan3D 2.1 oder TRELLIS.2 für texturierte Meshes, SAM 3D bei einem Foto als Ausgangspunkt, anschließend Blender für die Nachbearbeitung
Auto-Rigging: UniRig oder NVIDIA SOMA-X zum Erstellen von Skeletten und Skinning für generierte Meshes – beide offen –, statt sich auf Mixamo zu verlassen
Soundeffekte: Das offene Small-SFX-Modell von Stable Audio, läuft lokal und ist kommerziell lizenziert
Musik: ACE-Step für Prototypen, anschließend ein Komponist für die finale Produktion
Stimmen: Qwen3-TTS für das Klonen von Stimmen und Umgebungsdialoge (Apache 2.0), Chatterbox (MIT), wenn eine Zeile echte Emotionen braucht, und Synchronsprecher für die wirklich wichtigen Dialoge
NPC-Dialoge: Qwen3.6-35B-A3B, Gemma 4 26B-A4B oder Muse Glimmer 30B lokal; alternativ ein selbst hostbares Cloud-LLM wie GLM-5.2, DeepSeek-V4 oder Kimi K3 für komplexes Schlussfolgern und Tool-Nutzung
Video (Zwischensequenzen): Mochi 1 oder Wan 2.2 5B lokal, LTX-2.5 oder HunyuanVideo-1.5 in der Cloud, wenn du finale Qualität brauchst
Der entscheidende Punkt bei all dem: Der häufigste Fehler besteht darin, KI für alles einsetzen zu wollen. Diese Modelle sind Werkzeuge, kein Ersatz. Sie verkürzen die mühsamen Teile wie Iterationen, Varianten und Platzhalter-Assets, damit du deine Zeit in die kreativen Entscheidungen investieren kannst, auf die es wirklich ankommt. In die Teile, die dein Spiel unverwechselbar machen.
Realitätscheck zur Hardware
Seien wir ehrlich darüber, was du tatsächlich brauchst, um diese Modelle auszuführen:
8 GB VRAM (RTX 3060, 4060): SD 1.5/SDXL, Wan 2.1 Small, AudioGen, Fish Speech, kleine LLMs (7B quantisiert). Das ist das Niveau eines Gaming-Laptops und reicht für den Einstieg aus.
12 GB VRAM (RTX 3080, 4070): SD 3.5, FLUX schnell, Mochi 1, MusicGen, TripoSR, Qwen 14B quantisiert. Ab hier wird es komfortabel. Die meisten nützlichen Modelle laufen mit dieser Ausstattung.
24 GB VRAM (RTX 3090, 4090): Die meisten Modelle bei voller Präzision, InstantMesh, größere LLMs und die lokalen Agentenmodelle von 2026: Qwen3.6-35B-A3B, Gemma 4 31B in 4 Bit und Muse Glimmer 30B in 4 Bit. Wenn du diesen Workflow ernsthaft nutzen willst, liegt hier der ideale Bereich.
48–80 GB VRAM (A100, H100): HunyuanVideo, LTX-2, DeepSeek-V3 und Generierung im Produktionsmaßstab. Das ist Enterprise-Hardware. Du wirst sie nicht kaufen, sondern mieten.
Cloud-Instanzen bei RunPod, Lambda Labs oder Modal kosten für A100-GPUs $2–4 pro Stunde. Bei gelegentlicher Nutzung ist das günstiger als eigene Hardware. Starte eine Instanz, wenn du finale Qualität brauchst, und fahre sie anschließend wieder herunter.
Zu den Kostenschätzungen in diesem Leitfaden: Die Kosten pro Generierung basieren auf selbst gehosteter Inferenz auf Cloud-GPUs für etwa $2–3 pro Stunde (A100) beziehungsweise etwa $0,40 pro Stunde (RTX 4090). Die tatsächlichen Kosten variieren je nach Hardware, Optimierung und Batch-Größe. Diese Werte sind grobe Richtwerte für die Planung; deine tatsächlichen Ergebnisse können abweichen.
Neuheiten im Jahr 2026
Kürzlich veröffentlicht: LTX-2 und LTX-2.3 brachten erstmals offene, synchronisierte Audio- und Videogenerierung mit nativem 4K. Microsofts TRELLIS.2 (Dezember 2025) wurde zum führenden offenen Modell für Bild-zu-3D, während Metas SAM 3D (November 2025) 3D-Rekonstruktionen aus einzelnen Fotos praxistauglich machte. FLUX.2 löste FLUX.1 bei der Bilderzeugung ab, und NVIDIAs SOMA-X brachte offenes Auto-Rigging und Retargeting. In der ersten Hälfte des Jahres 2026 ging es im gleichen Tempo weiter: Qwen3-TTS (Januar) gab dem Klonen von Stimmen eine echte Heimat unter Apache 2.0, Zhipus GLM-5 (Februar) erschien als offenes 744B-Modell für Programmierung und agentenbasierte Aufgaben unter MIT, Skyworks Matrix-Game 3.0 (März) stellte ein interaktives Echtzeit-Weltmodell mit offenen Gewichten bereit, DeepSeek-V4 (April) erweiterte offene LLMs unter MIT auf ein Kontextfenster von 1 Million Tokens, Stable Audio 3.0 (Mai) brachte drei offene Audiomodelle heraus, die mit lizenzierten Daten trainiert wurden, und Ideogram veröffentlichte sein erstes Bildmodell mit offenen Gewichten (Juni). Im Juli kündigte Moonshot dann Kimi K3 an, ein Modell mit offenen Gewichten und 2,8 Billionen Parametern. Seine Gewichte erschienen am 27. Juli unter der Kimi-K3-Lizenz – im selben Monat, in dem Tencent das 295B-Modell Hy3 unter Apache 2.0 stellte, und wenige Wochen nachdem Z.ai GLM-5.2 unter MIT veröffentlicht hatte (17. Juni). Auch der August war auf der offenen Seite ereignisreich: Alibaba veröffentlichte Qwen3.8 – ein Spitzenmodell mit 2,4T-A95B sowie ein dichtes 27B-Modell unter Apache 2.0 –, Meta stellte Muse Glimmer 30B unter Apache 2.0 bereit, MiniMax öffnete die Videomodell-Gewichte von H3 mit 33 Milliarden Parametern und Lightricks veröffentlichte LTX-2.5. Bereits früher im Jahr definierten Googles Gemma 4 (April, Apache 2.0) und Mistral Small 4 (März, Apache 2.0) die Geräteklasse neu.
Der wichtigste Trend: Die führenden Labore stellen ihre neuesten Modelle zunehmend nur noch per API bereit, selbst wenn frühere Versionen offen waren. Wan wurde mit Version 2.5 geschlossen und blieb es bis einschließlich 3.0 (August 2026), Qwen-Image wurde mit 2.0 geschlossen und Hunyuan3D mit 2.5. Metas Llama-Nachfolger Muse Spark erschien im April 2026 zunächst geschlossen, bevor das kleinere Muse Glimmer im August wieder offen veröffentlicht wurde. Black Forest Labs bringt FLUX 3 zuerst über seine API heraus und hat ein offenes FLUX 3 Dev für später im Jahr 2026 angekündigt. Skywork wiederum kündigte SkyReels V4 im Februar an, ohne Gewichte zu veröffentlichen. Das offene Ökosystem bleibt lebendig und entwickelt sich schnell, doch du kannst nicht mehr automatisch davon ausgehen, dass die neueste Version offen ist. Prüfe daher die Verfügbarkeit der Gewichte, bevor du eine Pipeline um ein Modell herum aufbaust.
Die Entwicklung ist eindeutig: Jede Fähigkeit, die in geschlossenen Modellen existiert, erscheint 6 bis 12 Monate später auch in offenen Modellen. Die Frage ist nicht, ob offene Modelle gut genug sein werden. Für die meisten Einsatzzwecke sind sie es bereits. Die Frage ist, wie schnell sie zum Standard werden.
Und für Kreative bedeutet das Folgendes: Werkzeuge, die früher Enterprise-Budgets oder monatliche Abonnements erforderten, werden zu etwas, das du einfach selbst ausführen kannst. Auf deiner eigenen Hardware. Ohne die Erlaubnis anderer.
Das ist der Wandel. Darauf arbeiten wir hin.
Häufige Fragen
Welches ist das beste Open-Source-KI-Modell zum Erzeugen von Spiel-Assets?
Das hängt vom jeweiligen Asset ab. Für 3D-Modelle ist Hunyuan3D im Jahr 2026 die stärkste offene Option. Bei 2D-Grafiken und Texturen liegt FLUX qualitativ vorn. Bei Soundeffekten und Musik haben die offenen Audiomodelle schnell aufgeholt. Es gibt kein einzelnes „bestes“ Modell, weil Spiele viele unterschiedliche Asset-Typen benötigen. Die meisten Kreativen verknüpfen daher mehrere Modelle miteinander, statt sich auf nur eines zu verlassen.
Sind Open-Source-KI-Modelle gut genug, um geschlossene APIs zu ersetzen?
Für die meisten Arbeiten an Spiel-Assets im Jahr 2026 lautet die Antwort: ja. Offene Modelle erreichen bei der Erzeugung von Bildern, 3D-Inhalten und Audio inzwischen das Niveau geschlossener APIs. Du kannst sie außerdem ohne Gebühren pro Aufruf oder überraschende Preisänderungen auf deiner eigenen Hardware ausführen. Bei einigen Spitzendisziplinen wie langen Videos liegen geschlossene Modelle weiterhin vorn, doch die Lücke schließt sich üblicherweise innerhalb von 6 bis 12 Monaten.
Kann ich diese generativen KI-Modelle auf meiner eigenen GPU ausführen?
Viele davon schon. Bild- und Audiomodelle laufen problemlos auf einer einzelnen Consumer-GPU wie der RTX 4090. Größere Video- und 3D-Modelle benötigen mehr VRAM und häufig eine Cloud-GPU der A100-Klasse. Im Hardwareabschnitt weiter oben steht, was die jeweiligen Modelle benötigen, damit du planen kannst, bevor du dich festlegst.
Was ist 2026 das beste Open-Source-Frontier-Modell?
Stand September 2026 ist das offene Frontier-Segment ein Vierkampf, und die Antwort hängt davon ab, welche Modelle du ausführen kannst. Kimi K3 (2,8T MoE) ist das größte Modell und kommt bei den Benchmarks den geschlossenen Spitzenmodellen am nächsten, doch seine Kimi-K3-Lizenz enthält zusätzliche Bedingungen für große Model-as-a-Service-Unternehmen. DeepSeek-V4-Pro (1,6T, 49B aktiv) und Qwen3.8-2.4T-A95B bieten in dieser Größenklasse die unkompliziertesten Lizenzen: MIT beziehungsweise Apache 2.0. GLM-5.2 (753B, MIT) ist auf Programmierung und Agenten spezialisiert. Keines dieser Modelle passt auf eine einzelne GPU. Für alles, was du selbst hostest, liegt das tatsächlich „beste“ Modell daher eine Stufe darunter: Qwen3.6-35B-A3B, Gemma 4 31B oder Muse Glimmer 30B.
Welches sind die besten offenen und geschlossenen Frontier-Modelle zur Bilderzeugung?
Offen: FLUX.2 [klein] 4B (Apache 2.0, unter einer Sekunde) für kommerziell unbedenkliche Spielgrafiken, Qwen-Image-2512 (Apache 2.0), wenn du lesbaren Text brauchst, sowie FLUX.2 [dev] oder Chroma1-HD für maximale Qualität, sofern die Lizenz zu deinem Projekt passt. Geschlossen: FLUX.2 [pro] und das ausschließlich per API verfügbare Qwen-Image-2.0 sowie neue Modelle aus dem Jahr 2026 wie Kling IMAGE 3.0 (bis zu 10 Referenzbilder laut Klings Leitfaden) und xAIs Grok Imagine Image 2.0. Das Bildmodell von FLUX 3 ist derzeit nur über die API von BFL verfügbar; eine offene Dev-Version ist für später im Jahr 2026 angekündigt. Für die Spieleentwicklung ist die offene Modellklasse bereits gut genug, sodass geschlossene Modelle hauptsächlich mehr Komfort bieten.
Welche Open-Weights-Videomodelle erlauben eine uneingeschränkte kommerzielle Bereitstellung und unter welcher Lizenz?
Wenn du ein offenes Videomodell benötigst, das sich ohne Umsatzobergrenze kommerziell im Unternehmensmaßstab bereitstellen lässt, sind Wan 2.2 (Apache 2.0, einschließlich der MoE-Varianten mit 5B und 14B), Mochi 1 (Apache 2.0), Step-Video-T2V (MIT) und CogVideoX 2B (Apache 2.0) die sicheren Optionen. LTX-2 und LTX-2.5 dürfen bei einem Jahresumsatz von unter $10 Mio. kostenlos kommerziell verwendet werden; darüber ist eine kostenpflichtige Vereinbarung erforderlich. Das ist der von Lightricks tatsächlich angebotene Weg, um Zugang zu erwerben. MiniMax H3 ist unter der MiniMax H3 Community License offen verfügbar, fordert Nutzer in den USA, der EU, dem Vereinigten Königreich und Südkorea jedoch auf, sich zunächst zu bewerben. HunyuanVideo verwendet Tencents Community-Lizenz mit regionalen Ausnahmen. Lies daher beide Lizenzen sorgfältig, bevor du dich festlegst. Für Wan 2.5 bis 3.0, Veo, Kling und Seedance sind überhaupt keine öffentlichen Modellgewichte verfügbar. Unser Leitfaden zu Videomodellen mit Referenzmaterial vergleicht die gehosteten Optionen.
Welche generative KI sollte ich 2026 für Spiel-Assets und Umgebungen verwenden?
Verkette mehrere Spezialmodelle, statt nach einem einzigen Modell für alles zu suchen. Verarbeite für Requisiten und Charaktere ein mit FLUX.2 klein oder Qwen-Image erstelltes Konzept mit Hunyuan3D 2.1 oder TRELLIS.2 und erstelle das Rig mit UniRig. Generiere für Umgebungen eine Skybox oder ein HDRI – unser Skybox-Generator erledigt das direkt im Browser – und erstelle das Gelände prozedural oder mit einem Diffusionsdurchlauf, wie in unserem Leitfaden zur Geländegenerierung. Texturiere es anschließend mit einem Bildmodell und einem PBR-Extraktor, wie in unserem Leitfaden zu KI-Texturgeneratoren beschrieben. Audio stammt von Stable Audio 3.0 Small-SFX und ACE-Step, Stimmen von Qwen3-TTS oder Chatterbox. Stand September 2026 ist jedes Modell in dieser Kette offen und kommerziell nutzbar.
Welches ist 2026 das beste LLM für die lokale Ausführung?
Wähle zuerst nach verfügbarem VRAM. Bei 8 GB: Qwen3.5-4B oder Gemma 4 E4B. Bei 16 GB: gpt-oss-20b (Apache 2.0, für 16 GB entwickelt) oder Gemma 4 12B. Bei 24 GB ist Qwen3.6-35B-A3B der Allrounder, den die meisten nutzen sollten. Für agentenbasierte Aufgaben mit Bildverarbeitung bietet sich Muse Glimmer 30B in 4-Bit an, während das quantisierte Gemma 4 31B die beste Wahl ist, wenn du das stärkste dichte Modell möchtest. Darüber hinaus ist DeepSeek-V4-Flash (284B, 13B aktiv) die kleinste Möglichkeit, auf einer Workstation einen Kontext von 1 Million Tokens zu erhalten. Alle diese Modelle stehen unter Apache 2.0 oder MIT und lassen sich mit Ollama oder LM Studio jeweils mit einem einzigen Befehl ausführen.
Ist es legal, KI-generierte Assets in einem kommerziellen Spiel zu verwenden?
Bei Open-Source-Modellen, die du selbst ausführst, ist das im Allgemeinen erlaubt. Es hängt jedoch von der Lizenz des Modells und deinen Annahmen zu den Trainingsdaten ab. Prüfe stets die jeweilige Modelllizenz und kennzeichne KI-generierte Inhalte, wenn die von dir verwendete Plattform dies verlangt. Unsere Vorgehensweise erläutern wir in unserer Richtlinie zu KI-generierten Inhalten.
Weitere Artikel
- KI-Kontroverse, Vertrauen und die Post-KI-Ökonomie: unsere Haltung zu KI in Spielen
- Richtlinie zu KI-generierten Inhalten: wie wir KI-Inhalte kennzeichnen
- Die besten KI-Videomodelle mit Unterstützung für Referenzbilder: gehostete Videomodelle im Vergleich
- Die besten KI-3D-Modellgeneratoren: die gehosteten Dienste Meshy, Tripo und Rodin im Vergleich mit offenen Modellen
- Technologie-Stack für Webspiele im Jahr 2026: WebGL, WebGPU und Wasm für Spiele
- Technologien für offene 3D-Welten im Browser: KI-generierte 3D-Assets in Browserwelten verwenden
- Landschaftsgenerierung für offene Browserwelten: diffusionsbasierte Geländesynthese
- Wo du kostenlose Spiel-Assets findest: klassische Asset-Quellen als Ergänzung zur KI-Generierung
- Agentenbasierte KI-Programmierwerkzeuge: KI zum Schreiben von Spielcode, nicht nur zum Generieren von Assets
Generative Modelle machen mehr Spaß, wenn ihre Ergebnisse spielbar sind.