Model AI Generatif Sumber Terbuka Terbaik untuk Game (2026)
Terakhir diperbarui: September 2026.
Begini situasi AI generatif. Selama bertahun-tahun, model-model terbaik tersembunyi di balik kunci API dan harga yang tidak dapat diprediksi. Anda membangun alur kerja di sekitar suatu alat, mulai terbiasa, lalu suatu pagi menerima email yang mengatakan bahwa harganya berubah. Atau lebih buruk lagi, perusahaannya beralih haluan sepenuhnya.
Hal itu berubah pada akhir 2024. Tencent, Alibaba, dan DeepSeek mulai merilis model yang benar-benar dapat Anda unduh. Model yang mampu menandingi alternatif tertutup. Dan tiba-tiba, kreator memiliki pilihan yang tidak bergantung pada model bisnis pihak lain.
Bagaimana jika Anda dapat membuat video, aset 3D, musik, dan suara, semuanya menggunakan model yang Anda kendalikan? Kini kita sudah sampai di titik tersebut. Panduan ini membahas apa yang benar-benar tersedia, apa yang berfungsi, dan apa yang dapat mulai Anda gunakan hari ini.
Pembuatan Video
Selama bertahun-tahun, pembuatan video identik dengan Runway atau Pika: platform tertutup, biaya langganan, dan batasan atas apa yang dapat Anda lakukan dengan hasilnya. Sekarang? Anda dapat menjalankan model sebanding pada perangkat keras sendiri.
Pembuatan teks-ke-video HunyuanVideo, keluaran 720p dari model video sumber terbuka terkemuka
| Model | Organisasi | Parameter | Spesifikasi | Perangkat Keras | Biaya |
|---|---|---|---|---|---|
| HunyuanVideo | Tencent | 13B | 720p, teks+gambar | 80GB | ~$0.20 |
| HunyuanVideo-1.5 | Tencent | 8.3B | 480p-1080p, teks+gambar | 14GB | ~$0.05 |
| Mochi 1 | Genmo | 10B | 480p@30fps | 12GB+ | ~$0.10 |
| LTX-Video | Lightricks | — | 768x512, waktu nyata | 12GB | ~$0.02 |
| LTX-2 / LTX-2.5 | Lightricks | 19B (2) / 22B (2.5) | 4K, audio tersinkronisasi, multishot di 2.5 | Kelas atas | ~$0.30 |
| Wan 2.1 | Alibaba | 1.3-14B | 480p-720p | 8GB+ | ~$0.03 |
| Wan 2.2 | Alibaba | 27B MoE (14B aktif) | 720p, MoE | 8GB+ | ~$0.03 |
| CogVideoX1.5-5B | Tsinghua | 5B | 1360x768@16fps, hingga 10 dtk | 12GB | ~$0.04 |
| SkyReels-V3 | Skywork | 14-19B | Berbasis audio, referensi-ke-video, V2V | Kelas atas | ~$0.10 |
| MiniMax H3 | MiniMax | 33B | 2K, 4-15 dtk, audio stereo, hingga 9 gambar referensi | Kelas atas | belum diuji |
| Step-Video-T2V | StepFun | 30B | T2V terbuka terbesar, 204 frame | Kelas atas | ~$0.15 |
| Open-Sora 2.0 | HPC-AI | 11B | Integrasi Flux | Kelas atas | ~$0.20 |
Bobot: HunyuanVideo ↗ · Mochi 1 ↗ · Wan 2.1 ↗ · Open-Sora ↗
Lihat sampel: Galeri HunyuanVideo ↗ · Contoh Mochi ↗ · Sampel CogVideoX ↗
Artinya bagi kreator
HunyuanVideo mengungguli Runway Gen-3 dalam evaluasi profesional dan sepenuhnya terbuka. Kekurangannya? Anda memerlukan perangkat keras yang serius. A100 atau H100 dengan VRAM 80GB. Bagi sebagian besar dari kita, itu berarti menyewa GPU cloud saat diperlukan.
HunyuanVideo-1.5 mengubah perhitungan kebutuhan perangkat keras. Tencent merilisnya pada November 2025 sebagai model terbuka dengan 8,3 miliar parameter yang berjalan pada GPU konsumen 14GB, menawarkan teks-ke-video dan gambar-ke-video pada 480p/720p serta peningkatan resolusi opsional ke 1080p. Mekanisme Selective and Sliding Tile Attention (SSTA) baru membuat kecepatan inferensinya kira-kira dua kali lipat dibandingkan HunyuanVideo asli. Jika Anda menginginkan kualitas HunyuanVideo tetapi tidak dapat membenarkan pembelian kartu 80GB, inilah versi yang benar-benar dapat dijalankan di rumah.
Mochi 1 adalah model yang benar-benar dapat Anda jalankan. GPU 12GB—kelas RTX 3060—mampu menanganinya dengan baik. Hasilnya benar-benar kreatif, dengan kualitas artistik yang khas. Fidelitasnya memang belum setara HunyuanVideo, tetapi seluruh prosesnya berada dalam kendali Anda.
LTX-2 adalah titik ketika segalanya mulai menarik bagi pengembangan game. Ini merupakan model terbuka pertama yang menghasilkan audio tersinkronisasi bersama video. Bayangkan cutscene dengan suara yang langsung... selaras. Tidak perlu sinkronisasi pascaproduksi. Lightricks membuka seluruh bobot, inferensi, dan kode pelatihannya pada Januari 2026, dengan keluaran 4K native hingga 50fps dan audio tersinkronisasi hingga 20 detik. Ada satu catatan lisensi: bobot terbuka LTX-2 dapat digunakan secara gratis untuk keperluan akademis dan untuk penggunaan komersial hanya oleh perusahaan dengan pendapatan tahunan di bawah $10 juta, jadi periksa ambang batas tersebut sebelum membangun bisnis di atasnya. Checkpoint terkini per September 2026 adalah LTX-2.5, model 22B yang menambahkan pembuatan multishot native (beberapa shot yang saling terhubung dengan karakter dan tampilan yang sama), decoder video difusi untuk menggantikan rekonstruksi VAE biasa, serta encoder teks Gemma 4 12B untuk prompt yang lebih panjang. Semuanya tetap berada di bawah LTX-2.x Community License, dengan batas pendapatan $10 juta yang sama dan kewajiban membuat perjanjian berbayar jika melampauinya.
SkyReels-V3 (Skywork, Januari 2026) adalah lini terbuka baru yang patut diperhatikan. Ini merupakan model multimodal terpadu yang mendukung video berbasis audio, referensi-ke-video, dan video-ke-video dalam varian 14B dan 19B, sehingga sangat cocok ketika Anda memerlukan karakter atau gambar referensi untuk mengarahkan shot. Step-Video-T2V (StepFun) adalah model teks-ke-video terbuka terbesar dengan 30B parameter dan dirilis di bawah lisensi MIT yang sederhana, sehingga layak dipertimbangkan jika lisensi permisif lebih penting bagi Anda daripada kemampuan menjalankannya pada GPU kecil.
MiniMax H3 (Hailuo 3.0) adalah pendatang terbuka terbaru dan model yang patut diperhatikan untuk cutscene berbasis referensi. MiniMax meluncurkannya sebagai API pada 31 Juli 2026 dan menempatkan bobot dasar 33B di Hugging Face pada Agustus dengan dua checkpoint: FL2VA untuk pembuatan frame pertama dan terakhir, serta Ref2VA, yang menerima hingga 9 gambar referensi, 3 klip video referensi, dan 3 klip audio (total 12 berkas), lalu menghasilkan video berdurasi 4 hingga 15 detik dengan resolusi hingga 2K dan audio stereo native. Model ini menggunakan MiniMax H3 Community License, dan kartu modelnya meminta pengguna di AS, UE, Inggris Raya, dan Korea Selatan untuk terlebih dahulu mengajukan formulir permohonan, sehingga model ini tidak dapat langsung digunakan oleh setiap studio.
Wan 2.1 berjalan pada laptop gaming. GPU 8GB sudah memadai untuk varian yang lebih kecil. Jika Anda ingin membuat prototipe dengan pembuatan video tetapi tidak dapat membenarkan kebutuhan perangkat kerasnya, inilah jalan masuknya.
Wan 2.2 (Alibaba, Juli 2025) adalah model video sumber terbuka pertama yang dibangun menggunakan desain Mixture-of-Experts: total 27B parameter dengan hanya 14B yang aktif pada setiap langkah. Model ini tersedia sebagai teks-ke-video (T2V-A14B), gambar-ke-video (I2V-A14B), serta varian hibrida 5B yang berjalan pada GPU konsumen, semuanya di bawah Apache 2.0 untuk penggunaan komersial.
Satu catatan penting: Wan 2.2 masih menjadi versi Wan terbuka terakhir. Wan 2.5 (September 2025), 2.6 (Desember 2025), 2.7 (April 2026), dan kini Wan 3.0 (Agustus 2026, dengan klip pengambilan tunggal berdurasi 30 detik hingga 1080p serta masukan referensi, menurut Alibaba Cloud Model Studio) yang lebih baru menambahkan audio tersinkronisasi, 1080p, dan kontrol frame yang lebih terperinci, tetapi hanya tersedia melalui API tanpa bobot publik. Per September 2026, organisasi Wan-AI di Hugging Face masih hanya menyediakan versi hingga 2.2, apa pun klaim situs afiliasi. Jika hosting mandiri penting bagi Anda, 2.2 adalah batas tertingginya. LTX-2.5 adalah model terbuka yang patut dipilih saat Anda membutuhkan 4K dan audio tersinkronisasi.
Alur kerja yang masuk akal: Mochi 1 atau Wan 2.1 untuk membuat prototipe secara lokal. HunyuanVideo-1.5 atau LTX-2.5 pada GPU cloud saat Anda membutuhkan kualitas akhir.
Pembuatan Gambar
Di sinilah sumber terbuka sudah menang. Model yang dapat Anda unduh saat ini benar-benar mampu bersaing dengan Midjourney. Bukan sekadar “hampir sama bagusnya”, tetapi benar-benar kompetitif.
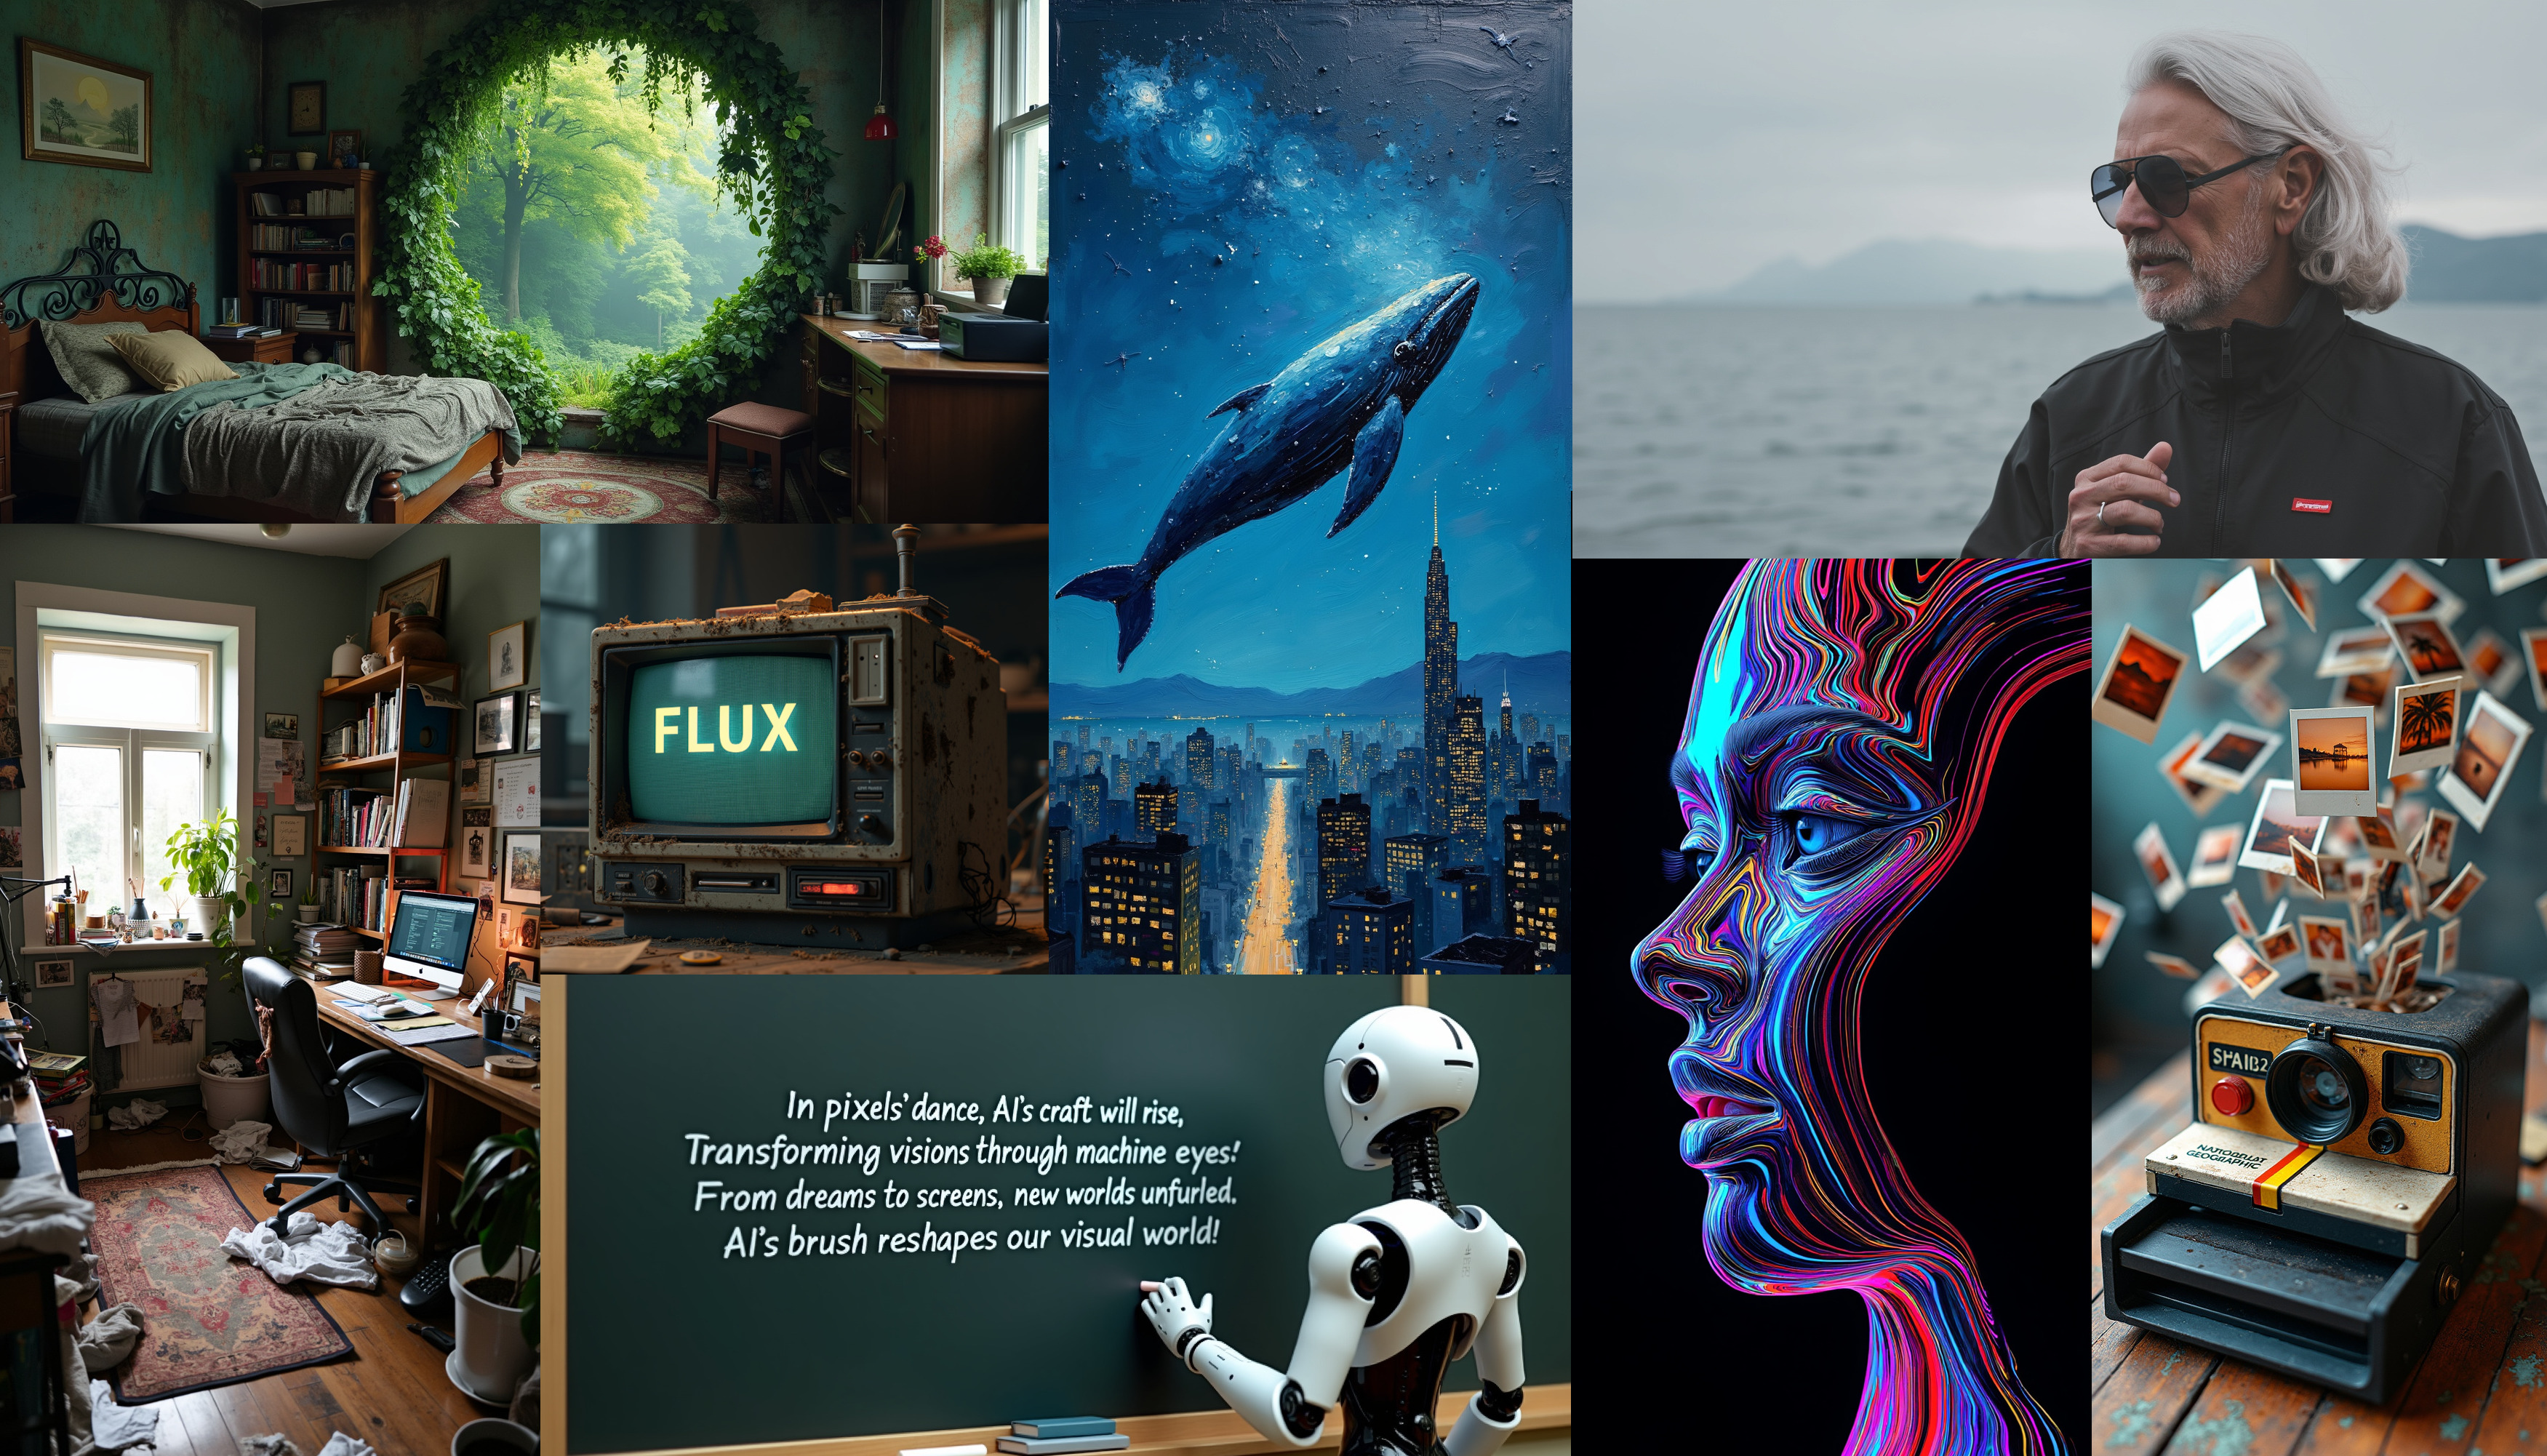 Sampel FLUX.1, kualitas fotorealistis dari model berlisensi Apache 2.0
| Model | Organisasi | Dirilis | Parameter | Fitur Utama | Lisensi | Biaya/gambar |
|---|---|---|---|---|---|---|
| FLUX.1 [schnell] | Black Forest Labs | Agu 2024 | 12B | Pembuatan 4 langkah, cepat | Apache 2.0 | ~$0.001 |
| FLUX.1 [dev] | Black Forest Labs | Agu 2024 | 12B | Kualitas mendekati Pro | Nonkomersial | ~$0.002 |
| SD 3.5 Large | Stability AI | Okt 2024 | 8B | Rendering teks, beragam gaya | Lisensi Stability | ~$0.002 |
| SD 3.5 Large Turbo | Stability AI | Okt 2024 | 8B | 4 langkah, cepat | Lisensi Stability | ~$0.001 |
| HiDream-I1 | HiDream.ai | Apr 2025 | 17B | Kualitas tinggi, varian Full/Dev/Fast | MIT | ~$0.002 |
| CogView4 | Tsinghua / Zhipu | Mar 2025 | 6B | Teks Mandarin native, hingga 2048px | Apache 2.0 | ~$0.002 |
| Qwen-Image | Alibaba | Agu 2025 | 20B | Rendering teks dan penyuntingan terbaik di kelasnya | Apache 2.0 | ~$0.002 |
| FLUX.2 | Black Forest Labs | Nov 2025 | 32B | Teks+penyuntingan, 4MP, multi-referensi | dev: Nonkomersial / klein 4B: Apache 2.0 | ~$0.003 |
| Ideogram 4.0 | Ideogram | Jun 2026 | 9.3B | Pekerjaan desain, rendering teks, kontrol tata letak JSON | Nonkomersial | ~$0.002 |
Coba langsung: Demo FLUX.1 schnell ↗ · Demo SD 3.5 Large ↗ · GitHub (FLUX) ↗
Lihat sampel: Galeri FLUX ↗ · Galeri FLUX LoRA ↗ · Contoh Replicate ↗
Untuk membuat aset game
FLUX.1 [schnell] adalah model yang perlu Anda kenal. Lisensi Apache 2.0 berarti Anda dapat merilis game komersial tanpa mengkhawatirkan kerumitan lisensi. Model ini menghasilkan gambar hanya dalam 4 langkah, sehingga Anda dapat melakukan iterasi dengan cepat. Jelaskan apa yang Anda inginkan, lihat hasilnya, sesuaikan, lalu ulangi.
SD 3.5 Large akhirnya mampu menangani rendering teks dengan benar. Versi-versi sebelumnya mengacaukan hampir semua teks yang coba disertakan. Ini penting untuk mockup UI, papan tulisan dalam game, layar judul, dan situasi apa pun yang membutuhkan kata-kata terbaca di dalam gambar.
FLUX.2 (Black Forest Labs, November 2025) adalah penerus yang lebih besar: model 32B yang menangani teks-ke-gambar dan penyuntingan gambar dalam satu checkpoint, dengan konsistensi karakter/gaya multi-referensi yang kuat serta rendering teks yang andal hingga 4 megapiksel. FLUX.2 [dev] dengan bobot terbuka menggunakan lisensi nonkomersial, tetapi FLUX.2 [klein] yang didistilasi ukurannya (Januari 2026) merilis versi 4B di bawah Apache 2.0, menghasilkan gambar dalam waktu kurang dari satu detik, dan berjalan dengan VRAM sekitar 8GB. Jadi, tetap tersedia opsi yang aman secara komersial untuk merilis karya seni game. Pilih khusus versi klein 4B: klein 9B yang lebih besar tetap menggunakan lisensi FLUX nonkomersial. Pipeline terkuantisasi memungkinkan [dev] berjalan pada GPU 18-24GB. Generasi berikutnya dari Black Forest Labs, FLUX 3, adalah model gabungan gambar, video, dan audio yang diumumkan pada 23 Juli 2026. Per September 2026, model tersebut hanya tersedia melalui API: video dengan audio tersinkronisasi diluncurkan sebagai pratinjau pada 4 Agustus, sedangkan FLUX 3 Dev dengan bobot terbuka “direncanakan hadir kemudian pada 2026” menurut catatan rilis BFL. Hingga model tersebut tersedia, klein 4B tetap menjadi FLUX yang aman untuk penggunaan komersial.
Ada dua opsi terbuka lain yang patut diketahui. Chroma1-HD (8.9B, Apache 2.0) merupakan turunan FLUX.1-schnell yang sepenuhnya terbuka, sehingga menjadi cara yang aman secara komersial untuk memperoleh kualitas keluarga FLUX tanpa lisensi [dev]. OmniGen2 (Apache 2.0) adalah model terpadu yang mendukung teks-ke-gambar sekaligus penyuntingan berbasis instruksi dalam satu tempat. Ini merupakan jalur tercepat ketika Anda sedang mengiterasi aset yang sudah ada (“buat pedangnya bersinar biru”), alih-alih membuatnya dari awal.
Qwen-Image (Alibaba, Agustus 2025) adalah model terbuka yang patut dipilih ketika karya seni Anda membutuhkan teks yang dapat dibaca, seperti papan tanda, UI, poster, atau label item. Ini adalah model 20B berlisensi Apache 2.0 dengan rendering teks terbaik di kelasnya serta varian penyuntingan berbasis instruksi yang kuat. Karena itu, model ini aman secara komersial dan luar biasa bagus dalam menangani aspek yang masih sering gagal dikerjakan oleh kebanyakan model gambar. Pembaruan Desember 2025, Qwen-Image-2512, meningkatkan ketajaman realisme manusia dan tata letak teks sekaligus mempertahankan lisensi Apache 2.0, jadi gunakan checkpoint tersebut jika Anda melakukan hosting mandiri. Qwen-Image-2.0 yang lebih baru (Februari 2026) hanya tersedia melalui API, dan per September 2026 repositori QwenLM masih mencantumkan Qwen-Image-2512 dan Qwen-Image-Edit-2511 sebagai checkpoint terbaru dengan bobot publik. Ideogram 4.0 (Juni 2026) adalah rilis berbobot terbuka pertama dari Ideogram: diffusion transformer 9,3B yang dibuat untuk pekerjaan desain, dengan rendering teks multibahasa yang kuat serta kontrol tata letak dan warna secara eksplisit melalui prompt JSON terstruktur. Ada satu hal yang perlu diperhatikan sebelum Anda menggunakannya: kode inferensinya berlisensi Apache 2.0, tetapi bobotnya memakai lisensi nonkomersial, sehingga model ini hanya cocok untuk riset dan pembuatan prototipe kecuali Anda membeli lisensi komersialnya.
Ekosistem di sekitar Stable Diffusion masih belum tertandingi. ControlNet untuk komposisi presisi. Inpainting untuk perbaikan. Fine-tuning LoRA untuk gaya khusus. FLUX mulai menyusul, tetapi jika Anda membutuhkan kustomisasi mendalam saat ini, kematangan perangkat SD memberi Anda lebih banyak pilihan.
Begini cara saya melihatnya: untuk tekstur dan sprite, keduanya bisa digunakan. Untuk seni konsep dengan persyaratan gaya tertentu, gunakan SD 3.5 dengan LoRA. Untuk kualitas terbaik pada produk komersial yang akan dirilis, gunakan FLUX schnell.
Pembuatan 3D
Jika Anda pernah menghabiskan delapan jam untuk memodelkan sebuah properti yang hanya muncul selama tiga detik dalam gim, bagian ini cocok untuk Anda. Pembuatan 3D sudah beralih dari "riset menarik" menjadi alat produksi sungguhan sejak beberapa waktu lalu, dan pada 2026 model terbukanya sudah benar-benar bagus. Anda bisa mengubah sketsa menjadi mesh bertekstur dalam waktu kurang dari satu menit.
Halaman ini membahas model terbuka yang dapat Anda host sendiri. Jika Anda sedang memilih alat, bukan model, panduan generator model 3D AI terbaik kami membandingkan opsi yang di-host (Meshy, Tripo, Rodin, Hi3D) dengan opsi terbuka, lengkap dengan harga dan hak komersial masing-masing.
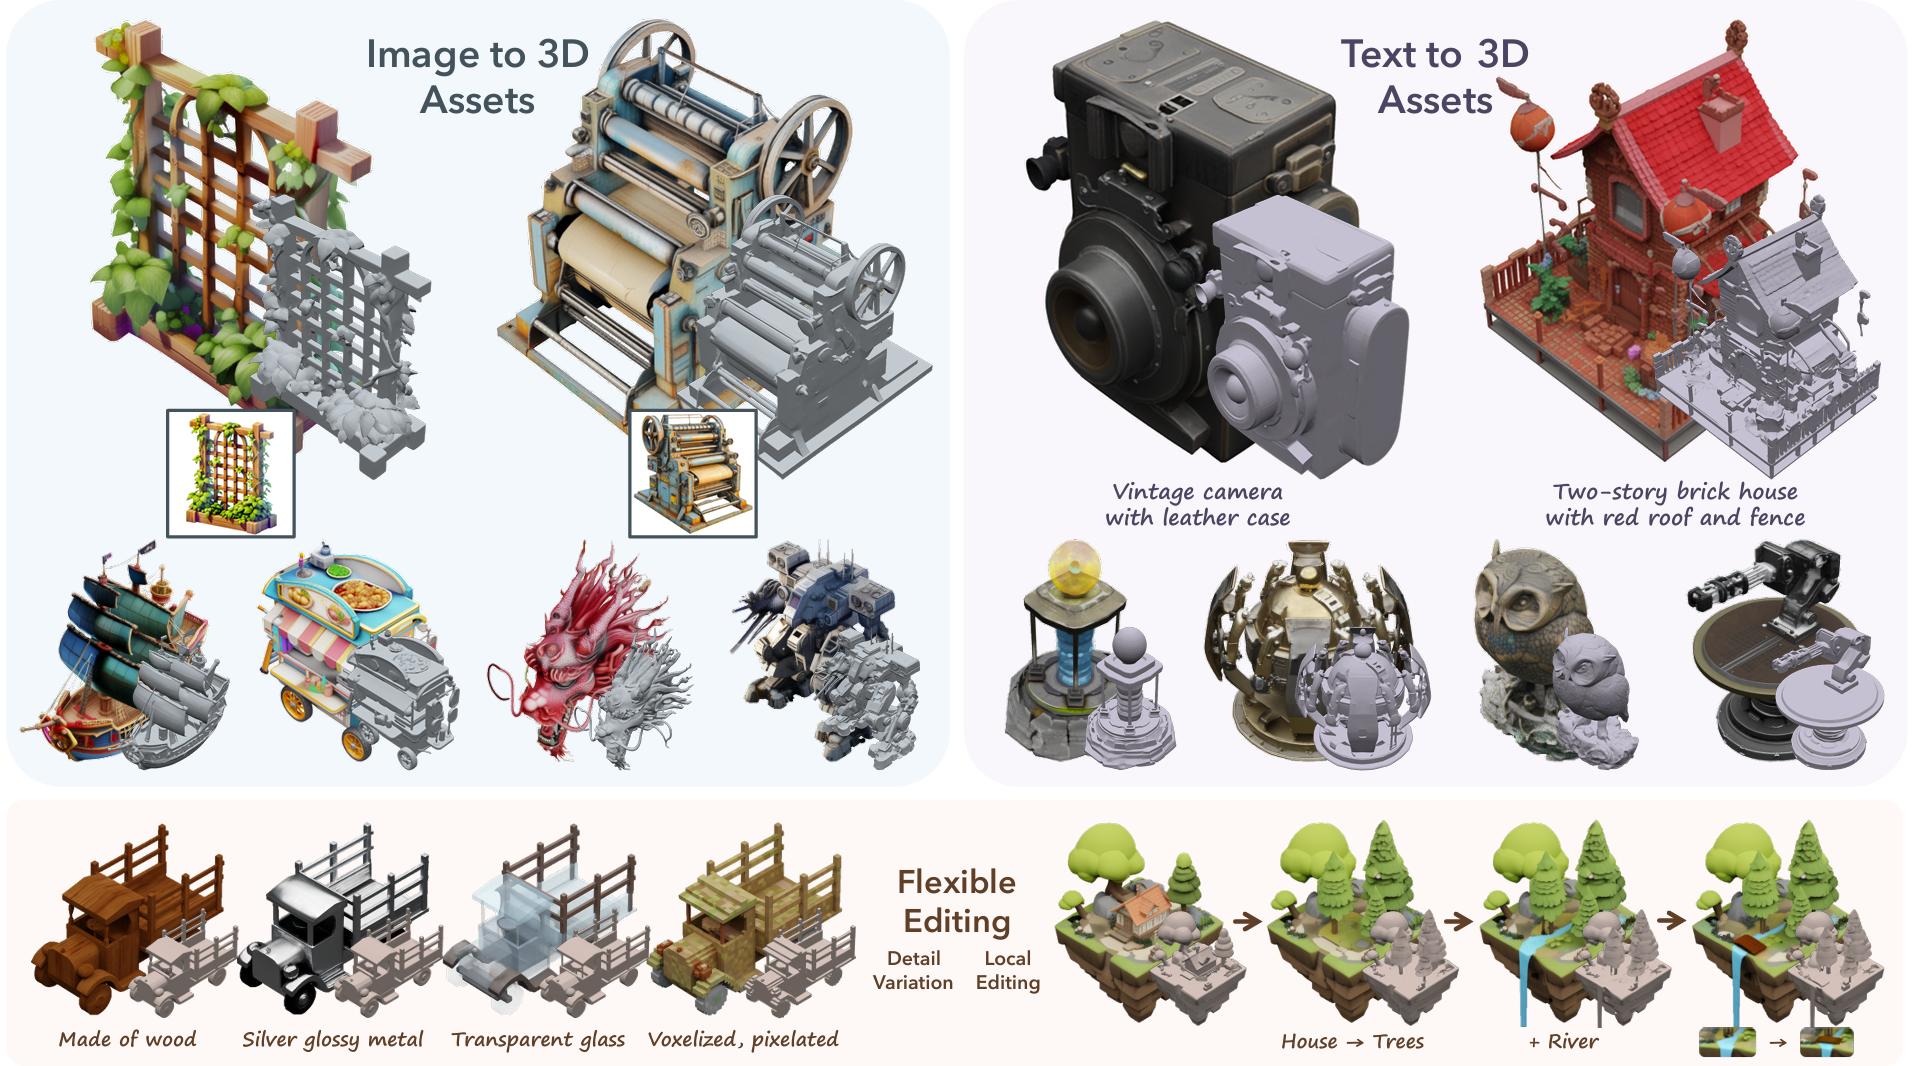 TRELLIS menghasilkan mesh 3D bertekstur dengan material PBR dari satu gambar
| Model | Organisasi | Dirilis | Fitur Utama | Keluaran | Biaya/mesh |
|---|---|---|---|---|---|
| TRELLIS.2-4B | Microsoft | Des 2025 | 4B parameter, PBR bawaan, hingga 1536³ | Mesh bertekstur dengan normal | ~$0.03 |
| Hunyuan3D 2.1 | Tencent | Jun 2025 | PBR kelas produksi, bobot lengkap + kode pelatihan | Mesh bertekstur beresolusi tinggi | ~$0.05 |
| SAM 3D | Meta | Nov 2025 | Satu gambar menjadi 3D (objek + tubuh manusia) | Mesh dari satu foto | ~$0.02 |
| Stable Fast 3D | Stability AI | Agu 2024 | Satu gambar → mesh dalam ~0,5 dtk | Mesh bertekstur cepat | ~$0.001 |
| TripoSG | VAST-AI | Mar 2025 | Pembuatan bentuk rectified-flow 1,5B | Mesh berkualitas tinggi | ~$0.01 |
| TripoSR | Stability / Tripo | 2024 | Rekonstruksi cepat dari satu gambar | Mesh (tanpa tekstur) | ~$0.001 |
| UniRig | Tsinghua / Tripo | 2025 | Rig otomatis: kerangka + bobot skinning | Mesh dengan rig yang dapat dianimasikan | ~$0.01 |
Coba langsung: Demo TRELLIS.2 ↗ · Demo Hunyuan3D ↗ · Demo InstantMesh ↗
Lihat contoh: Halaman proyek TRELLIS.2 ↗ · Galeri 3D AI Studio ↗
Alur kerja yang benar-benar efektif
Pendekatan yang mulai cocok bagi kreator saat ini adalah merangkai beberapa model. Mulailah dengan sebuah gambar, baik hasil generasi maupun foto, tidak masalah. Proses gambar itu melalui Stable Zero123 atau Wonder3D untuk mendapatkan beberapa sudut pandang. Masukkan sudut pandang tersebut ke InstantMesh atau TripoSR untuk membuat mesh. Kemudian gunakan TRELLIS.2 atau Hunyuan3D untuk menghasilkan material yang tepat.
TRELLIS.2 dari Microsoft adalah pemimpin baru untuk aset siap produksi. Model ini mampu menangani geometri yang membuat model lain gagal: permukaan tipis, lubang, dan topologi kompleks. Versi 4B parameter menghasilkan mesh dengan tekstur PBR sungguhan, bukan sekadar warna verteks yang berpura-pura menjadi material.
Stable Fast 3D mengutamakan kecepatan. Hanya sekitar setengah detik dari gambar menjadi mesh. Mesh-nya masih perlu dirapikan dan diberi tekstur, tetapi untuk pembuatan prototipe? Untuk mengetahui apakah sebuah ide berhasil sebelum Anda menginvestasikan waktu berjam-jam? Tak tertandingi. TripoSG adalah peningkatan berikutnya jika Anda menginginkan geometri yang lebih bersih dari satu gambar.
Hunyuan3D 2.1 adalah model terbuka Tencent yang layak digunakan: model ini menyediakan bobot lengkap dan kode pelatihan dengan tekstur PBR kelas produksi. Perhatikan penamaannya karena sering membingungkan orang. Hunyuan3D 2.5, 3.0, dan 3.1 memang ada, tetapi semuanya hanya tersedia melalui API tanpa bobot publik. Jadi, untuk hosting mandiri, generator dasarnya masih berhenti di versi 2.1 (sebuah utas GitHub yang menanyakan kepada Tencent tentang rencana membuka sumber 2.5 belum mendapat jawaban hingga September 2026). Jika Anda lebih suka mencobanya daripada melakukan hosting sendiri, generator 3D kami menjalankan Hunyuan3D di peramban. Tencent juga membuka dua ekstensi berguna yang dibuat berdasarkan 2.1: Hunyuan3D-Omni menambahkan kontrol multikondisi (point cloud, voxel, kerangka, bounding box), sedangkan Hunyuan3D-Part memecah mesh menjadi bagian-bagian yang dapat diedit. Lisensinya juga mengecualikan Uni Eropa, Inggris, dan Korea Selatan, jadi periksa ketentuannya sebelum merilis produk di wilayah tersebut.
SAM 3D (Meta, November 2025) adalah cara terbaru untuk memulai: satu foto diubah menjadi mesh 3D, dengan model terpisah untuk objek dan tubuh manusia. Jika digabungkan dengan teknologi segmentasi Meta, Anda dapat mengisolasi objek dalam gambar dan hanya merekonstruksi objek tersebut.
UniRig (Tsinghua dan Tripo, MIT) mengatasi kendala yang dihadapi semua orang tepat setelah mendapatkan mesh: rigging. Model ini otomatis menghasilkan kerangka yang valid dan bobot skinning untuk mesh masukan, sehingga karakter hasil generasi benar-benar dapat dianimasikan alih-alih hanya diam sebagai properti statis. Padukan dengan teknologi animasi otomatis SOMA-X dari NVIDIA, dan karakter yang sepenuhnya dihasilkan sekaligus memiliki rig lengkap tidak lagi sekadar demo riset.
Berikut ekspektasi realistis bagi kreator indie: buat seni konsep dengan FLUX, proses melalui InstantMesh untuk menghasilkan geometri, lalu beri tekstur di Blender atau gunakan TRELLIS untuk PBR otomatis. Anda hanya memerlukan 30–60 menit per aset, bukan 4–8 jam. Memang bukan tanpa waktu sama sekali, tetapi perbedaannya nyata.
Audio dan Musik
Pembuatan audio belum menyamai gambar dan video. Namun, sudah ada cukup banyak teknologi yang dapat mengubah cara Anda bekerja, terutama untuk pembuatan prototipe dan efek suara.
Contoh musik yang dihasilkan AI. Jelaskan suasana yang Anda inginkan, lalu dapatkan musik yang sesuai
| Model | Organisasi | Dirilis | Fungsinya | Lisensi | Biaya/30 dtk |
|---|---|---|---|---|---|
| ACE-Step 1.5 | StepFun/ACE Studio | Jan 2026 | Musik ~4 menit dengan cepat, 19 bahasa, kloning suara | MIT | ~$0.02 |
| Stable Audio 3.0 | Stability AI | Mei 2026 | Lagu hingga ~6 menit; model terbuka Small, Small-SFX + Medium | Stability Community | ~$0.02 |
| YuE | MAP | Jan 2025 | Lagu lengkap dari lirik, vokal + iringan | Apache 2.0 | ~$0.05 |
| MusicGen | Meta | 2023 | Teks menjadi musik, dapat dikontrol | kode MIT / bobot CC-BY-NC | ~$0.01 |
| DiffRhythm 2 | ASLP-lab | Feb 2026 | Pembuatan lagu lengkap dengan cepat | Apache 2.0 | ~$0.02 |
| Magenta RealTime | Jun 2025 | Musik waktu nyata yang dapat diarahkan dengan prompt | kode Apache / bobot CC-BY | ~$0.02 |
Coba langsung: Demo MusicGen ↗ · Arena uji AudioCraft ↗
Lihat contoh: Contoh MusicGen ↗ · Contoh AudioGen ↗
Yang benar-benar bisa Anda gunakan dalam produk
MusicGen dari Meta masih menjadi pilihan praktis untuk membuat prototipe audio gim. Jelaskan suasana yang Anda inginkan, dapatkan musik yang sesuai, dan model ini berjalan lancar di GPU 12 GB. Ada satu kendala lisensi: kode MusicGen berlisensi MIT, tetapi bobot modelnya memakai CC-BY-NC (nonkomersial). Jadi, gunakan untuk membuat prototipe, lalu beralihlah ke model berlisensi komersial seperti ACE-Step atau Stable Audio untuk produk yang akan Anda rilis.
Model efek suara terbuka Stable Audio (Small-SFX) mampu menangani suara langkah kaki, derit pintu, embusan angin, dan suara mekanis, dapat dijalankan secara lokal, serta dirilis di bawah lisensi komunitas Stability. Karena itu, model ini menjadi opsi SFX terbuka yang patut dipilih saat Anda membutuhkan suara yang benar-benar dapat digunakan secara komersial. Model ini layak dipilih karena model SFX terbuka lainnya memiliki batasan: AudioGen dari Meta menggunakan CC-BY-NC dan TangoFlux memakai lisensi komunitas nonkomersial Stability, sehingga keduanya hanya cocok untuk prototipe gim yang akan dirilis.
Magenta RealTime (Google) berbeda dari yang lain dalam arti terbaik: ini satu-satunya model berbobot terbuka yang dibuat untuk musik waktu nyata dan dapat terus diarahkan melalui prompt. Alih-alih merender trek yang sudah selesai, model ini menghasilkan musik secara langsung dan memungkinkan Anda mengarahkannya selagi diputar. Bentuk ini sangat cocok untuk soundtrack gim adaptif yang berubah mengikuti tindakan pemain. Kodenya berlisensi Apache 2.0 dan bobotnya CC-BY, keduanya dapat digunakan secara komersial.
YuE benar-benar menarik. Ini adalah model terbuka pertama yang menghasilkan lagu lengkap dengan vokal. Lagu tema. Musik latar dengan nyanyian sungguhan. Kualitasnya bervariasi, tetapi jauh melampaui apa pun yang bisa Anda unduh dan jalankan sendiri.
ACE-Step adalah model musik terbuka yang perlu Anda kenal sekarang, dan perkembangannya sangat cepat: lini 1.5 (Januari 2026, dengan varian XL 5B yang lebih besar) menggantikan rilis awal Mei 2025 dan kini berlisensi MIT. Model ini dapat menghasilkan musik berdurasi beberapa menit dengan cepat, mendukung 19 bahasa, serta menangani kloning suara, remix, dan penyuntingan lirik. Untuk pembuatan prototipe gim, model ini menutup banyak kekurangan yang ditinggalkan YuE dan MusicGen.
Stable Audio 3.0 (Mei 2026) merupakan pembaruan yang lebih besar untuk suara. Model ini dapat menghasilkan lagu hingga sekitar enam menit, dan Stability merilis bobot terbuka untuk tiga dari empat variannya: Small dan model efek suara khusus Small-SFX dapat dijalankan langsung di perangkat, sedangkan Medium menawarkan struktur musik yang lebih baik dan durasi trek penuh. Hanya model Large yang tetap tersedia melalui API saja. Small-SFX kini menjadi opsi terbuka terkuat khusus untuk SFX gim. Ketiga model terbuka tersebut dirilis di bawah Stability AI Community License, yang mengizinkan Anda menggunakan dan menjual hasil generasinya, dengan Enterprise License untuk perusahaan berpendapatan tahunan di atas $1 juta, menurut pengumuman Stability. Seluruh keluarga model ini dilatih menggunakan data berlisensi, sehingga dasar hukumnya lebih jelas dibandingkan generator musik yang masih menghadapi gugatan hukum.
Kesimpulan jujurnya: kesenjangan antara model terbuka dan model tertutup (Suno, Udio) semakin menyempit, tetapi masih nyata untuk lagu lengkap dengan vokal. Alat-alat tertutup tersebut juga masih menghadapi sengketa hukum terkait data pelatihan. Untuk efek suara, model terbuka—terutama model SFX Stable Audio—benar-benar kompetitif. Untuk lagu yang ingin Anda gunakan dalam produk, bersiaplah melakukan banyak iterasi, atau libatkan musisi untuk produksi akhir dan gunakan alat-alat ini untuk pekerjaan lainnya.
Tuturan dan Suara
Pembuatan suara kini sudah jauh melampaui taraf "cukup bagus untuk gim", dan hal itu mengubah apa yang mungkin dilakukan oleh tim kecil.
Narasi gim hasil AI dengan tuturan alami, tempo yang tepat, dan emosi
| Model | Organisasi | Dirilis | Fitur Utama | Lisensi | Biaya/menit |
|---|---|---|---|---|---|
| Qwen3-TTS | Alibaba | Jan 2026 | Kloning suara 3 dtk, desain suara, 10 bahasa | Apache 2.0 | ~$0.002 |
| Chatterbox | Resemble AI | 2025 | Kontrol emosi, kloning dari ~5 dtk, 23 bahasa | MIT | ~$0.003 |
| CSM | Sesame AI | Mar 2025 | Alur percakapan, jeda alami | Apache 2.0 | ~$0.005 |
| Fish Speech 1.5 | Fish Audio | 2024 | Kloning zero-shot dari 10–30 dtk | kode Apache / bobot CC-BY-NC-SA | ~$0.002 |
| OpenVoice V2 | MyShell/MIT | Apr 2024 | Kontrol emosi/aksen | MIT | ~$0.003 |
| XTTS-v2 | Coqui (komunitas) | 2024 | 17 bahasa, kloning suara | CPML (nonkomersial) | ~$0.005 |
Dengarkan contoh: Suara Fish Audio ↗ · Demo OpenVoice ↗
Membuat NPC terdengar seperti manusia
CSM (Conversational Speech Model) dari Sesame dibuat khusus untuk dialog. Model ini menghasilkan jeda alami. Perubahan intonasi. Ritme percakapan sungguhan. Sebagian besar TTS terdengar seperti seseorang sedang membaca naskah, dan Anda bisa langsung mengenalinya. CSM terdengar seperti seseorang yang sedang berbicara. Perbedaan itu lebih penting daripada yang mungkin Anda kira.
Qwen3-TTS (Alibaba, Januari 2026) adalah pilihan utama untuk proyek komersial. Seluruh keluarga modelnya berlisensi Apache 2.0, mampu mengkloning suara dari audio referensi berdurasi sekitar 3 detik, berbicara dalam 10 bahasa, dan mendukung desain suara berbasis deskripsi. Jadi, Anda dapat menentukan suara NPC menggunakan teks biasa alih-alih mencari rekaman referensi. Model 0.6B dan 1.7B dapat dijalankan pada perangkat keras kelas menengah. Chatterbox (Resemble AI) adalah pilihan untuk suara ekspresif, dan berlisensi MIT sehingga dapat digunakan dalam produk yang dirilis. Model ini dapat mengkloning suara dari rekaman sekitar 5 detik, berjalan dengan latensi di bawah 200 md, mendukung 23 bahasa, dan merupakan model terbuka pertama dengan kontrol penguatan emosi. Dengan demikian, NPC benar-benar dapat terdengar marah atau takut, bukan datar. Dua opsi Apache-2.0 lainnya mengisi ceruk tertentu: Orpheus (Canopy) menerima tag emosi inline seperti <laugh> dan <sigh> yang mudah dipetakan ke seruan singkat NPC serta menyediakan varian 150M untuk perangkat kelas bawah, sedangkan Dia (Nari Labs) dibuat untuk dialog dengan beberapa penutur dan dapat menyertakan suara nonverbal seperti batuk dan tawa dalam satu proses. Voxtral TTS dari Mistral (Maret 2026) adalah pendatang baru dengan bobot terbuka yang ditujukan untuk agen suara, menurut halaman berita Mistral, tetapi baca lisensinya sebelum menggunakannya dalam produk yang dirilis.
Fish Speech dan OpenVoice menangani kloning suara. Rekam suara pengisi suara selama 10–30 detik, lalu hasilkan dialog tanpa batas dengan suara tersebut. Pertimbangkan artinya: Anda dapat menyewa pengisi suara untuk dialog utama, lalu memperluas penampilannya agar mencakup ratusan variasi dan dialog latar. Satu catatan tentang lisensi Fish Speech: kodenya terbuka, tetapi bobot versi 1.5 menggunakan CC-BY-NC-SA, sehingga hanya cocok sebagai alat pembuatan prototipe. Untuk gim yang dirilis, gunakan OpenVoice (MIT) atau Qwen3-TTS (Apache 2.0).
NVIDIA ACE (tidak sepenuhnya terbuka, tetapi patut diketahui) kini mendukung Qwen3-8B untuk menjalankan NPC langsung di perangkat. LLM lokal + TTS lokal + sinkronisasi bibir, semuanya berjalan pada GPU konsumen. Ini adalah rangkaian teknologi untuk percakapan NPC waktu nyata yang tidak memerlukan panggilan ke layanan cloud.
Pendekatan yang masuk akal bagi kreator indie: pekerjakan pengisi suara untuk karakter utama dan dialog yang paling penting. Gunakan Qwen3-TTS atau OpenVoice untuk memperluas cakupan dialog latar, variasi, dan semua dialog sampingan yang jika tidak akan tetap tanpa suara atau terlalu mahal untuk diproduksi.
Model Dunia dan Simulasi Gim
Di sinilah semuanya menjadi benar-benar aneh sekaligus benar-benar menarik. Model-model ini tidak menghasilkan aset statis. Model tersebut menghasilkan pengalaman yang terasa seperti gim.
🎮 Mainkan Oasis: Minecraft Buatan AIPembuatan dunia waktu nyata tanpa mesin gim, hanya prediksi AI
| Model | Organisasi | Dirilis | Fungsinya | Status | Biaya/frame |
|---|---|---|---|---|---|
| DIAMOND | Riset | 2024 | Model dunia difusi, simulasi Atari | Bobot terbuka | ~$0.001 |
| Oasis | Decart/Etched | Okt 2024 | Pembuatan Minecraft waktu nyata | Bobot 500M terbuka | ~$0.002 |
| MineWorld | Microsoft | Apr 2025 | Minecraft waktu nyata, alternatif terbuka untuk Oasis | MIT | ~$0.002 |
| Hunyuan-GameCraft | Tencent | Agu 2025 | Video gim interaktif, kontrol papan ketik/tetikus | Tencent Community | ~$0.005 |
| GameGen-X | Riset | 2024 | Pembuatan video dunia terbuka | Kode + set data terbuka | ~$0.005 |
| NVIDIA Cosmos | NVIDIA | Okt 2025 | Simulasi AI fisik (Predict2.5) | NVIDIA Open Model License | ~$0.01 |
| Matrix-Game 3.0 | Skywork | Mar 2026 | Dunia interaktif 720p waktu nyata, memori jangka panjang | Bobot terbuka | ~$0.005 |
| Genie 2 | DeepMind | Des 2024 | 3D interaktif dari gambar | Belum dirilis | T/A |
| Genie 3 | DeepMind | Agu 2025 | Dunia 720p waktu nyata, peristiwa yang dapat dipicu dengan prompt | Tertutup (Project Genie) | T/A |
Lihat risetnya: Halaman proyek DIAMOND ↗ · Blog Cosmos ↗
Cobalah: Demo langsung Oasis ↗ · Contoh Genie 2 ↗
Mengapa Anda perlu memperhatikan ini
DIAMOND membuktikan sesuatu yang mengubah cara kita memandang AI untuk gim. Anda dapat melatih agen sepenuhnya di dalam dunia yang dihasilkan. Pelatihan bahkan tidak memerlukan mesin gim sungguhan. AI bermain di dalam imajinasi model difusi, lalu mentransfer hasil pembelajarannya ke gim sungguhan. Implikasinya sangat besar.
Oasis menjalankan dunia mirip Minecraft secara waktu nyata. Frame demi frame. Tanpa mesin gim, tekstur, atau aset siap pakai. Hanya transformer yang memprediksi apa yang akan terjadi berikutnya. Ini masih berupa pembuktian konsep, tetapi bayangkan arah perkembangannya. Versi dengan 500 juta parameter sudah tersedia secara terbuka.
GameGen-X merilis set data terbesar untuk video gim dunia terbuka. Jika ingin melatih model sendiri atau menyempurnakan model yang sudah ada agar menghasilkan konten mirip gim, inilah titik awalnya.
NVIDIA Cosmos dibuat untuk robotika dan kendaraan otonom, tetapi model fondasi dunianya juga dapat digunakan untuk gim. Model ini memahami fisika, kekekalan objek, dan hubungan spasial. Lini terbuka saat ini adalah Cosmos-Predict2.5, yang dirilis pada Oktober 2025 dengan NVIDIA Open Model License dan mengizinkan penggunaan komersial serta karya turunan.
Hunyuan-GameCraft (Tencent, Agustus 2025) adalah model dunia terbuka yang bentuknya paling menyerupai gim secara langsung. Model ini dilatih menggunakan lebih dari satu juta rekaman dari lebih dari 100 gim AAA dan menyatukan masukan papan ketik serta tetikus ke dalam ruang kontrol bersama. Dengan demikian, model ini menghasilkan video gim interaktif yang benar-benar dapat Anda kendalikan, bukan sekadar ditonton. Model ini menggunakan Tencent Community License yang sama seperti Hunyuan3D, termasuk pengecualian untuk UE, Britania Raya, dan Korea Selatan. Jadi, periksa ketentuannya sebelum merilis produk di wilayah tersebut. MineWorld (Microsoft, MIT) adalah padanan Oasis dengan lisensi yang sepenuhnya permisif: model dunia Minecraft waktu nyata yang dapat diunduh dan dijalankan tanpa mesin gim.
Genie 3 (DeepMind, diumumkan Agustus 2025) adalah lompatan yang patut diperhatikan: model dunia pertama dengan interaksi waktu nyata, yang menghasilkan dunia 720p pada 24 fps yang dapat dijelajahi dan tetap konsisten selama beberapa menit, ditambah 'peristiwa dunia yang dapat dipicu dengan prompt' untuk mengubah cuaca atau menambahkan objek sesuai perintah. Model ini dibuka untuk publik sebagai Project Genie pada Januari 2026 bagi pelanggan Google AI Ultra di AS. Bobotnya masih tertutup, tetapi model ini menunjukkan arah perkembangan dunia buatan yang dapat dimainkan.
Matrix-Game 3.0 (Skywork, Maret 2026) adalah jawaban terbuka untuk Genie. Ini merupakan model dunia interaktif dengan dukungan memori yang menyiarkan video 720p pada 40 fps secara waktu nyata dan mempertahankan konsistensi adegan dalam rangkaian berdurasi beberapa menit. Versi terdistilasi 5B menangani inferensi waktu nyata, versi MoE 2x14B yang lebih besar meningkatkan kualitas, dan bobotnya tersedia di Hugging Face dengan lisensi Apache 2.0. Jika Anda ingin bereksperimen dengan dunia buatan yang dapat dimainkan sekarang juga alih-alih menunggu DeepMind, inilah model yang benar-benar dapat diunduh.
Untuk pengembangan gim praktis saat ini, semua ini masih merupakan alat riset. Namun, jika Anda mengerjakan konten berbasis AI, pembuatan prosedural, atau sekadar memikirkan arah perkembangan teknologi ini, inilah garis terdepannya.
Model Bahasa Besar
LLM menggerakkan dialog, pembuatan misi, dan logika gim. Kini, opsi terbuka benar-benar mampu bersaing dengan GPT-4. Dua tahun lalu, hal ini belum terjadi.
| Model | Organisasi | Dirilis | Ukuran | Paling Cocok Untuk | Lisensi | Biaya/1K token |
|---|---|---|---|---|---|---|
| DeepSeek-V3 | DeepSeek | Des 2024 | 671B MoE (37B aktif) | Penalaran, penggunaan umum | Permisif | ~$0.02 |
| DeepSeek-R1 | DeepSeek | Jan 2025 | Berdasarkan V3 | Rantai pemikiran | Permisif | ~$0.03 |
| DeepSeek-V3.2 | DeepSeek | Des 2025 | Atensi jarang (DSA) | Penalaran + penggunaan alat | MIT | ~$0.02 |
| DeepSeek-V4 | DeepSeek | Apr 2026 | 1.6T MoE (49B aktif) | Penalaran terdepan, konteks 1M | MIT | ~$0.02 |
| GLM-5 | Zhipu / Z.ai | Feb 2026 | 744B MoE (40B aktif) | Pemrograman, agen, penggunaan alat | MIT | ~$0.02 |
| GLM-5.2 | Zhipu / Z.ai | Jun 2026 | 753B MoE | Pemrograman, agen, konteks 1M | MIT | ~$0.02 |
| GPT-OSS | OpenAI | Agu 2025 | 120B / 20B MoE | Penalaran, penggunaan alat, di perangkat | Apache 2.0 | ~$0.01 |
| Kimi K2 | Moonshot | 2025 | 1T MoE (32B aktif) | Agen, pemrograman | MIT yang dimodifikasi | ~$0.02 |
| Kimi K3 | Moonshot | Jul 2026 | 2.8T MoE (16 dari 896 pakar aktif) | Agen terdepan, pemrograman, konteks 1M, visi | Kimi K3 License | ~$0.03 |
| Hy3 | Tencent | Jul 2026 | 295B MoE (21B aktif) | Penalaran, pemrograman berbasis agen, konteks 256K | Apache 2.0 | ~$0.02 |
| Gemma 3 | 2025 | 1B-27B | Di perangkat, 140 bahasa, visi | Gemma | ~$0.01 | |
| Gemma 4 | Apr 2026 | E2B hingga 31B (26B-A4B MoE) | Di perangkat, 140+ bahasa, visi + audio, 256K | Apache 2.0 | ~$0.01 | |
| Qwen3 | Alibaba | 2025 | 235B MoE (22B aktif) | Multibahasa, kode | Apache 2.0 | ~$0.01 |
| Qwen3.5 / 3.6 / 3.8 | Alibaba | Feb-Agu 2026 | 0.8B hingga 2.4T-A95B | Multimodal, agen, model unggulan terbuka sekelas Qwen-Max | Apache 2.0 | ~$0.02 |
| Mistral Small 4 | Mistral | Mar 2026 | 119B MoE (6B aktif) | Penalaran + visi + pemrograman berbasis agen, 256K | Apache 2.0 | ~$0.01 |
| Qwen3-Coder | Alibaba | 2025 | 480B MoE (35B aktif) | Pemrograman berbasis agen, konteks 256K | Apache 2.0 | ~$0.02 |
| Llama 4 | Meta | 2025 | Beragam | Agen, konteks hingga 10M | Llama Community | ~$0.01 |
| Muse Glimmer 30B | Meta | Agu 2026 | ~30B padat | Agen di perangkat, visi, konteks 128K+ | Apache 2.0 | ~$0.01 |
| Qwen3-VL | Alibaba | 2025 | 2B-235B | Visi + bahasa | Apache 2.0 | ~$0.02 |
| InternVL3 | Shanghai AI Lab | 2025 | 1B-78B | Visi, OCR, pemetaan elemen UI | MIT | ~$0.02 |
Mulai di sini: Qwen3-8B di HuggingFace ↗ · DeepSeek-V3 di HuggingFace ↗ · GLM-5 di HuggingFace ↗
Untuk membuat gim
Qwen3 adalah pilihan praktis untuk sebagian besar penggunaan dalam gim. Lisensinya Apache 2.0, yang berarti integrasinya menjadi milik Anda. Dukungan multibahasanya kuat, hal yang penting jika Anda mempertimbangkan pelokalan. Model ini juga andal dalam mengikuti instruksi terstruktur. Varian 7B dan 14B dapat dijalankan secara lokal pada GPU konsumen.
Qwen3.5, 3.6, dan 3.8 mempertahankan penggunaan Apache 2.0 sepanjang 2026. Qwen3.5 (16 Februari 2026) diawali dengan MoE 397B-A17B, lalu dilengkapi dengan varian padat 27B, 9B, dan 4B. Qwen3.6 (April) menyetel keluarga model yang sama untuk meningkatkan stabilitas, dan varian 35B-A3B menjadi titik ideal untuk penggunaan lokal: pengetahuan sebesar 35B dengan hanya 3B yang aktif per token, sehingga berjalan sangat cepat pada satu kartu 24 GB. Qwen3.8 (12–14 Agustus 2026) adalah lompatan besarnya. Repositori Qwen3.8 menyebutnya sebagai model sekelas Qwen-Max pertama yang dirilis secara terbuka, dengan model unggulan 2.4T-A95B beserta model padat 27B. Keduanya menggunakan Apache 2.0 dan memiliki konteks 262K.
DeepSeek-V3 menyamai atau mengungguli GPT-4 pada sebagian besar tolok ukur. Arsitekturnya cerdik: hanya 37 miliar parameter yang aktif per token meskipun totalnya mencapai 671 miliar. Anda memerlukan perangkat keras yang serius (beberapa GPU), tetapi kualitasnya berada di tingkat terdepan tanpa ketergantungan pada API.
DeepSeek-V3.2 (Desember 2025) menggabungkan penalaran dan penggunaan alat ke dalam satu model serta memperkenalkan DeepSeek Sparse Attention (DSA) untuk inferensi konteks panjang yang lebih murah, dengan varian Speciale berkomputasi tinggi yang ditujukan untuk tolok ukur penalaran teratas. Untuk logika dan dialog gim, model ini merupakan pengganti langsung V3 yang lebih kuat dan lebih mumpuni sebagai agen.
DeepSeek-V4 (April 2026) kembali memajukan batas model terbuka. V4-Pro adalah MoE dengan 1,6 triliun parameter dan hanya 49 miliar yang aktif per token, jendela konteks satu juta token, serta mode penalaran yang dapat dipilih, semuanya di bawah lisensi MIT. Varian V4-Flash (total 284B, 13B aktif) mempertahankan konteks 1M dalam paket yang tidak menuntut klaster GPU penuh. Jika saat ini Anda memilih model terbuka untuk logika misi kompleks atau konteks status gim yang panjang, inilah batas kemampuan tertingginya.
GLM-5 (Zhipu AI, Februari 2026) adalah model terbuka yang harus dikalahkan untuk pemrograman dan pekerjaan berbasis agen, sedangkan pembaruan GLM-5.2 mendorong skor penggunaan alat dan perencanaan jangka panjangnya mendekati model tertutup terdepan. Ini adalah MoE dengan 744 miliar parameter, 40 miliar parameter aktif per token, konteks 200 ribu token, dan lisensi MIT. GLM-5.2 sendiri dirilis pada 17 Juni 2026 sebagai MoE 753B dengan konteks 1M token, tetap menggunakan MIT tanpa batasan regional. Setelah itu, GLM-5.3, pembaruan pascapelatihan pada model dasar yang sama, menyusul dengan bobot yang tersedia di Hugging Face di bawah lisensi GLM-5.3 milik Z.ai sendiri, bukan MIT. Jadi, periksa isi lisensinya jika Anda menjalankan versi terbaru di server sendiri. Z.ai adalah perusahaan model fondasi publik pertama dan menetapkan harga API terkelolanya secara agresif (sekitar $1,40 per satu juta token masukan), tetapi bobotnya tersedia di Hugging Face jika Anda lebih memilih menjalankannya di server sendiri. Jika gim Anda sangat mengandalkan LLM untuk penulisan skrip misi, agen pemanggil alat, atau sistem berbasis kode, GLM-5 merupakan alternatif OpenAI yang kuat dan sepenuhnya berada di bawah kendali Anda. GPT-OSS (OpenAI, Agustus 2025) adalah rilis open-weight pertama dari OpenAI, dan sangat sesuai dengan tema panduan ini. Model gpt-oss-120b mampu melakukan penalaran dan memanggil alat pada tingkat yang kurang lebih setara dengan o4-mini menggunakan satu GPU 80GB, sedangkan gpt-oss-20b berjalan pada kartu grafis konsumen 16GB; keduanya menggunakan lisensi Apache 2.0. Jika Anda menginginkan model dari lab Barat yang dapat di-host sendiri untuk logika NPC atau agen yang menggunakan alat, inilah pilihannya.
Kimi K2 (Moonshot) adalah model agentik kelas berat terbuka lainnya di samping GLM-5 dan DeepSeek. Ini adalah MoE dengan 1 triliun parameter dan 32B parameter aktif, yang dioptimalkan secara intensif untuk pemrograman dan penggunaan alat. Lisensi Modified MIT-nya hanya menambahkan batasan di atas 100 juta pengguna bulanan, jadi bagi pengembang indie lisensi tersebut pada dasarnya setara dengan MIT. Gunakan model ini saat sebuah agen harus merencanakan banyak langkah.
Kimi K3 (Moonshot, Juli 2026) adalah model open-weight terbesar yang pernah diumumkan, dan posisinya lebih dekat ke frontier tertutup daripada model terbuka mana pun sebelumnya. Ini adalah MoE dengan 2,8 triliun parameter, tetapi hanya sekitar 50B yang aktif per token (16 dari 896 pakar), konteks 1 juta token, dan kemampuan visual bawaan. Model ini dibangun berdasarkan dua desain atensi baru bernama Kimi Delta Attention dan Attention Residuals. Dalam benchmark Moonshot pada Juli, model ini mengungguli rilis Claude Opus dan GPT-5.5 saat itu dalam tugas pemrograman dan agentik, serta hanya tertinggal dari model proprietary teratas—meskipun target tersebut kembali bergeser setelah Claude Fable 5.1 dan GPT-6 Astra dirilis pada September. Bobotnya tersedia di Hugging Face pada 27 Juli 2026 dalam format MXFP4, menggunakan Kimi K3 License alih-alih MIT. Lisensinya permisif untuk sebagian besar penggunaan, tetapi bisnis model-as-a-service dengan pendapatan lebih dari $20 juta dalam periode 12 bulan mana pun memerlukan perjanjian terpisah dengan Moonshot. Produk dengan lebih dari 100 juta pengguna bulanan atau pendapatan bulanan sebesar $20 juta juga harus menampilkan "Kimi K3" di antarmuka. Menjalankan sendiri model 2,8T masih membutuhkan klaster GPU multi-node, sehingga sebagian besar tim akan mengaksesnya melalui API dengan biaya $3 per satu juta token input dan $15 per satu juta token output. Untuk agen yang benar-benar dapat Anda jalankan sendiri, K2 tetap menjadi pilihan Moonshot yang praktis, tetapi K3 mendefinisikan ulang arti "terbuka" di tingkat tertinggi.
Gemma 3 (Google) paling cocok saat Anda perlu menjalankan model di perangkat pemain atau melakukan lokalisasi secara luas. Model ini tersedia dalam ukuran 1B, 4B, 12B, dan 27B, sehingga dapat digunakan mulai dari kartu grafis 8GB, mendukung 140 bahasa, mampu melakukan pemanggilan fungsi, dan varian 4B ke atas juga dapat memahami gambar sehingga sekaligus berfungsi sebagai model visual kecil. Lisensi Gemma mengizinkan penggunaan komersial.
Gemma 4 (Google, 2 April 2026) menggantikannya untuk proyek baru dan menyelesaikan persoalan lisensi sepenuhnya: seluruh keluarga model menggunakan Apache 2.0, sebagaimana dijelaskan dalam kartu model. Model ini tersedia sebagai E2B dan E4B untuk ponsel dan laptop, versi 12B, MoE 26B-A4B dengan kurang dari 4B parameter aktif, serta model dense 31B. Model kecil memiliki konteks 128K, sedangkan model lainnya memiliki konteks 256K. Semua ukuran mendukung input gambar bawaan, model kecil juga mendukung audio, dan keseluruhannya mendukung lebih dari 140 bahasa. Untuk otak NPC di perangkat yang juga harus melihat tangkapan layar, 26B-A4B adalah pilihannya.
Lini Llama dari Meta praktis sedang terhenti. Llama 4 (April 2025) masih menjadi Llama terakhir, dan pada April 2026 Meta Superintelligence Labs meluncurkan penerusnya, Muse Spark, sebagai model tertutup. Meta kembali membuka sebagian akses pada Agustus 2026 melalui Muse Glimmer 30B, sebuah model multimodal dense sekitar 30B di bawah Apache 2.0, dengan konteks 128K+ dan build 4-bit yang muat pada kartu grafis 24GB. Ini adalah model agen lokal yang kuat, tetapi jika Anda menunggu Llama 5, berhentilah menunggu dan pilih Qwen, Gemma 4, atau Glimmer.
Hy3 (Tencent, Juli 2026) adalah rilis besar lainnya dengan lisensi Apache 2.0. Model ini merupakan MoE 295B dengan 21B parameter aktif dan konteks 256K, menurut kartu modelnya. Rilis Juli menghapus pengecualian regional yang terdapat dalam pratinjau April, sehingga tidak seperti lisensi Hunyuan3D dan GameCraft dari Tencent, model ini dapat digunakan di Uni Eropa, Britania Raya, dan Korea Selatan.
Qwen3-Coder (Alibaba) adalah model pemrograman terbuka khusus yang menggantikan lini DeepSeek-Coder lama untuk sebagian besar penggunaan. Ini adalah MoE 480B dengan 35B parameter aktif, konteks bawaan 256K yang dapat diperluas hingga 1 juta, menggunakan Apache 2.0, dan berada di kelas Claude Sonnet dalam benchmark pemrograman agentik. Jika game Anda menghasilkan atau menjalankan kode, inilah batas tertinggi model terbuka. Keluarga Mistral dari Eropa merupakan alternatif solid yang dapat di-host sendiri: Devstral untuk pemrograman, serta Mistral Small 4 (16 Maret 2026), sebuah MoE 119B dengan 6B parameter aktif yang menggabungkan penalaran, visi, dan pemrograman agentik dalam satu model Apache 2.0 dengan konteks 256K.
Qwen3-VL menambahkan pemahaman visual, dengan ukuran dense dan MoE mulai dari 2B hingga 235B di bawah Apache 2.0. Model ini berguna untuk game yang perlu menganalisis tangkapan layar, memahami konten buatan pemain, atau memproses input kamera. Varian 8B berjalan pada satu GPU. InternVL3 (Shanghai AI Lab, MIT) adalah opsi vision-language terbuka kuat lainnya, terutama unggul dalam OCR dan grounding antarmuka, yang penting jika alat Anda perlu membaca antarmuka game; Pixtral 12B dari Mistral (Apache 2.0) adalah pilihan lebih ringan yang aman untuk penggunaan komersial.
Untuk NPC di perangkat—karakter yang merespons secara real-time tanpa panggilan cloud—Qwen3-8B melalui NVIDIA ACE merupakan jalur paling praktis saat ini. Model ini berjalan berdampingan dengan game Anda di perangkat pemain.
Model Utilitas
Model-model ini tidak menghasilkan konten secara langsung, tetapi membuat pipeline Anda berfungsi.
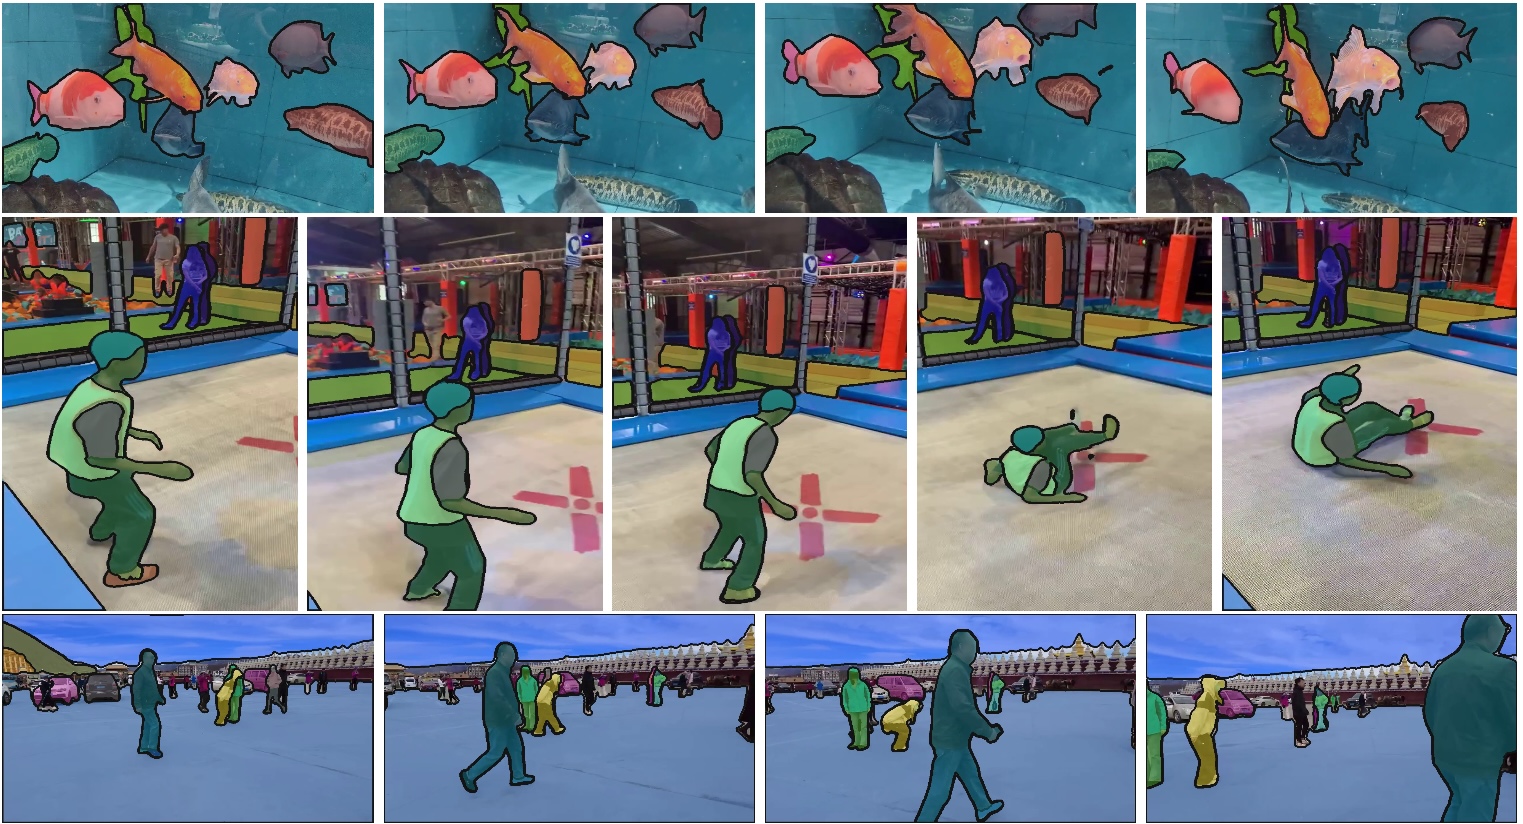 SAM 2 menyegmentasikan objek apa pun dalam gambar dan video. Klik sekali, dapatkan mask yang sempurna
| Model | Organisasi | Dirilis | Fungsinya |
|---|---|---|---|
| SAM 2 | Meta | Agu 2024 | Menyegmentasikan apa pun dalam gambar dan video |
| Depth Pro | Apple | Okt 2024 | Menghasilkan kedalaman metrik dari satu gambar |
| gsplat | Nerfstudio | 2024+ | Gaussian splatting dengan akselerasi CUDA |
SAM 2 menyegmentasikan objek dalam video secara real-time. Klik sesuatu, lalu dapatkan mask yang sempurna. Berguna untuk rotoscoping, compositing, atau mengekstrak objek dari rekaman agar dapat digunakan sebagai aset game. Coba SAM 2 ↗
Depth Pro dari Apple menghasilkan peta kedalaman metrik dari satu gambar dalam waktu kurang dari satu detik. Ini membuka banyak kemungkinan: mengubah karya 2D menjadi 2.5D dengan efek paralaks, menghasilkan data kedalaman untuk rekonstruksi 3D, dan membuat normal map dari gambar datar. Depth Pro di HuggingFace ↗
gsplat adalah implementasi cepat untuk Gaussian splatting. Jika Anda merekam lingkungan nyata untuk game, baik melalui fotogrametri maupun pemindaian lingkungan, library inilah yang membuat prosesnya praktis.
Yang Benar-Benar Akan Saya Gunakan
Jika Anda memulai proyek game hari ini, berikut stack yang masuk akal:
Tekstur dan sprite: FLUX.1 [schnell], Apache 2.0, iterasi cepat, kualitas yang siap dirilis
Concept art: SD 3.5 Large dengan LoRA untuk mengendalikan gaya
Aset 3D: Hunyuan3D 2.1 atau TRELLIS.2 untuk mesh bertekstur, SAM 3D jika Anda memulai dari foto, lalu Blender untuk penyempurnaan
Auto-rigging: UniRig atau NVIDIA SOMA-X untuk membuat skeleton dan skin pada mesh hasil generasi (keduanya terbuka), alih-alih bergantung pada Mixamo
Efek suara: model Small-SFX terbuka dari Stable Audio, berjalan secara lokal dan berlisensi komersial
Musik: ACE-Step untuk prototipe, lalu libatkan komponis untuk produksi final
Suara: Qwen3-TTS untuk kloning suara dan dialog latar (Apache 2.0), Chatterbox (MIT) saat sebuah dialog membutuhkan emosi yang nyata, dan pengisi suara untuk dialog-dialog penting
Dialog NPC: Qwen3.6-35B-A3B, Gemma 4 26B-A4B, atau Muse Glimmer 30B secara lokal, maupun LLM cloud yang dapat di-host sendiri (GLM-5.2, DeepSeek-V4, atau Kimi K3) untuk penalaran kompleks dan penggunaan alat
Video (cutscene): Mochi 1 atau Wan 2.2 5B secara lokal, LTX-2.5 atau HunyuanVideo-1.5 di cloud saat Anda membutuhkan kualitas final
Inti dari semua ini adalah: kesalahan yang umum terjadi ialah mencoba menggunakan AI untuk segalanya. Ini adalah alat, bukan pengganti. Alat-alat ini memangkas bagian yang melelahkan seperti iterasi, variasi, dan aset sementara, sehingga Anda dapat menghabiskan waktu untuk keputusan kreatif yang benar-benar penting. Bagian-bagian yang menjadikan game Anda milik Anda sendiri.
Pemeriksaan Realitas Perangkat Keras
Mari jujur tentang apa yang sebenarnya Anda butuhkan untuk menjalankan semua ini:
VRAM 8GB (RTX 3060, 4060): SD 1.5/SDXL, Wan 2.1 kecil, AudioGen, Fish Speech, LLM kecil (7B terkuantisasi). Ini adalah kelas laptop gaming, dan sudah cukup untuk memulai.
VRAM 12GB (RTX 3080, 4070): SD 3.5, FLUX schnell, Mochi 1, MusicGen, TripoSR, Qwen 14B terkuantisasi. Di tingkat ini semuanya mulai terasa nyaman. Sebagian besar model yang berguna dapat berjalan di sini.
VRAM 24GB (RTX 3090, 4090): Sebagian besar model pada presisi penuh, InstantMesh, LLM yang lebih besar, serta kelas agen lokal 2026: Qwen3.6-35B-A3B, Gemma 4 31B pada 4-bit, dan Muse Glimmer 30B pada 4-bit. Jika Anda serius dengan alur kerja ini, inilah titik idealnya.
VRAM 48-80GB (A100, H100): HunyuanVideo, LTX-2, DeepSeek-V3, dan generasi berskala produksi. Ini perangkat keras kelas perusahaan. Anda tidak akan membelinya, tetapi menyewanya.
Instans cloud di RunPod, Lambda Labs, atau Modal berbiaya $2-4/jam untuk A100. Untuk penggunaan sesekali, itu lebih murah daripada membeli perangkat keras. Nyalakan saat Anda membutuhkan kualitas final, lalu matikan setelah selesai.
Tentang perkiraan biaya dalam panduan ini: Biaya per generasi mengasumsikan inferensi yang di-host sendiri pada GPU cloud dengan tarif sekitar ~$2-3/jam (A100) atau ~$0.40/jam (RTX 4090). Biaya sebenarnya bervariasi berdasarkan perangkat keras, optimasi, dan ukuran batch. Angka-angka ini merupakan perkiraan kasar untuk perencanaan, jadi hasil Anda dapat berbeda.
Yang Baru pada 2026
Baru-baru ini dirilis: LTX-2 dan LTX-2.3 menghadirkan audio dan video tersinkronisasi terbuka dengan 4K bawaan. TRELLIS.2 dari Microsoft (Desember 2025) menjadi pemimpin terbuka untuk img-to-3D, dan SAM 3D dari Meta (November 2025) membuat rekonstruksi 3D dari satu foto menjadi praktis. FLUX.2 menggantikan FLUX.1 untuk generasi gambar, sementara SOMA-X dari NVIDIA menghadirkan auto-rigging dan retargeting terbuka. Paruh pertama 2026 mempertahankan kecepatan tersebut: Qwen3-TTS (Januari) menyediakan rumah berlisensi Apache 2.0 yang layak untuk kloning suara, GLM-5 dari Zhipu (Februari) merilis model pemrograman dan agentik terbuka 744B di bawah MIT, Matrix-Game 3.0 dari Skywork (Maret) menghadirkan model dunia interaktif real-time dalam bobot terbuka, DeepSeek-V4 (April) mendorong LLM terbuka ke konteks 1 juta token di bawah MIT, Stable Audio 3.0 (Mei) merilis tiga model audio terbuka yang dilatih menggunakan data berlisensi, dan Ideogram merilis model gambar open-weight pertamanya (Juni). Kemudian pada Juli, Moonshot mengumumkan Kimi K3, model open-weight dengan 2,8T parameter, dan bobotnya dirilis pada 27 Juli di bawah Kimi K3 License. Pada bulan yang sama, Tencent memindahkan Hy3 295B ke Apache 2.0, beberapa minggu setelah Z.ai merilis GLM-5.2 di bawah MIT (17 Juni). Agustus juga sibuk di sisi terbuka: Alibaba merilis Qwen3.8 (model unggulan 2.4T-A95B ditambah model dense 27B, Apache 2.0), Meta merilis Muse Glimmer 30B di bawah Apache 2.0, MiniMax membuka bobot video H3 33B, dan Lightricks merilis LTX-2.5. Sebelumnya pada tahun yang sama, Gemma 4 dari Google (April, Apache 2.0) dan Mistral Small 4 (Maret, Apache 2.0) mendefinisikan ulang kelas model di perangkat.
Tren yang perlu diperhatikan: lab-lab teratas semakin sering mempertahankan model terbaru mereka sebagai API-only, meskipun versi sebelumnya bersifat terbuka. Wan menjadi tertutup pada versi 2.5 dan tetap tertutup hingga 3.0 (Agustus 2026), demikian pula Qwen-Image pada 2.0 dan Hunyuan3D pada 2.5. Penerus Llama dari Meta, Muse Spark, diluncurkan sebagai model tertutup pada April 2026 sebelum Muse Glimmer yang lebih kecil kembali dibuka pada Agustus. Black Forest Labs merilis FLUX 3 melalui API terlebih dahulu, dengan FLUX 3 Dev terbuka yang dijanjikan hadir pada akhir 2026, sementara Skywork mengumumkan SkyReels V4 pada Februari tanpa menerbitkan bobotnya. Ekosistem terbuka masih hidup dan bergerak cepat, tetapi anggapan bahwa "versi terbaru pasti terbuka" tidak lagi aman. Karena itu, periksa ketersediaan bobot sebelum membangun pipeline berdasarkan sebuah model.
Arah perkembangannya jelas: setiap kemampuan yang tersedia dalam model tertutup muncul dalam model terbuka 6-12 bulan kemudian. Pertanyaannya bukan apakah model terbuka akan cukup bagus. Untuk sebagian besar penggunaan, model-model tersebut sudah cukup bagus. Pertanyaannya adalah seberapa cepat model terbuka menjadi pilihan default.
Dan inilah artinya bagi para kreator: alat-alat yang dahulu membutuhkan anggaran perusahaan atau langganan bulanan kini menjadi sesuatu yang dapat begitu saja Anda... jalankan. Di perangkat keras Anda sendiri. Tanpa memerlukan izin dari pihak lain.
Itulah pergeserannya. Itulah tujuan yang sedang kita bangun.
Pertanyaan Umum
Apa model AI sumber terbuka terbaik untuk menghasilkan aset game?
Tergantung pada jenis asetnya. Untuk model 3D, Hunyuan3D adalah opsi terbuka terkuat pada 2026. Untuk karya seni 2D dan tekstur, FLUX memimpin dalam kualitas. Untuk efek suara dan musik, model audio terbuka telah mengejar dengan cepat. Tidak ada satu model "terbaik" karena game membutuhkan banyak jenis aset, sehingga sebagian besar kreator merangkai beberapa model alih-alih hanya mengandalkan satu.
Apakah model AI sumber terbuka cukup bagus untuk menggantikan API tertutup?
Untuk sebagian besar pekerjaan aset game pada 2026, ya. Model terbuka kini menyamai API tertutup dalam generasi gambar, 3D, dan audio, serta dapat dijalankan pada perangkat keras Anda sendiri tanpa biaya per panggilan atau perubahan harga mendadak. Model tertutup masih unggul dalam beberapa tugas frontier seperti video berdurasi panjang, tetapi kesenjangan tersebut biasanya tertutup dalam 6 hingga 12 bulan.
Bisakah saya menjalankan model AI generatif ini pada GPU sendiri?
Banyak di antaranya bisa. Model gambar dan audio berjalan nyaman pada satu GPU konsumen seperti RTX 4090. Model video dan 3D yang lebih besar membutuhkan lebih banyak VRAM dan sering kali memerlukan GPU cloud kelas A100. Bagian perangkat keras di atas mencantumkan kebutuhan setiap model agar Anda dapat membuat perencanaan sebelum berkomitmen.
Apa model frontier sumber terbuka terbaik pada 2026?
Per September 2026, persaingan model frontier terbuka berlangsung di antara empat model, dan jawabannya bergantung pada perangkat yang dapat Anda jalankan. Kimi K3 (2.8T MoE) adalah yang terbesar dan skornya paling mendekati para pemimpin tertutup, tetapi Lisensi Kimi K3 menambahkan persyaratan bagi bisnis model-as-a-service berskala besar. DeepSeek-V4-Pro (1.6T, 49B aktif) dan Qwen3.8-2.4T-A95B memiliki lisensi paling sederhana pada skala tersebut, masing-masing MIT dan Apache 2.0. GLM-5.2 (753B, MIT) adalah spesialis pemrograman dan agen. Tidak satu pun dapat dijalankan pada satu GPU, jadi untuk model yang Anda hos sendiri, pilihan "terbaik" sebenarnya berada satu tingkat di bawahnya: Qwen3.6-35B-A3B, Gemma 4 31B, atau Muse Glimmer 30B.
Apa saja model frontier terbaik untuk pembuatan gambar, baik terbuka maupun tertutup?
Terbuka: FLUX.2 [klein] 4B (Apache 2.0, kurang dari satu detik) untuk aset visual game yang aman digunakan secara komersial, Qwen-Image-2512 (Apache 2.0) saat Anda memerlukan teks yang mudah dibaca, serta FLUX.2 [dev] atau Chroma1-HD untuk kualitas maksimal jika lisensinya sesuai. Tertutup: FLUX.2 [pro] dan Qwen-Image-2.0 yang hanya tersedia melalui API, ditambah model yang hadir pada 2026 seperti Kling IMAGE 3.0 (hingga 10 gambar referensi menurut panduan Kling) dan Grok Imagine Image 2.0 dari xAI. Untuk saat ini, model gambar FLUX 3 hanya tersedia melalui API BFL, dengan versi Dev terbuka yang dijanjikan akan hadir kemudian pada 2026. Untuk pembuatan game, tingkat terbuka sudah cukup bagus, jadi manfaat utama model tertutup adalah kemudahan penggunaan.
Model video berbobot terbuka mana yang mengizinkan penerapan komersial penuh, dan dengan lisensi apa?
Jika Anda memerlukan model video terbuka yang dapat diterapkan secara komersial pada skala perusahaan tanpa batas pendapatan, pilihan amannya adalah Wan 2.2 (Apache 2.0, termasuk varian MoE 5B dan 14B), Mochi 1 (Apache 2.0), Step-Video-T2V (MIT), dan CogVideoX 2B (Apache 2.0). LTX-2 dan LTX-2.5 dapat digunakan secara komersial secara gratis untuk pendapatan tahunan di bawah $10 juta dan memerlukan perjanjian berbayar jika melampaui jumlah tersebut, yang merupakan jalur "membeli akses" yang benar-benar ditawarkan Lightricks. MiniMax H3 bersifat terbuka di bawah MiniMax H3 Community License, tetapi meminta pengguna di AS, UE, Inggris Raya, dan Korea Selatan untuk mendaftar terlebih dahulu. Sementara itu, HunyuanVideo menggunakan lisensi komunitas Tencent dengan pengecualian regional, jadi bacalah keduanya sebelum mengambil keputusan. Wan 2.5 hingga 3.0, Veo, Kling, dan Seedance sama sekali tidak memiliki bobot yang tersedia untuk publik. Panduan model video referensi kami membandingkan berbagai opsi yang dihos.
AI generatif apa yang sebaiknya saya gunakan untuk aset dan lingkungan game pada 2026?
Rangkai beberapa model spesialis alih-alih mencari satu model untuk semuanya. Untuk properti dan karakter, proses konsep dari FLUX.2 klein atau Qwen-Image melalui Hunyuan3D 2.1 atau TRELLIS.2, lalu buat rig dengan UniRig. Untuk lingkungan, buat skybox atau HDRI (generator skybox kami melakukannya di browser), bangun medan secara prosedural atau dengan proses difusi seperti dalam panduan pembuatan medan kami, lalu buat teksturnya menggunakan model gambar dan ekstraktor PBR sebagaimana dibahas dalam panduan generator tekstur AI kami. Audio dapat dibuat dengan Stable Audio 3.0 Small-SFX dan ACE-Step, sedangkan suara dapat dibuat dengan Qwen3-TTS atau Chatterbox. Per September 2026, setiap model dalam rangkaian tersebut bersifat terbuka dan dapat digunakan secara komersial.
Apa LLM terbaik untuk dijalankan secara lokal pada 2026?
Pilih berdasarkan VRAM terlebih dahulu. Untuk 8GB, gunakan Qwen3.5-4B atau Gemma 4 E4B. Untuk 16GB, gunakan gpt-oss-20b (Apache 2.0, dirancang untuk 16GB) atau Gemma 4 12B. Untuk 24GB, Qwen3.6-35B-A3B adalah model serbaguna yang sebaiknya dijalankan oleh sebagian besar pengguna, dengan Muse Glimmer 30B pada 4-bit untuk pekerjaan berbasis agen dengan kemampuan visual dan Gemma 4 31B terkuantisasi jika Anda menginginkan model padat terkuat. Di atas itu, DeepSeek-V4-Flash (284B, 13B aktif) adalah opsi terkecil untuk memperoleh konteks 1 juta token di sebuah workstation. Semua model ini menggunakan Apache 2.0 atau MIT, dan Ollama atau LM Studio dapat menjalankan masing-masing hanya dengan satu perintah.
Apakah penggunaan aset buatan AI dalam game komersial legal?
Secara umum ya untuk model sumber terbuka yang Anda jalankan sendiri, tetapi hal ini bergantung pada lisensi model dan asumsi Anda mengenai data pelatihannya. Selalu periksa lisensi spesifik model tersebut, dan ungkapkan konten buatan AI jika platform Anda mewajibkannya. Lihat kebijakan konten buatan AI kami untuk mengetahui cara kami menanganinya.
Bacaan Lebih Lanjut
- Kontroversi AI, kepercayaan, dan ekonomi pasca-AI: pandangan kami tentang AI dalam game
- Kebijakan konten buatan AI: cara kami menangani pengungkapan penggunaan AI
- Model Video AI Terbaik dengan Dukungan Gambar Referensi: perbandingan model video yang dihos
- Generator Model 3D AI Terbaik: perbandingan Meshy, Tripo, dan Rodin yang dihos dengan model terbuka
- Stack Teknologi Game Web pada 2026: WebGL, WebGPU, dan Wasm untuk game
- Teknologi Dunia Terbuka 3D di Browser: menggunakan aset 3D buatan AI dalam dunia berbasis browser
- Pembuatan Lanskap untuk Dunia Terbuka di Browser: sintesis medan berbasis difusi
- Tempat Menemukan Aset Game Gratis: sumber aset tradisional sebagai pelengkap pembuatan dengan AI
- Alat kode AI berbasis agen: AI untuk menulis kode game, bukan sekadar membuat aset
Model generatif terasa lebih menyenangkan ketika hasilnya dapat dimainkan.