Meilleurs modèles d’IA générative open source pour les jeux (2026)
Dernière mise à jour : septembre 2026.
Voici le problème avec l'IA générative. Pendant des années, les meilleurs modèles vivaient derrière des clés d'API et des tarifications imprévisibles. Vous construisiez votre workflow autour d'un outil, vous vous y habituiez, puis vous découvriez un e-mail annonçant un changement de tarification. Ou pire, l'entreprise changeait complètement de direction.
Cela a changé fin 2024. Tencent, Alibaba et DeepSeek ont commencé à publier des modèles que l'on peut réellement télécharger. Des modèles qui rivalisent avec les alternatives fermées. Et soudain, les créateurs ont des options qui ne dépendent plus du modèle économique de quelqu'un d'autre.
Et si vous pouviez générer vidéo, assets 3D, musique et voix, le tout à partir de modèles que vous contrôlez ? C'est là où nous en sommes aujourd'hui. Ce guide passe en revue ce qui est réel, ce qui fonctionne, et ce que vous pouvez commencer à utiliser dès maintenant.
Génération vidéo
Pendant des années, générer de la vidéo signifiait Runway ou Pika : des plateformes fermées, des abonnements payants, des limites sur ce que vous pouviez faire avec le résultat. Maintenant ? Vous pouvez exécuter des modèles comparables sur votre propre matériel.
Génération texte-vers-vidéo HunyuanVideo, sortie 720p du modèle vidéo open source le plus performant
| Modèle | Organisation | Paramètres | Caractéristiques | Matériel | Coût |
|---|---|---|---|---|---|
| HunyuanVideo | Tencent | 13B | 720p, texte+image | 80 Go | ~0,20 $ |
| HunyuanVideo-1.5 | Tencent | 8,3B | 480p-1080p, texte+image | 14 Go | ~0,05 $ |
| Mochi 1 | Genmo | 10B | 480p@30fps | 12 Go+ | ~0,10 $ |
| LTX-Video | Lightricks | — | 768x512, temps réel | 12 Go | ~0,02 $ |
| LTX-2 / LTX-2.5 | Lightricks | 19B (2) / 22B (2.5) | 4K, audio synchronisé, multi-plans en 2.5 | Haut de gamme | ~$0.30 |
| Wan 2.1 | Alibaba | 1,3-14B | 480p-720p | 8 Go+ | ~0,03 $ |
| Wan 2.2 | Alibaba | 27B MoE (14B actifs) | 720p, MoE | 8 Go+ | ~0,03 $ |
| CogVideoX1.5-5B | Tsinghua | 5B | 1360x768@16fps, jusqu'à 10s | 12 Go | ~0,04 $ |
| SkyReels-V3 | Skywork | 14-19B | Piloté par l'audio, ref-vers-vidéo, V2V | Haut de gamme | ~0,10 $ |
| MiniMax H3 | MiniMax | 33B | 2K, 4-15s, audio stéréo, jusqu'à 9 images de référence | Haut de gamme | non testé |
| Step-Video-T2V | StepFun | 30B | Plus grand modèle T2V open, 204 images | Haut de gamme | ~0,15 $ |
| Open-Sora 2.0 | HPC-AI | 11B | Intégration Flux | Haut de gamme | ~0,20 $ |
Poids : HunyuanVideo ↗ · Mochi 1 ↗ · Wan 2.1 ↗ · Open-Sora ↗
Voir des exemples : galerie HunyuanVideo ↗ · exemples Mochi ↗ · exemples CogVideoX ↗
Ce que cela signifie pour les créateurs
HunyuanVideo surpasse Runway Gen-3 dans les évaluations professionnelles, et il est entièrement ouvert. Le hic ? Il faut du matériel sérieux. Un A100 ou H100 avec 80 Go de VRAM. Pour la plupart d'entre nous, cela signifie louer des GPU cloud en cas de besoin.
HunyuanVideo-1.5 a changé la donne côté matériel. Tencent l'a publié en novembre 2025 sous forme de modèle ouvert de 8,3 milliards de paramètres, capable de tourner sur un GPU grand public de 14 Go, avec du texte-vers-vidéo et de l'image-vers-vidéo en 480p/720p et un upscaling optionnel en 1080p. Un nouveau mécanisme d'attention Selective and Sliding Tile Attention (SSTA) lui confère environ le double de la vitesse d'inférence du HunyuanVideo original. Si vous vouliez la qualité de HunyuanVideo sans pouvoir justifier une carte à 80 Go, c'est la version que vous pouvez réellement faire tourner chez vous.
Mochi 1 est celui que vous pouvez réellement faire tourner. Un GPU de 12 Go, territoire RTX 3060, s'en sort très bien. Le résultat est réellement créatif, avec une qualité artistique distincte. Pas tout à fait la fidélité de HunyuanVideo, mais vous maîtrisez le processus.
LTX-2 est là où les choses deviennent intéressantes pour les jeux. C'est le premier modèle ouvert qui génère un audio synchronisé avec la vidéo. Imaginez des cinématiques où le son... correspond tout simplement. Aucune synchronisation en post-production. Lightricks a rendu open source les poids complets, l'inférence et le code d'entraînement en janvier 2026, avec une sortie native en 4K jusqu'à 50 images/seconde et un audio synchronisé jusqu'à 20 secondes. Une réserve concernant la licence : les poids ouverts de LTX-2 sont gratuits pour un usage académique, et pour un usage commercial uniquement pour les entreprises réalisant moins de 10 millions de dollars de chiffre d'affaires annuel, alors vérifiez ce seuil avant de bâtir une entreprise dessus. Le checkpoint actuel en septembre 2026 est LTX-2.5, un modèle de 22B qui ajoute une génération multi-plans native (plusieurs plans connectés avec un même personnage et un même style visuel), un décodeur vidéo par diffusion à la place d'une simple reconstruction VAE, et un encodeur de texte Gemma 4 12B pour des prompts plus longs, le tout toujours sous la licence communautaire LTX-2.x, avec le même seuil de 10 millions de dollars de chiffre d'affaires et un accord payant au-delà.
SkyReels-V3 (Skywork, janvier 2026) est la nouvelle ligne ouverte notable. C'est un modèle multimodal unifié qui fait de la vidéo pilotée par l'audio, de la référence-vers-vidéo et de la vidéo-vers-vidéo en variantes 14B et 19B, donc particulièrement solide quand vous avez besoin qu'un personnage ou une image de référence pilote le plan. Step-Video-T2V (StepFun) est le plus grand modèle texte-vers-vidéo ouvert avec 30B de paramètres et est distribué sous une licence MIT propre, à connaître si le caractère permissif de la licence compte plus pour vous que la capacité à tenir sur un petit GPU.
MiniMax H3 (Hailuo 3.0) est la nouvelle entrée ouverte la plus récente, et celle à surveiller pour les cinématiques pilotées par référence. MiniMax l'a lancé en tant qu'API le 31 juillet 2026 et a mis les poids de base de 33B sur Hugging Face en août avec deux checkpoints : FL2VA pour la génération à partir d'une première et d'une dernière image, et Ref2VA, qui prend jusqu'à 9 images de référence, 3 clips vidéo de référence et 3 clips audio (12 fichiers au total) et génère de 4 à 15 secondes jusqu'à 2K avec un audio stéréo natif. La licence est la MiniMax H3 Community License, et la fiche du modèle demande aux utilisateurs des États-Unis, de l'UE, du Royaume-Uni et de Corée du Sud de remplir d'abord un formulaire de demande, ce n'est donc pas une solution clé en main pour tous les studios.
Wan 2.1 tourne sur un ordinateur portable de jeu. Un GPU de 8 Go suffit pour les variantes les plus petites. Si vous avez toujours voulu prototyper avec la génération vidéo sans pouvoir justifier le matériel, voici votre porte d'entrée.
Wan 2.2 (Alibaba, juillet 2025) est le premier modèle vidéo open source construit sur une architecture Mixture-of-Experts : 27B de paramètres au total, dont seulement 14B actifs par étape. Il est distribué en texte-vers-vidéo (T2V-A14B), image-vers-vidéo (I2V-A14B), et une variante hybride de 5B qui tourne sur des GPU grand public, le tout sous licence Apache 2.0 pour un usage commercial.
Une réserve à connaître : Wan 2.2 reste le dernier Wan ouvert. Les versions plus récentes, Wan 2.5 (septembre 2025), 2.6 (décembre 2025), 2.7 (avril 2026), et maintenant Wan 3.0 (août 2026, avec des clips en un seul plan de 30 secondes jusqu'en 1080p et des entrées de référence, selon Alibaba Cloud Model Studio) ont ajouté un audio synchronisé, le 1080p et un contrôle d'image plus fin, mais sont uniquement disponibles via API, sans poids publics. L'organisation Wan-AI sur Hugging Face plafonne toujours à la version 2.2 en septembre 2026, quoi qu'en disent les sites affiliés. Si l'auto-hébergement compte pour vous, 2.2 est le plafond. LTX-2.5 est le modèle ouvert vers lequel se tourner quand vous avez besoin de 4K et d'audio synchronisé.
Le workflow qui a du sens : Mochi 1 ou Wan 2.1 pour prototyper en local. HunyuanVideo-1.5 ou LTX-2.5 sur des GPU cloud quand vous avez besoin de la qualité finale.
Génération d'images
C'est là que l'open source a déjà gagné. Les modèles que vous pouvez télécharger aujourd'hui rivalisent réellement avec Midjourney. Pas « presque aussi bon », véritablement compétitif.
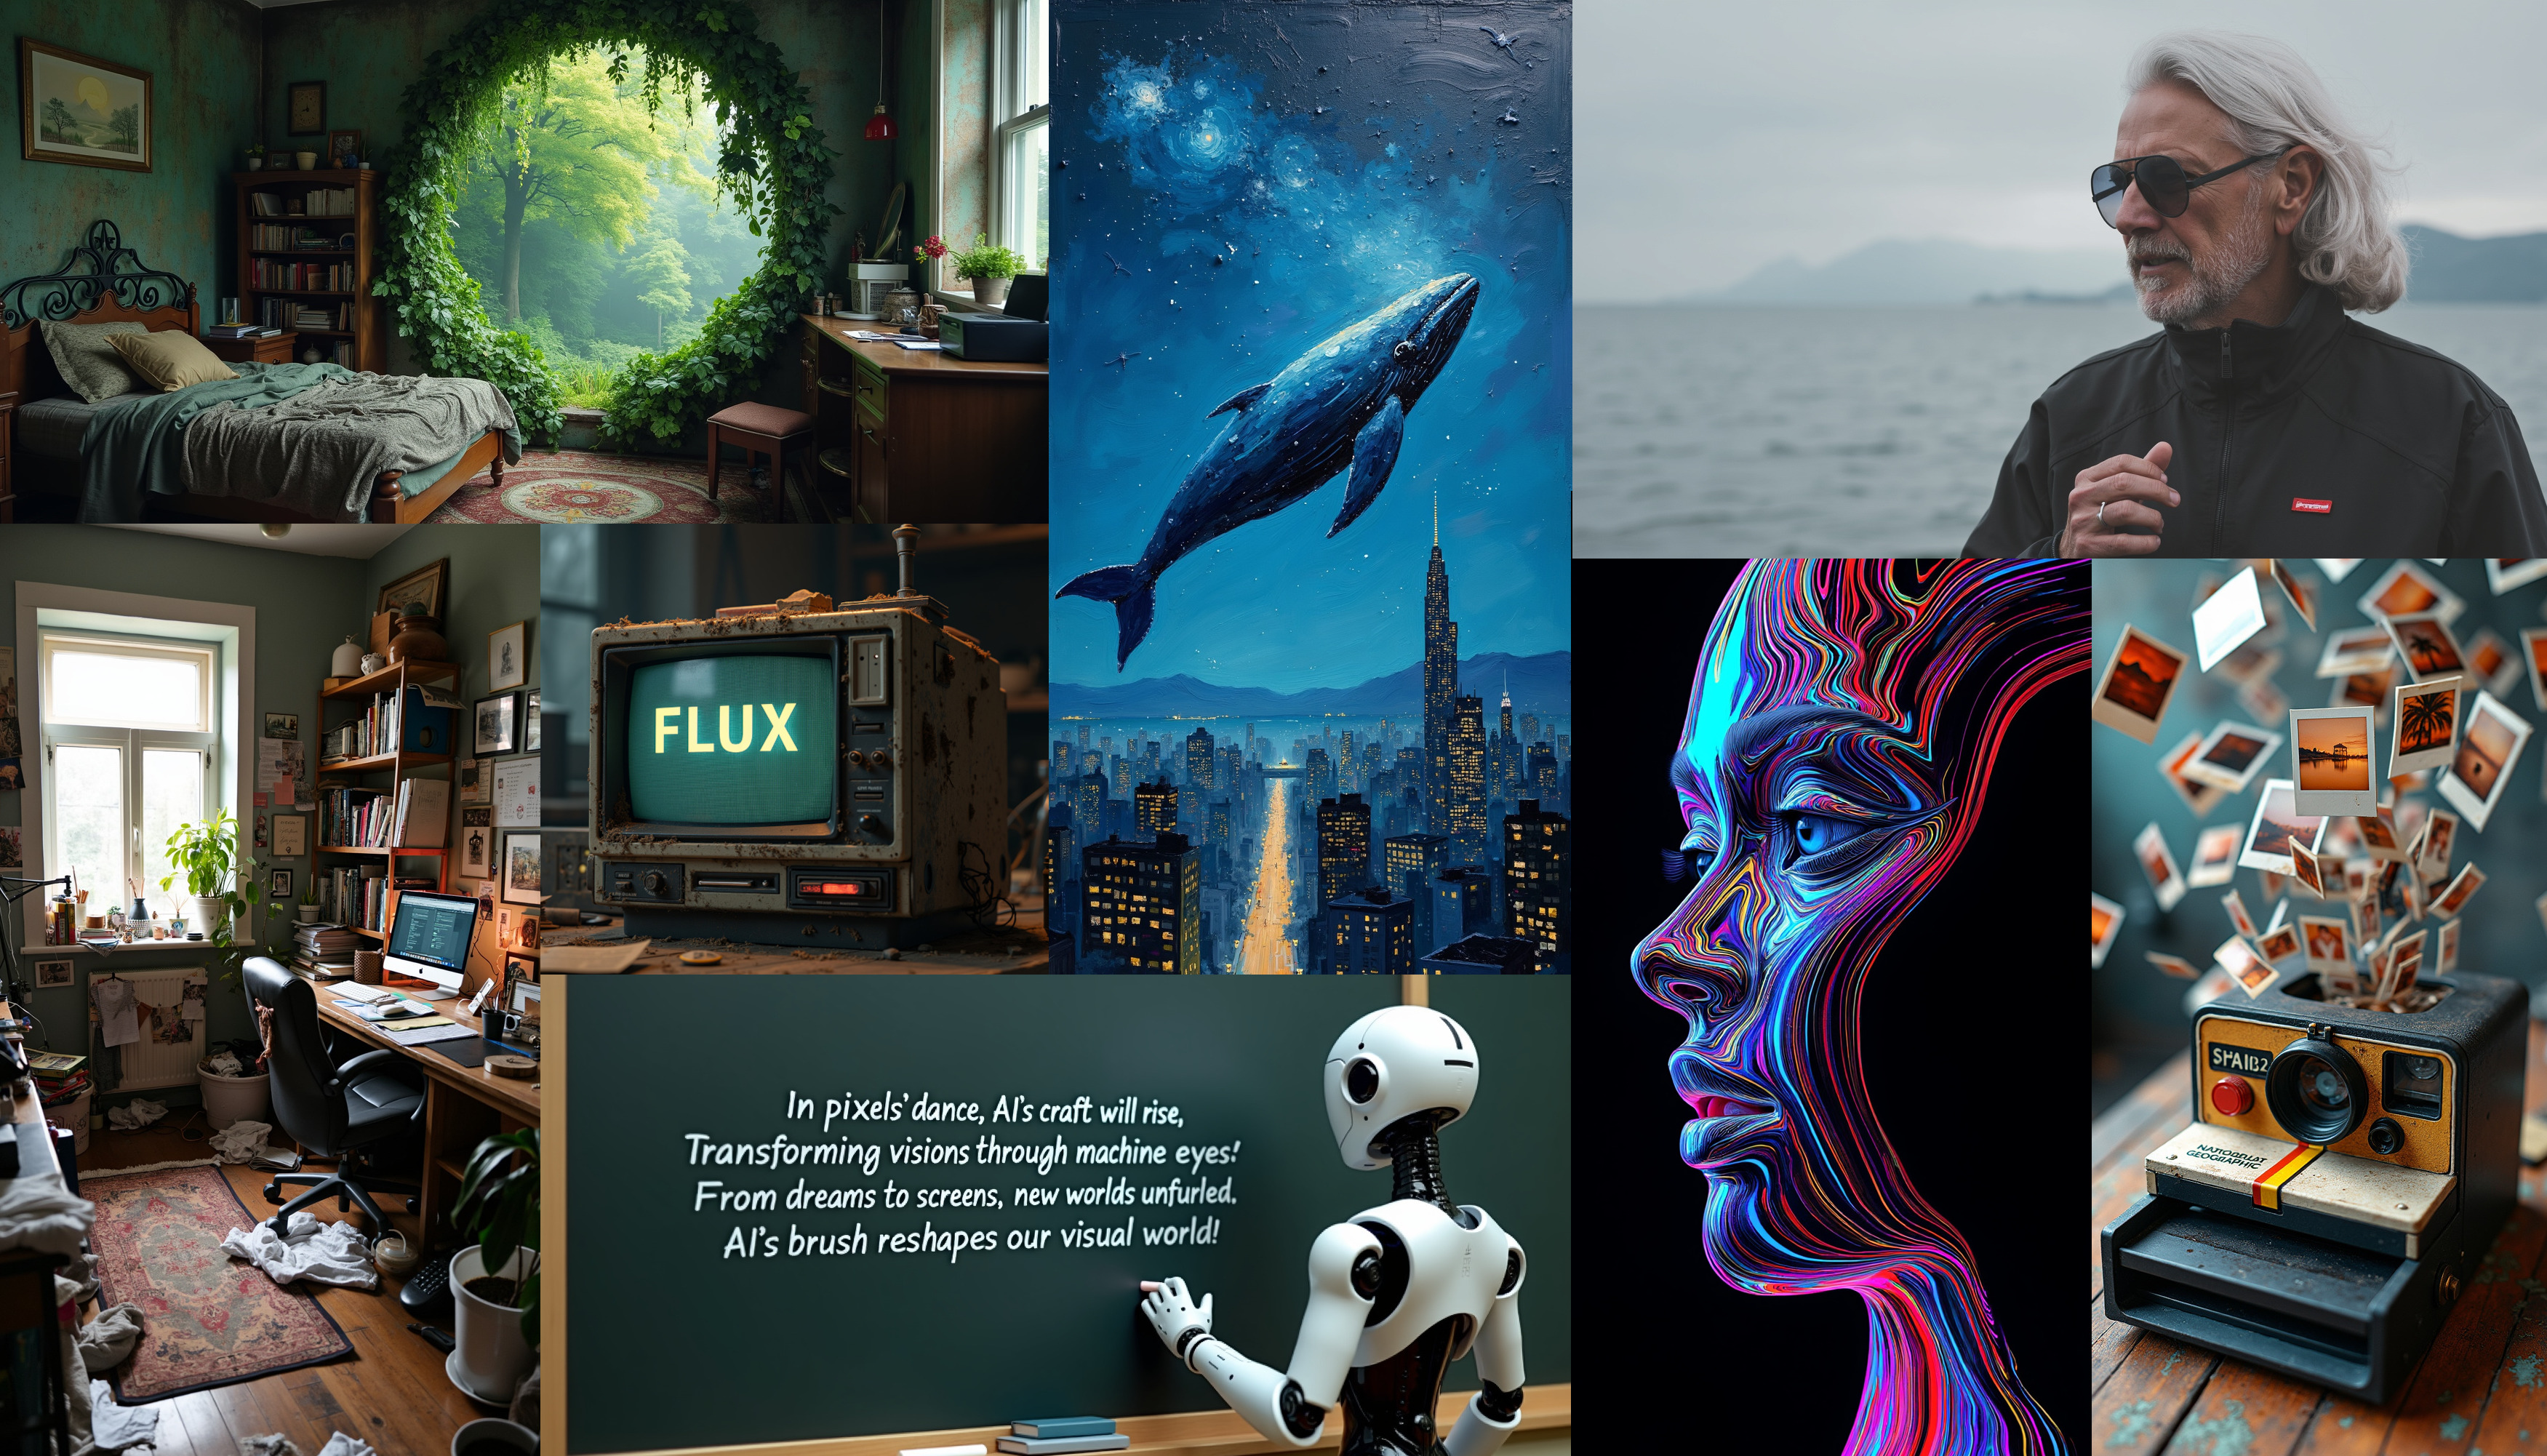 Exemples FLUX.1, qualité photoréaliste d'un modèle sous licence Apache 2.0
| Modèle | Organisation | Sortie | Paramètres | Caractéristique clé | Licence | Coût/image |
|---|---|---|---|---|---|---|
| FLUX.1 [schnell] | Black Forest Labs | Août 2024 | 12B | Génération en 4 étapes, rapide | Apache 2.0 | ~0,001 $ |
| FLUX.1 [dev] | Black Forest Labs | Août 2024 | 12B | Qualité proche de Pro | Non commercial | ~0,002 $ |
| SD 3.5 Large | Stability AI | Oct 2024 | 8B | Rendu de texte, styles variés | Licence Stability | ~0,002 $ |
| SD 3.5 Large Turbo | Stability AI | Oct 2024 | 8B | 4 étapes, rapide | Licence Stability | ~0,001 $ |
| HiDream-I1 | HiDream.ai | Avr 2025 | 17B | Haute qualité, variantes Full/Dev/Fast | MIT | ~0,002 $ |
| CogView4 | Tsinghua / Zhipu | Mar 2025 | 6B | Texte chinois natif, jusqu'à 2048px | Apache 2.0 | ~0,002 $ |
| Qwen-Image | Alibaba | Août 2025 | 20B | Rendu de texte de premier plan, édition | Apache 2.0 | ~0,002 $ |
| FLUX.2 | Black Forest Labs | Nov 2025 | 32B | Texte+édition, 4MP, multi-référence | dev : Non commercial / klein 4B : Apache 2.0 | ~0,003 $ |
| Ideogram 4.0 | Ideogram | Juin 2026 | 9,3B | Travail de design, rendu de texte, contrôle de mise en page JSON | Non commercial | ~0,002 $ |
Essayez-les directement : démo FLUX.1 schnell ↗ · démo SD 3.5 Large ↗ · GitHub (FLUX) ↗
Voir des exemples : galerie FLUX ↗ · galerie LoRA FLUX ↗ · exemples Replicate ↗
Pour créer des assets de jeu
FLUX.1 [schnell] est celui à connaître. Licence Apache 2.0, ce qui signifie que vous pouvez publier des jeux commerciaux sans vous soucier de problèmes de licence. Il génère en seulement 4 étapes, vous pouvez donc itérer rapidement. Décrivez ce que vous voulez, voyez le résultat, ajustez, répétez.
SD 3.5 Large gère enfin correctement le rendu de texte. Les versions précédentes massacraient tout texte que vous tentiez d'inclure. C'est important pour les maquettes d'interface, la signalétique en jeu, les écrans-titres, partout où vous avez besoin de mots lisibles dans vos images.
FLUX.2 (Black Forest Labs, novembre 2025) est le successeur plus imposant : un modèle de 32B qui gère le texte-vers-image et l'édition d'image dans un seul checkpoint, avec une forte cohérence multi-référence de personnage/style et un rendu de texte fiable jusqu'à 4 mégapixels. La version à poids ouverts FLUX.2 [dev] utilise une licence non commerciale, mais la version distillée FLUX.2 [klein] (janvier 2026) distribue sa version 4B sous Apache 2.0, génère en moins d'une seconde et tourne avec environ 8 Go de VRAM, il existe donc toujours une option sûre commercialement pour produire des assets de jeu. Prenez spécifiquement la version klein 4B : la klein 9B plus grande reste sous la licence FLUX non commerciale. Des pipelines quantifiés font descendre [dev] à des GPU de 18-24 Go. La génération suivante de Black Forest Labs, FLUX 3, est un modèle conjoint image, vidéo et audio annoncé le 23 juillet 2026, et en septembre 2026 il n'est disponible qu'en API : la vidéo avec audio synchronisé est passée en préversion le 4 août, et la version à poids ouverts FLUX 3 Dev est « prévue pour plus tard en 2026 » selon les notes de version de BFL. En attendant son arrivée, klein 4B reste le FLUX sûr commercialement.
Deux autres options ouvertes à connaître. Chroma1-HD (8,9B, Apache 2.0) est un dérivé entièrement ouvert de FLUX.1-schnell, c'est donc la façon sûre commercialement d'obtenir la qualité de la famille FLUX sans la licence [dev]. OmniGen2 (Apache 2.0) est un modèle unifié qui fait à la fois du texte-vers-image et de l'édition par instructions au même endroit, ce qui est le chemin le plus rapide quand vous itérez sur un asset existant (« faites briller l'épée en bleu ») plutôt que de générer depuis zéro.
Qwen-Image (Alibaba, août 2025) est le modèle ouvert vers lequel se tourner quand votre art a besoin de texte lisible, comme la signalétique, l'interface, les affiches ou les étiquettes d'objets. C'est un modèle Apache 2.0 de 20B avec un rendu de texte de premier plan et une variante d'édition par instructions solide, donc sûr commercialement et étonnamment bon dans ce que la plupart des modèles d'image ratent encore. La mise à jour de décembre 2025, Qwen-Image-2512, a affiné le réalisme humain et la mise en page du texte tout en conservant la licence Apache 2.0, prenez donc ce checkpoint si vous vous auto-hébergez. Le plus récent Qwen-Image-2.0 (février 2026) n'est disponible qu'en API, et en septembre 2026 le dépôt QwenLM liste toujours Qwen-Image-2512 et Qwen-Image-Edit-2511 comme les checkpoints les plus récents à poids publics. Ideogram 4.0 (juin 2026) est la première sortie à poids ouverts d'Ideogram : un transformeur de diffusion de 9,3 milliards de paramètres conçu pour le travail de design, avec un rendu de texte multilingue solide et un contrôle explicite de la mise en page et des couleurs via des prompts JSON structurés. Un bémol avant de s'appuyer dessus : le code d'inférence est sous licence Apache 2.0, mais les poids relèvent d'une licence non commerciale, ce qui en fait un outil de recherche et de prototypage, à moins d'acheter la licence commerciale.
L'écosystème autour de Stable Diffusion reste inégalé. ControlNet pour une composition précise. L'inpainting pour les retouches. Le fine-tuning LoRA pour des styles personnalisés. FLUX rattrape son retard, mais si vous avez besoin d'une personnalisation poussée dès aujourd'hui, la maturité des outils de SD vous offre bien plus de possibilités.
Voici comment j'y réfléchirais : textures et sprites, les deux fonctionnent. Concept art avec des exigences de style spécifiques, SD 3.5 avec des LoRA. Pure qualité pour une sortie commerciale, FLUX schnell.
Génération 3D
Si vous avez déjà passé huit heures à modéliser un accessoire qui apparaît trois secondes dans votre jeu, cette section est pour vous. La génération 3D est passée de « recherche intéressante » à véritable outil de production il y a quelque temps, et en 2026, les modèles ouverts sont vraiment performants. Vous pouvez passer d'un croquis à un maillage texturé en moins d'une minute.
Cette page couvre les modèles ouverts que vous pouvez auto-héberger. Si vous cherchez un outil plutôt qu'un modèle, notre guide des meilleurs générateurs de modèles 3D par IA compare les options hébergées (Meshy, Tripo, Rodin, Hi3D) aux options ouvertes, avec les tarifs et droits commerciaux de chacune.
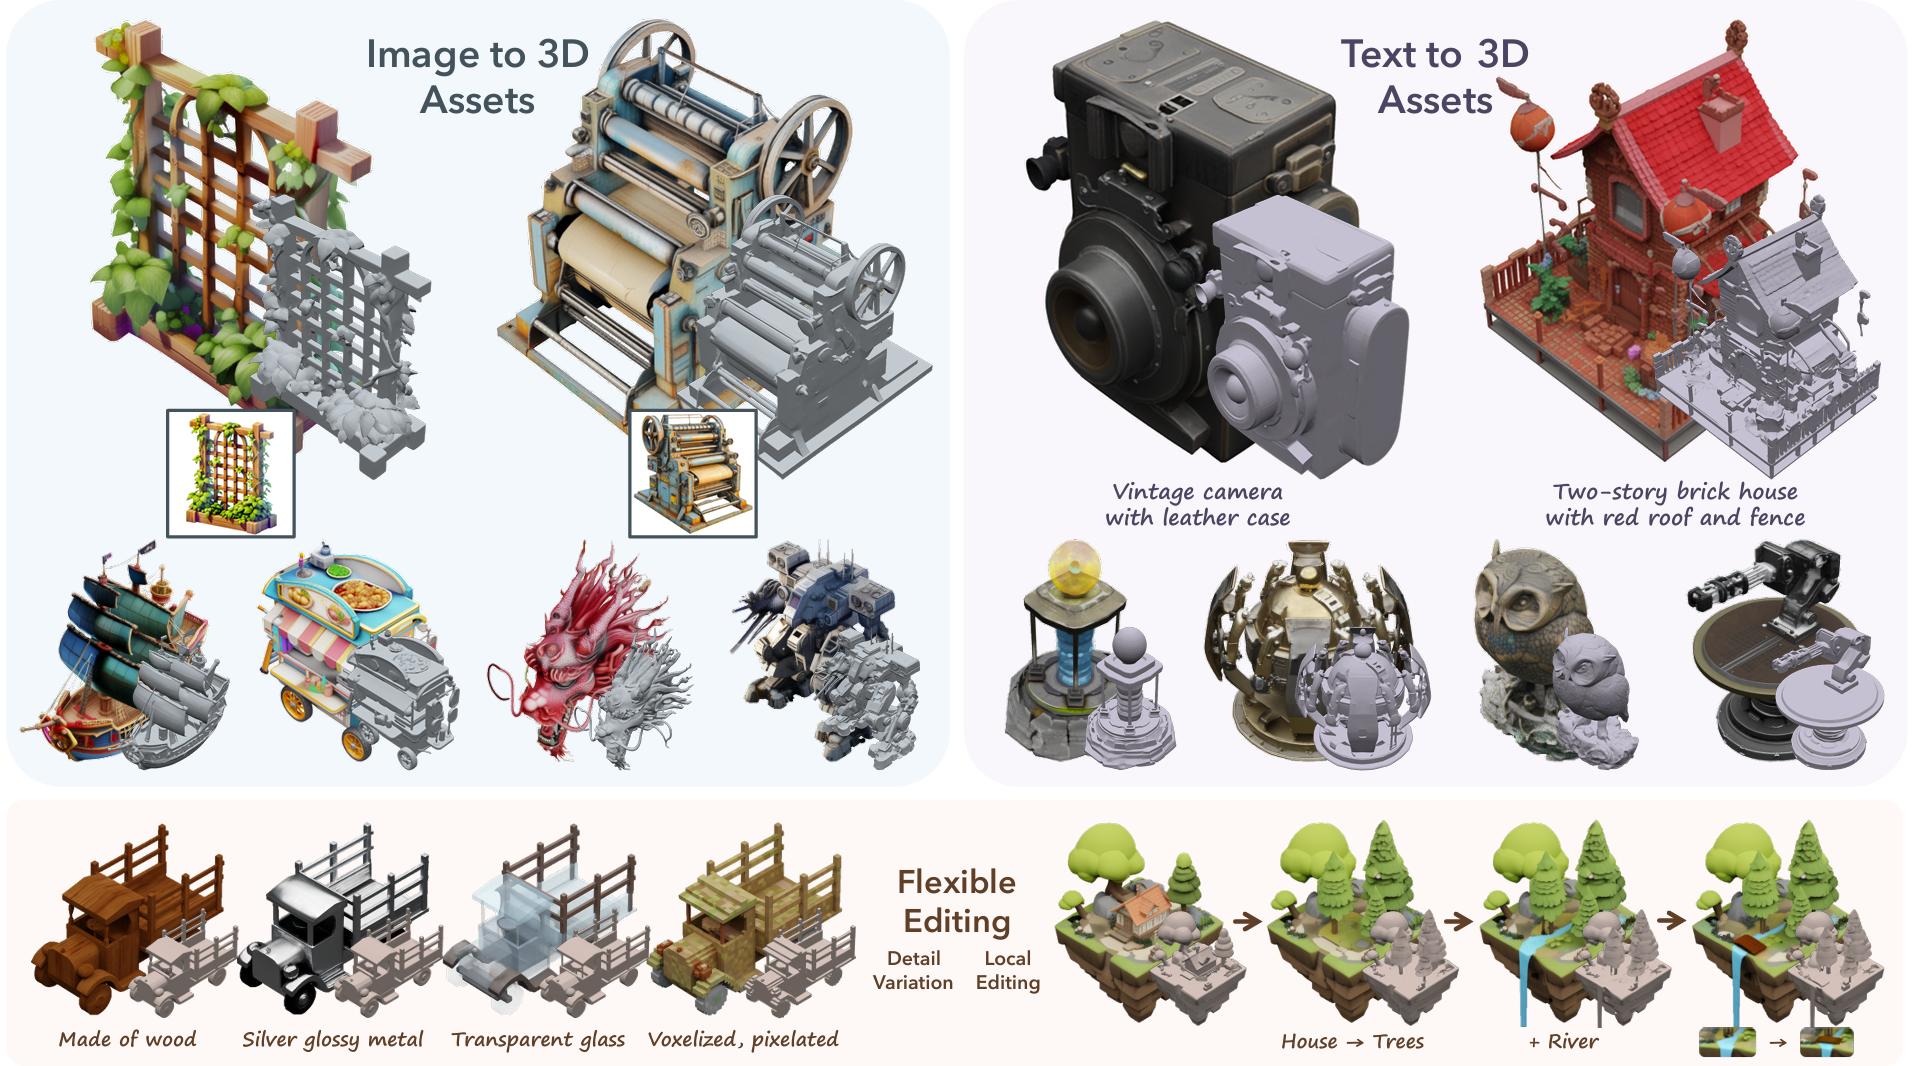 TRELLIS génère des maillages 3D texturés avec des matériaux PBR à partir d'images uniques
| Modèle | Organisation | Sortie | Caractéristique clé | Sortie | Coût/maillage |
|---|---|---|---|---|---|
| TRELLIS.2-4B | Microsoft | déc. 2025 | 4 Md de paramètres, PBR natif, jusqu'à 1536³ | Maillage texturé avec normales | ~0,03 $ |
| Hunyuan3D 2.1 | Tencent | juin 2025 | PBR de production, poids complets + code d'entraînement | Maillage texturé haute fidélité | ~0,05 $ |
| SAM 3D | Meta | nov. 2025 | Image unique vers 3D (objets + corps humain) | Maillage à partir d'une photo | ~0,02 $ |
| Stable Fast 3D | Stability AI | août 2024 | Image unique → maillage en ~0,5 s | Maillage texturé rapide | ~0,001 $ |
| TripoSG | VAST-AI | mars 2025 | Génération de forme par flux rectifié, 1,5 Md | Maillage haute qualité | ~0,01 $ |
| TripoSR | Stability / Tripo | 2024 | Reconstruction rapide à partir d'une image unique | Maillage (sans texture) | ~0,001 $ |
| UniRig | Tsinghua / Tripo | 2025 | Rigging auto : squelette + poids de skinning | Maillage riggé, animable | ~0,01 $ |
Essayez-les directement : démo TRELLIS.2 ↗ · démo Hunyuan3D ↗ · démo InstantMesh ↗
Voir des exemples : page du projet TRELLIS.2 ↗ · galerie 3D AI Studio ↗
Un flux de travail qui fonctionne vraiment
L'approche qui séduit actuellement les créateurs enchaîne plusieurs modèles. On commence par une image, générée ou photographiée, peu importe. On la fait passer par Stable Zero123 ou Wonder3D pour obtenir plusieurs vues. Ces vues sont fournies à InstantMesh ou TripoSR pour le maillage. Puis TRELLIS.2 ou Hunyuan3D pour des matériaux corrects.
TRELLIS.2 de Microsoft est le nouveau leader pour les assets prêts pour la production. Il gère la géométrie qui met en échec d'autres modèles : surfaces fines, trous, topologie complexe. La version à 4 milliards de paramètres produit des maillages avec de véritables textures PBR, et pas seulement des couleurs de sommets qui prétendent être des matériaux.
Stable Fast 3D, c'est la vitesse. Environ une demi-seconde entre l'image et le maillage. Le maillage nécessite un nettoyage et une texturation, mais pour le prototypage ? Pour vérifier si une idée fonctionne avant d'y investir des heures ? Imbattable. TripoSG est l'étape supérieure quand on veut une géométrie plus propre à partir d'une seule image.
Hunyuan3D 2.1 est le modèle ouvert de Tencent à utiliser : il fournit des poids complets et un code d'entraînement avec une texturation PBR de qualité production. Attention à la numérotation, car elle piège beaucoup de monde. Hunyuan3D 2.5, 3.0 et 3.1 existent bien mais sont uniquement accessibles via API, sans poids publics ; pour l'auto-hébergement, le générateur de base plafonne donc toujours à la version 2.1 (un fil GitHub demandant à Tencent d'ouvrir la version 2.5 est resté sans réponse en date de septembre 2026). Si vous préférez l'essayer plutôt que l'héberger, notre générateur 3D fait tourner Hunyuan3D directement dans le navigateur. Tencent a ouvert deux extensions utiles construites sur la base de 2.1 : Hunyuan3D-Omni ajoute un contrôle multi-conditions (nuage de points, voxels, squelette, boîte englobante), et Hunyuan3D-Part décompose un maillage en pièces éditables. Sa licence exclut également l'UE, le Royaume-Uni et la Corée du Sud, donc vérifiez les conditions avant de sortir un jeu dans ces régions.
SAM 3D (Meta, novembre 2025) est la nouvelle porte d'entrée : une simple photo devient un maillage 3D, avec des modèles distincts pour les objets et les corps humains. Combiné au travail de segmentation de Meta, vous pouvez isoler un objet dans une image et reconstruire uniquement cet objet.
UniRig (Tsinghua et Tripo, MIT) comble l'écart que tout le monde rencontre juste après avoir obtenu un maillage : le rigging. Il génère automatiquement un squelette valide et des poids de skinning pour un maillage donné, si bien qu'un personnage généré peut réellement être animé au lieu de rester un accessoire statique. Associez-le au travail d'animation automatique de SOMA-X de NVIDIA, et un personnage entièrement généré et entièrement riggé cesse d'être une simple démo de recherche.
Voici l'attente réaliste pour les créateurs indépendants : générez du concept art avec FLUX, passez-le dans InstantMesh pour la géométrie, puis texturez dans Blender ou utilisez TRELLIS pour un PBR automatisé. On parle de 30 à 60 minutes par asset au lieu de 4 à 8 heures. Ce n'est pas instantané, mais la différence est réelle.
Audio et musique
La génération audio n'a pas encore rattrapé l'image et la vidéo. Mais il y a déjà de quoi changer votre façon de travailler, notamment pour le prototypage et les effets sonores.
Échantillon de musique généré par IA. Décrivez l'ambiance souhaitée, obtenez une musique qui correspond
| Modèle | Organisation | Sortie | Ce qu'il fait | Licence | Coût/30 s |
|---|---|---|---|---|---|
| ACE-Step 1.5 | StepFun/ACE Studio | jan. 2026 | ~4 min de musique rapide, 19 langues, clonage vocal | MIT | ~0,02 $ |
| Stable Audio 3.0 | Stability AI | mai 2026 | Jusqu'à ~6 min de morceaux ; modèles ouverts Small, Small-SFX + Medium | Stability Community | ~0,02 $ |
| YuE | MAP | jan. 2025 | Chansons complètes à partir de paroles, voix + accompagnement | Apache 2.0 | ~0,05 $ |
| MusicGen | Meta | 2023 | Texte vers musique, contrôlable | code MIT / poids CC-BY-NC | ~0,01 $ |
| DiffRhythm 2 | ASLP-lab | fév. 2026 | Génération rapide de morceaux complets | Apache 2.0 | ~0,02 $ |
| Magenta RealTime | juin 2025 | Musique en temps réel, pilotable par prompt | code Apache / poids CC-BY | ~0,02 $ |
Essayez-les directement : démo MusicGen ↗ · terrain de jeu AudioCraft ↗
Voir des exemples : exemples MusicGen ↗ · échantillons AudioGen ↗
Ce que vous pouvez vraiment sortir avec
MusicGen de Meta reste un choix pratique pour prototyper l'audio d'un jeu. Décrivez l'ambiance recherchée, obtenez une musique adaptée, et le tout tourne sans problème sur un GPU de 12 Go. Un piège de licence à connaître : le code de MusicGen est sous MIT, mais les poids du modèle sont sous CC-BY-NC (non commercial), donc utilisez-le pour prototyper et passez à un modèle sous licence commerciale comme ACE-Step ou Stable Audio pour tout ce que vous sortez réellement.
Le modèle ouvert d'effets sonores de Stable Audio (Small-SFX) gère les bruits de pas, les grincements de portes, le vent ambiant et les sons mécaniques, tourne en local, et est distribué sous la licence communautaire de Stability, ce qui en fait l'option SFX ouverte à privilégier quand vous avez besoin de sons réellement utilisables commercialement. C'est celui à choisir, car les autres modèles SFX ouverts ont des contreparties : AudioGen de Meta est sous CC-BY-NC et TangoFlux relève de la licence communautaire non commerciale de Stability, donc les deux sont réservés au prototypage pour un jeu commercialisé.
Magenta RealTime (Google) est l'exception dans le bon sens : c'est le seul modèle à poids ouverts conçu pour la musique en temps réel, pilotable en continu par prompt. Au lieu de produire un morceau fini, il génère de la musique en direct que vous pouvez orienter pendant qu'elle joue, ce qui correspond exactement à une bande-son de jeu adaptative qui évolue selon les actions du joueur. Le code est sous Apache 2.0 et les poids sous CC-BY, les deux étant adaptés à un usage commercial.
YuE est vraiment enthousiasmant. C'est le premier modèle ouvert capable de générer des chansons complètes avec voix. Des génériques. De la musique de fond avec un véritable chant. La qualité varie, mais c'est loin devant tout ce que vous pouvez télécharger et faire tourner vous-même.
ACE-Step est le modèle musical ouvert à connaître aujourd'hui, et son évolution a été rapide : la lignée 1.5 (janvier 2026, avec une variante XL à 5 Md plus grande) succède à la version originale de mai 2025 et est désormais sous licence MIT. Il génère rapidement plusieurs minutes de musique, prend en charge 19 langues, et gère le clonage vocal, le remix et l'édition des paroles. Pour le prototypage de jeux, il comble une bonne partie de l'écart que laissaient YuE et MusicGen.
Stable Audio 3.0 (mai 2026) est la mise à jour la plus importante côté son. Il peut générer des morceaux d'environ six minutes, et Stability a rendu ouverts trois des quatre variantes : Small et le modèle dédié aux effets sonores Small-SFX tournent tous deux sur l'appareil, et Medium ajoute une meilleure structure musicale ainsi que la durée complète des morceaux. Seul le modèle Large est resté uniquement accessible via API. Small-SFX est désormais l'option ouverte la plus solide spécifiquement pour les SFX de jeux vidéo. Les trois modèles ouverts sont distribués sous la Stability AI Community License, qui permet d'utiliser et de vendre ce qu'ils génèrent, avec une Enterprise License pour les entreprises dépassant 1 M$ de chiffre d'affaires annuel, selon l'annonce de Stability. Toute la famille a été entraînée sur des données sous licence, ce qui donne une assise juridique plus solide que les générateurs de musique aux procès non résolus.
Voici l'avis honnête : l'écart entre les modèles ouverts et les modèles fermés (Suno, Udio) se réduit mais reste réel pour les chansons vocales complètes, et ces outils fermés traînent aussi des litiges non résolus sur les données d'entraînement. Pour les effets sonores, les modèles ouverts (en particulier le modèle SFX de Stable Audio) sont réellement compétitifs. Pour les chansons que vous voulez sortir, attendez-vous à beaucoup d'itérations, ou faites appel à un musicien pour la production finale et utilisez ces outils pour tout le reste.
Voix et parole
La génération vocale est désormais largement « suffisamment bonne pour les jeux », et cela change ce qui devient possible pour les petites équipes.
Narration de jeu générée par IA avec un discours naturel, un rythme adapté et de l'émotion
| Modèle | Organisation | Sortie | Caractéristique clé | Licence | Coût/min |
|---|---|---|---|---|---|
| Qwen3-TTS | Alibaba | jan. 2026 | Clonage vocal en 3 s, design vocal, 10 langues | Apache 2.0 | ~0,002 $ |
| Chatterbox | Resemble AI | 2025 | Contrôle des émotions, clonage dès ~5 s, 23 langues | MIT | ~0,003 $ |
| CSM | Sesame AI | mars 2025 | Flux conversationnel, pauses naturelles | Apache 2.0 | ~0,005 $ |
| Fish Speech 1.5 | Fish Audio | 2024 | Clonage zero-shot en 10-30 s | code Apache / poids CC-BY-NC-SA | ~0,002 $ |
| OpenVoice V2 | MyShell/MIT | avr. 2024 | Contrôle des émotions/accents | MIT | ~0,003 $ |
| XTTS-v2 | Coqui (communauté) | 2024 | 17 langues, clonage vocal | CPML (non commercial) | ~0,005 $ |
Écouter des échantillons : voix Fish Audio ↗ · démo OpenVoice ↗
Faire en sorte que les PNJ sonnent comme des humains
CSM (Conversational Speech Model) de Sesame a été conçu spécifiquement pour le dialogue. Il produit des pauses naturelles. Des changements d'intonation. Le rythme d'une conversation réelle. La plupart des TTS sonnent comme quelqu'un qui lit un script, et on l'entend instantanément. CSM sonne comme quelqu'un qui parle vraiment. Cette différence compte plus qu'on ne le pense.
Qwen3-TTS (Alibaba, janvier 2026) est celui vers lequel se tourner pour des projets commerciaux. Toute la famille est sous Apache 2.0, elle clone une voix à partir d'environ 3 secondes d'audio de référence, parle 10 langues, et prend en charge le design vocal par description, si bien que vous pouvez spécifier la voix d'un PNJ en texte brut plutôt que de chercher des enregistrements de référence. Les modèles 0.6B et 1.7B tournent sur du matériel modeste. Chatterbox (Resemble AI) est le choix pour la voix expressive, et il est sous licence MIT, donc vous pouvez l'utiliser en production. Il clone une voix à partir d'environ 5 secondes, tourne avec une latence inférieure à 200 ms, couvre 23 langues, et c'est le premier modèle ouvert doté d'un contrôle d'exagération émotionnelle, si bien qu'un PNJ peut vraiment sembler en colère ou effrayé plutôt que monotone. Deux autres options sous Apache-2.0 comblent des niches précises : Orpheus (Canopy) prend en charge des balises d'émotion inline comme <laugh> et <sigh> qui correspondent parfaitement aux exclamations de PNJ, et propose une variante de 150M pour le matériel bas de gamme, tandis que Dia (Nari Labs) est conçu pour le dialogue multi-locuteurs avec des sons non verbaux comme la toux et le rire en une seule passe. Voxtral TTS de Mistral (mars 2026) est un nouvel arrivant à poids ouverts visant les agents vocaux, selon la page d'actualités de Mistral, mais lisez bien sa licence avant de l'utiliser en production.
Fish Speech et OpenVoice gèrent le clonage vocal. Enregistrez 10 à 30 secondes d'une voix d'acteur, puis générez un dialogue illimité avec cette voix. Réfléchissez à ce que cela implique : vous pouvez engager des comédiens de voix pour les répliques clés, puis étendre leur performance pour couvrir des centaines de variations et de dialogues d'ambiance. Une remarque importante sur la licence de Fish Speech : le code est ouvert mais les poids 1.5 sont sous CC-BY-NC-SA, ce qui en fait un outil de prototypage. Pour les jeux publiés, utilisez plutôt OpenVoice (MIT) ou Qwen3-TTS (Apache 2.0).
NVIDIA ACE (pas entièrement ouvert, mais à connaître) prend désormais en charge Qwen3-8B pour le déploiement de PNJ sur l'appareil. LLM local + TTS local + synchronisation labiale, le tout fonctionnant sur des GPU grand public. C'est la pile technologique pour des conversations de PNJ en temps réel qui n'ont pas besoin d'appels au cloud.
L'approche qui a du sens pour les créateurs indépendants : engagez des comédiens de voix pour les personnages principaux et les répliques qui comptent le plus. Utilisez Qwen3-TTS ou OpenVoice pour étendre la couverture aux dialogues d'ambiance, aux variations, et à toutes les répliques secondaires qui resteraient sinon muettes ou d'un coût prohibitif.
Modèles de monde et simulation de jeu
C'est là que les choses deviennent franchement étranges, et franchement passionnantes. Ces modèles ne génèrent pas d'assets statiques. Ils génèrent des expériences qui ressemblent à des jeux.
🎮 Jouez à Oasis : Minecraft généré par IAGénération de monde en temps réel sans moteur de jeu, juste une prédiction par IA
| Modèle | Organisation | Sortie | Ce qu'il fait | Statut | Coût/image |
|---|---|---|---|---|---|
| DIAMOND | Recherche | 2024 | Modèle de monde par diffusion, simulation Atari | Poids ouverts | ~$0,001 |
| Oasis | Decart/Etched | Oct 2024 | Génération Minecraft en temps réel | Poids 500M ouverts | ~$0,002 |
| MineWorld | Microsoft | Avr 2025 | Minecraft en temps réel, alternative ouverte à Oasis | MIT | ~$0,002 |
| Hunyuan-GameCraft | Tencent | Août 2025 | Vidéo de jeu interactive, contrôle clavier/souris | Tencent Community | ~$0,005 |
| GameGen-X | Recherche | 2024 | Génération vidéo de monde ouvert | Code + jeu de données ouverts | ~$0,005 |
| NVIDIA Cosmos | NVIDIA | Oct 2025 | Simulation d'IA physique (Predict2.5) | Licence NVIDIA Open Model | ~$0,01 |
| Matrix-Game 3.0 | Skywork | Mars 2026 | Mondes interactifs en 720p temps réel, mémoire longue durée | Poids ouverts | ~$0,005 |
| Genie 2 | DeepMind | Déc 2024 | 3D interactif à partir d'images | Non publié | N/A |
| Genie 3 | DeepMind | Août 2025 | Mondes 720p temps réel, événements sur commande | Fermé (Project Genie) | N/A |
Consultez la recherche : Page du projet DIAMOND ↗ · Blog Cosmos ↗
Essayez-le : Démo live d'Oasis ↗ · Exemples Genie 2 ↗
Pourquoi cela devrait vous intéresser
DIAMOND a démontré quelque chose qui change la façon de penser l'IA de jeu. Vous pouvez entraîner un agent entièrement à l'intérieur d'un monde généré. Aucun véritable moteur de jeu nécessaire pour l'entraînement. L'IA joue dans l'imagination d'un modèle de diffusion, puis transfère ses acquis au vrai jeu. Les implications ici sont significatives.
Oasis fait tourner un monde de type Minecraft en temps réel. Image par image. Pas de moteur de jeu, pas de textures, pas d'assets préconstruits. Juste un transformer qui prédit ce qui vient ensuite. C'est une preuve de concept, mais imaginez où cela peut mener. La version à 500 millions de paramètres est déjà ouverte.
GameGen-X a publié le plus grand jeu de données pour la vidéo de jeu en monde ouvert. Si vous voulez entraîner vos propres modèles ou affiner des modèles existants pour générer du contenu de type jeu vidéo, c'est votre point de départ.
NVIDIA Cosmos a été conçu pour la robotique et les véhicules autonomes, mais les modèles de monde fondamentaux fonctionnent aussi pour les jeux. Ils comprennent la physique. La permanence des objets. Les relations spatiales. La ligne ouverte actuelle est Cosmos-Predict2.5, publiée en octobre 2025 sous la licence NVIDIA Open Model, qui autorise l'usage commercial et les dérivés.
Hunyuan-GameCraft (Tencent, août 2025) est le modèle de monde ouvert le plus directement façonné pour le jeu vidéo. Il a été entraîné sur plus d'un million d'enregistrements issus de plus de 100 jeux AAA et unifie les entrées clavier et souris dans un espace de contrôle partagé, si bien qu'il génère une vidéo de jeu interactive que l'on pilote vraiment, plutôt que de simplement la regarder. Il porte la même Tencent Community License que Hunyuan3D, avec la même exclusion UE, Royaume-Uni et Corée du Sud, donc vérifiez les conditions avant d'y déployer votre jeu. MineWorld (Microsoft, MIT) est le pendant totalement permissif d'Oasis : un modèle de monde Minecraft en temps réel que vous pouvez télécharger et exécuter sans moteur de jeu.
Genie 3 (DeepMind, annoncé en août 2025) est le bond en avant à retenir : le premier modèle de monde avec interaction en temps réel, générant des mondes navigables en 720p à 24 images par seconde qui restent cohérents pendant quelques minutes, plus des « événements de monde programmables » qui changent la météo ou ajoutent des objets sur commande. Il s'est ouvert au public sous le nom de Project Genie en janvier 2026 pour les abonnés Google AI Ultra aux États-Unis. Les poids restent fermés, mais cela montre où se dirigent les mondes générés et jouables.
Matrix-Game 3.0 (Skywork, mars 2026) est la réponse ouverte à Genie. C'est un modèle de monde interactif augmenté par mémoire qui diffuse du 720p à 40 images par seconde en temps réel et garde des scènes cohérentes sur des séquences de plusieurs minutes. Une version distillée de 5B gère l'inférence en temps réel, une version MoE plus grande de 2x14B pousse la qualité, et les poids sont sur Hugging Face sous Apache 2.0. Si vous voulez expérimenter des mondes générés jouables dès aujourd'hui au lieu d'attendre DeepMind, c'est celui que vous pouvez réellement télécharger.
Pour le développement de jeux concret aujourd'hui, ce sont encore des outils de recherche. Mais si vous travaillez sur du contenu piloté par IA, de la génération procédurale, ou si vous réfléchissez simplement à la direction que prend tout cela, c'est ici que se trouve la frontière.
Grands modèles de langage
Les LLM alimentent les dialogues, la génération de quêtes et la logique de jeu. Et les options ouvertes rivalisent désormais vraiment avec GPT-4. Ce n'était pas le cas il y a deux ans.
| Modèle | Organisation | Sortie | Taille | Idéal pour | Licence | Coût/1K tok |
|---|---|---|---|---|---|---|
| DeepSeek-V3 | DeepSeek | Déc 2024 | 671B MoE (37B actifs) | Raisonnement, généraliste | Permissive | ~$0,02 |
| DeepSeek-R1 | DeepSeek | Jan 2025 | Basé sur V3 | Chaîne de raisonnement | Permissive | ~$0,03 |
| DeepSeek-V3.2 | DeepSeek | Déc 2025 | Attention creuse (DSA) | Raisonnement + usage d'outils | MIT | ~$0,02 |
| DeepSeek-V4 | DeepSeek | Avr 2026 | 1,6T MoE (49B actifs) | Raisonnement de pointe, contexte 1M | MIT | ~$0,02 |
| GLM-5 | Zhipu / Z.ai | Fév 2026 | 744B MoE (40B actifs) | Code, agentique, usage d'outils | MIT | ~$0,02 |
| GLM-5.2 | Zhipu / Z.ai | Juin 2026 | 753B MoE | Code, agents, contexte 1M | MIT | ~$0,02 |
| GPT-OSS | OpenAI | Août 2025 | MoE 120B / 20B | Raisonnement, usage d'outils, sur l'appareil | Apache 2.0 | ~$0,01 |
| Kimi K2 | Moonshot | 2025 | 1T MoE (32B actifs) | Agentique, code | MIT modifiée | ~$0,02 |
| Kimi K3 | Moonshot | Juil 2026 | 2,8T MoE (16 experts actifs sur 896) | Agentique de pointe, code, contexte 1M, vision | Licence Kimi K3 | ~$0,03 |
| Hy3 | Tencent | Juil 2026 | 295B MoE (21B actifs) | Raisonnement, code agentique, contexte 256K | Apache 2.0 | ~$0,02 |
| Gemma 3 | 2025 | 1B-27B | Sur l'appareil, 140 langues, vision | Gemma | ~$0,01 | |
| Gemma 4 | Avr 2026 | E2B à 31B (26B-A4B MoE) | Sur l'appareil, 140+ langues, vision + audio, 256K | Apache 2.0 | ~$0,01 | |
| Qwen3 | Alibaba | 2025 | 235B MoE (22B actifs) | Multilingue, code | Apache 2.0 | ~$0,01 |
| Qwen3.5 / 3.6 / 3.8 | Alibaba | Fév-Août 2026 | 0,8B à 2,4T-A95B | Multimodal, agentique, fer de lance ouvert de classe Qwen-Max | Apache 2.0 | ~$0,02 |
| Mistral Small 4 | Mistral | Mars 2026 | 119B MoE (6B actifs) | Raisonnement + vision + code agentique, 256K | Apache 2.0 | ~$0,01 |
| Qwen3-Coder | Alibaba | 2025 | 480B MoE (35B actifs) | Code agentique, contexte 256K | Apache 2.0 | ~$0,02 |
| Llama 4 | Meta | 2025 | Diverses | Agents, contexte jusqu'à 10M | Llama Community | ~$0,01 |
| Muse Glimmer 30B | Meta | Août 2026 | ~30B dense | Agents sur l'appareil, vision, contexte 128K+ | Apache 2.0 | ~$0,01 |
| Qwen3-VL | Alibaba | 2025 | 2B-235B | Vision + langage | Apache 2.0 | ~$0,02 |
| InternVL3 | Shanghai AI Lab | 2025 | 1B-78B | Vision, OCR, ancrage d'interface | MIT | ~$0,02 |
Pour commencer : Qwen3-8B sur HuggingFace ↗ · DeepSeek-V3 sur HuggingFace ↗ · GLM-5 sur HuggingFace ↗
Pour créer des jeux
Qwen3 est le choix pratique pour la plupart des usages en jeu vidéo. Licence Apache 2.0, ce qui signifie que vous possédez votre intégration. Bon support multilingue, ce qui compte si vous pensez à la localisation. Bon suivi des instructions structurées. Les variantes 7B et 14B tournent localement sur des GPU grand public.
Qwen3.5, 3.6 et 3.8 ont maintenu la lignée Apache 2.0 tout au long de 2026. Qwen3.5 (16 février 2026) a débuté avec un MoE 397B-A17B, puis a complété avec des variantes denses de 27B, 9B et 4B. Qwen3.6 (avril) a affiné la même famille pour la stabilité, et son 35B-A3B est le point idéal en local : 35B de connaissances avec seulement 3B actifs par jeton, ce qui le fait voler sur une seule carte de 24 Go. Qwen3.8 (12-14 août 2026) est le grand modèle, décrit dans le dépôt Qwen3.8 comme le premier modèle de classe Qwen-Max porté en accès ouvert, sous forme d'un modèle phare 2,4T-A95B accompagné d'un modèle dense de 27B, tous deux sous Apache 2.0 avec un contexte de 262K.
DeepSeek-V3 égale ou dépasse GPT-4 sur la plupart des benchmarks. L'architecture est astucieuse : seulement 37B paramètres s'activent par jeton malgré un total de 671B. Il vous faut du matériel sérieux (multi-GPU), mais la qualité est de niveau frontière sans dépendance à une API.
DeepSeek-V3.2 (décembre 2025) intègre le raisonnement et l'usage d'outils dans un seul modèle et introduit DeepSeek Sparse Attention (DSA) pour une inférence à long contexte moins coûteuse, avec une variante Speciale à haute puissance de calcul visant les meilleurs benchmarks de raisonnement. Pour la logique de jeu et le dialogue, c'est un remplacement plus solide et plus capable en tant qu'agent que V3.
DeepSeek-V4 (avril 2026) a de nouveau repoussé la frontière ouverte. V4-Pro est un MoE de 1,6T paramètres avec seulement 49B actifs par jeton, une fenêtre de contexte d'un million de jetons, et des modes de raisonnement sélectionnables, le tout sous MIT. La variante V4-Flash (284B au total, 13B actifs) conserve le contexte de 1M dans un format qui n'exige pas un cluster GPU complet. Si vous choisissez un modèle ouvert pour une logique de quête complexe ou un contexte d'état de jeu étendu aujourd'hui, c'est ici que se trouve le plafond.
GLM-5 (Zhipu AI, février 2026) est le modèle ouvert à battre pour le code et le travail agentique, et le rafraîchissement GLM-5.2 a fait grimper ses scores d'usage d'outils et de planification à long terme près de la frontière fermée. C'est un MoE de 744 milliards de paramètres avec 40B actifs par jeton, un contexte de 200K jetons, et une licence MIT. GLM-5.2 lui-même est sorti le 17 juin 2026 sous forme d'un MoE de 753B avec un contexte d'1M jetons, toujours sous MIT sans limite régionale, et GLM-5.3, un rafraîchissement post-entraînement sur la même base, a suivi avec ses poids sur Hugging Face sous la propre licence GLM-5.3 de Z.ai plutôt que MIT, donc vérifiez ce texte si vous auto-hébergez le plus récent. Z.ai est la première entreprise de modèles fondamentaux cotée en bourse et tarife son API hébergée de façon agressive (environ $1,40 par million de jetons en entrée), mais les poids sont sur Hugging Face si vous préférez l'auto-hébergement. Si votre jeu s'appuie sur un LLM pour le scriptage de quêtes, des agents à appel d'outils, ou des systèmes pilotés par code, GLM-5 est une solide alternative à OpenAI que vous contrôlez entièrement. GPT-OSS (OpenAI, août 2025) est la première publication à poids ouverts d'OpenAI, et elle tombe pile dans le thème de ce guide. Le modèle gpt-oss-120b raisonne et appelle des outils à un niveau proche de o4-mini sur un seul GPU 80 Go, et gpt-oss-20b tourne sur une carte grand public de 16 Go, tous deux sous licence Apache 2.0. Si vous voulez un modèle d'un laboratoire occidental que vous pouvez auto-héberger pour la logique de PNJ ou des agents utilisant des outils, c'est celui-là.
Kimi K2 (Moonshot) est l'autre poids lourd agentique ouvert aux côtés de GLM-5 et DeepSeek. C'est un MoE à 1 000 milliards de paramètres avec 32 Md actifs, réglé à fond pour le code et l'usage d'outils, et sa licence MIT modifiée n'ajoute des restrictions qu'au-delà de 100 millions d'utilisateurs mensuels, donc pour les indés c'est effectivement du MIT. Utilisez-le quand un agent doit planifier sur de nombreuses étapes.
Kimi K3 (Moonshot, juillet 2026) est le plus grand modèle à poids ouverts jamais annoncé, et il se rapproche de la frontière fermée plus que n'importe quel modèle ouvert avant lui. C'est un MoE à 2,8 billions de paramètres avec seulement environ 50 Md actifs par jeton (16 experts sur 896), un contexte de 1 M de jetons, et une vision native, construit sur deux nouvelles conceptions d'attention appelées Kimi Delta Attention et Attention Residuals. Les benchmarks de juillet de Moonshot le montraient battant les versions de Claude Opus et GPT-5.5 de l'époque sur le code et les tâches agentiques, et ne suivant que les tout meilleurs modèles propriétaires, des cibles qui ont depuis à nouveau bougé avec Claude Fable 5.1 et GPT-6 Astra en septembre. Les poids sont arrivés sur Hugging Face le 27 juillet 2026 en MXFP4, sous la Kimi K3 License plutôt que MIT. Elle est permissive pour la plupart des usages, mais une entreprise de modèle-en-tant-que-service dépassant 20 millions de $ de revenus sur une période de 12 mois quelconque doit passer un accord séparé avec Moonshot, et les produits dépassant 100 millions d'utilisateurs mensuels ou 20 millions de $ de revenus mensuels doivent afficher « Kimi K3 » dans l'interface. Auto-héberger un modèle de 2,8 T nécessite toujours un cluster GPU multi-nœuds, donc la plupart des équipes y accéderont via l'API à 3 $ par million de jetons en entrée et 15 $ par million en sortie. Pour des agents que vous pouvez réellement faire tourner vous-même, K2 reste le choix Moonshot pratique, mais K3 redéfinit ce que « ouvert » peut signifier au sommet.
Gemma 3 (Google) est le meilleur choix quand vous devez tourner sur le matériel du joueur ou localiser largement. Il existe en tailles 1B, 4B, 12B et 27B, donc il s'adapte à partir d'une carte 8 Go, gère 140 langues, fait de l'appel de fonctions, et les variantes 4B et au-dessus voient aussi les images, ce qui en fait doublement un petit modèle de vision. La licence Gemma autorise l'usage commercial.
Gemma 4 (Google, 2 avril 2026) le remplace pour les nouveaux projets et règle carrément la question de la licence : toute la famille est en Apache 2.0, selon la fiche modèle. Elle est livrée en E2B et E4B pour téléphones et ordinateurs portables, un 12B, un MoE 26B-A4B avec moins de 4B actifs, et un dense 31B, avec un contexte de 128K sur les petits modèles et 256K sur les autres, une entrée image native sur toutes les tailles et l'audio sur les petites, et plus de 140 langues. Pour un cerveau de PNJ embarqué qui doit aussi regarder une capture d'écran, le 26B-A4B est le choix.
La lignée Llama de Meta est effectivement en pause. Llama 4 (avril 2025) est toujours le dernier Llama, et en avril 2026 Meta Superintelligence Labs a lancé son successeur, Muse Spark, en tant que modèle fermé. Meta est partiellement revenu en août 2026 avec Muse Glimmer 30B, un modèle multimodal dense d'environ 30B sous Apache 2.0 avec un contexte de 128K+ et des versions 4-bit qui tiennent sur une carte 24 Go. C'est un solide modèle d'agent local, mais si vous attendiez un Llama 5, arrêtez d'attendre et choisissez plutôt parmi Qwen, Gemma 4 ou Glimmer.
Hy3 (Tencent, juillet 2026) est l'autre grande arrivée en Apache 2.0. C'est un MoE de 295B avec 21B actifs et un contexte de 256K, selon sa fiche modèle, et la sortie de juillet a supprimé les exclusions régionales que portait la préversion d'avril, donc contrairement aux licences Hunyuan3D et GameCraft de Tencent, il est utilisable dans l'UE, au Royaume-Uni et en Corée du Sud.
Qwen3-Coder (Alibaba) est le modèle de code ouvert dédié, remplaçant l'ancienne lignée DeepSeek-Coder pour la plupart des usages. C'est un MoE de 480B avec 35B actifs, un contexte natif de 256K (extensible à 1M), Apache 2.0, et il est dans la même catégorie que Claude-Sonnet sur les benchmarks de code agentique. Si votre jeu génère ou exécute du code, c'est le plafond ouvert. La famille européenne Mistral est une solide alternative auto-hébergeable : Devstral pour le code, et Mistral Small 4 (16 mars 2026), un MoE de 119B avec 6B actifs qui réunit raisonnement, vision et code agentique en un seul modèle Apache 2.0 avec un contexte de 256K.
Qwen3-VL ajoute la compréhension visuelle, avec des tailles denses et MoE allant de 2B à 235B sous Apache 2.0. Utile pour les jeux qui doivent analyser des captures d'écran, comprendre du contenu dessiné par le joueur, ou traiter une entrée caméra. La variante 8B tourne sur un seul GPU. InternVL3 (Shanghai AI Lab, MIT) est l'autre solide option de modèle vision-langage ouvert, notamment bon en OCR et en repérage d'interface, ce qui compte si votre outillage doit lire des interfaces de jeu ; Pixtral 12B de Mistral (Apache 2.0) est un choix plus léger et sûr pour un usage commercial.
Pour des PNJ embarqués, des personnages qui répondent en temps réel sans appels au cloud, Qwen3-8B via NVIDIA ACE est la voie la plus pratique actuellement. Il tourne aux côtés de votre jeu sur le matériel du joueur.
Modèles utilitaires
Ceux-ci ne génèrent pas de contenu directement, mais ils font fonctionner vos pipelines.
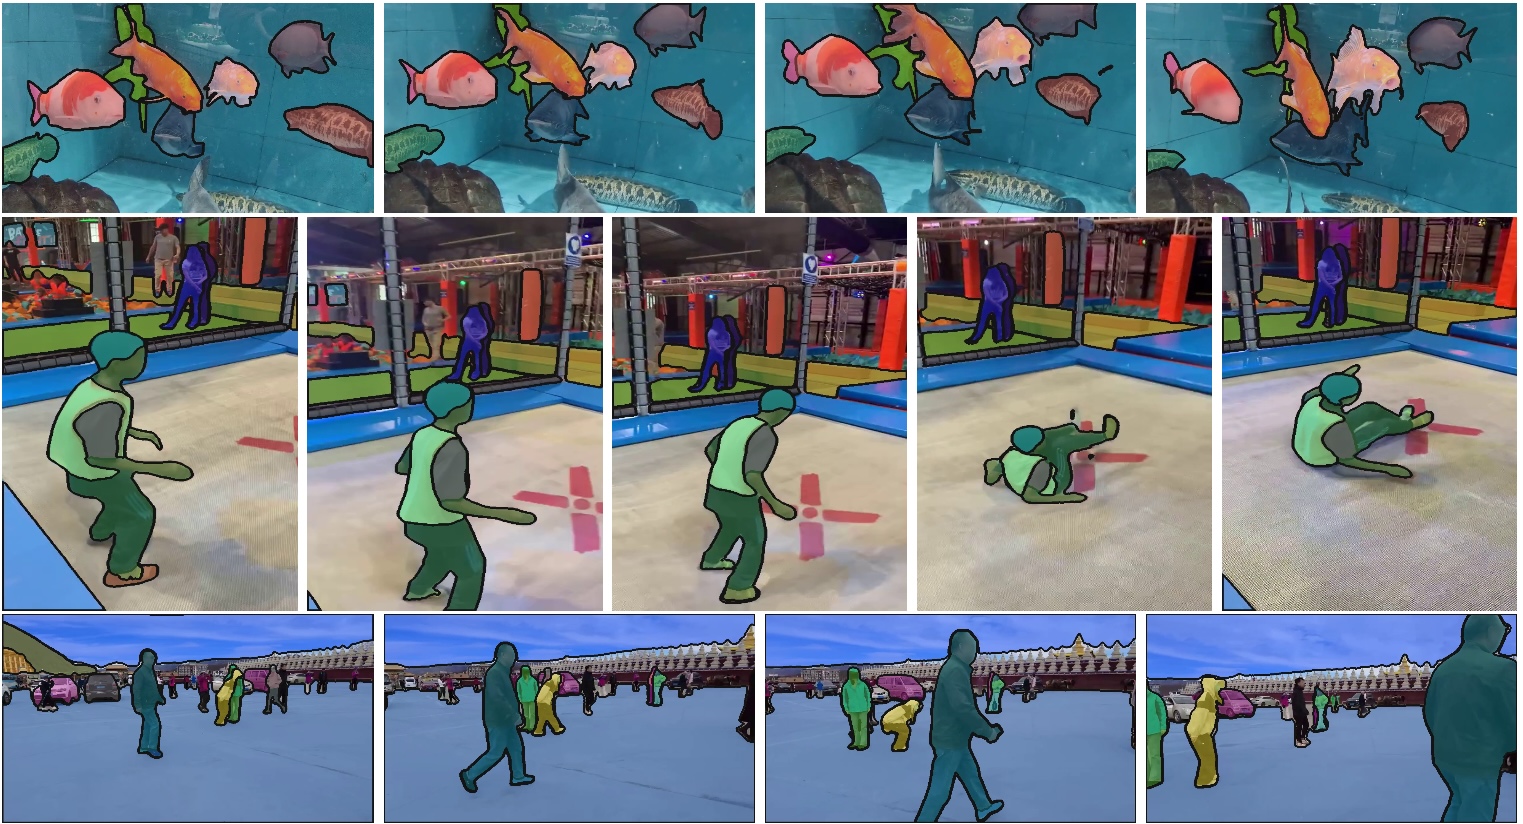 SAM 2 segmente n'importe quel objet dans des images et des vidéos. Cliquez une fois, obtenez un masque parfait
| Modèle | Organisation | Sortie | Ce qu'il fait |
|---|---|---|---|
| SAM 2 | Meta | Août 2024 | Segmente tout dans des images et des vidéos |
| Depth Pro | Apple | Oct 2024 | Profondeur métrique à partir d'une seule image |
| gsplat | Nerfstudio | 2024+ | Gaussian splatting, accéléré CUDA |
SAM 2 segmente les objets dans une vidéo en temps réel. Cliquez sur quelque chose, obtenez un masque parfait. Utile pour la rotoscopie, le compositing, ou l'extraction d'objets à partir de séquences pour les utiliser comme assets de jeu. Essayer SAM 2 ↗
Depth Pro d'Apple produit des cartes de profondeur métriques à partir d'images uniques en moins d'une seconde. Cela ouvre beaucoup de possibilités : convertir de l'art 2D en 2.5D avec des effets de parallaxe, générer des données de profondeur pour la reconstruction 3D, et créer des normal maps à partir d'images plates. Depth Pro sur HuggingFace ↗
gsplat est l'implémentation rapide du Gaussian splatting. Si vous capturez des environnements réels pour des jeux, que ce soit par photogrammétrie ou scan d'environnement, c'est la bibliothèque qui rend cela praticable.
Ce que j'utiliserais vraiment
Si vous démarrez un projet de jeu aujourd'hui, voici la pile qui a du sens :
Textures et sprites : FLUX.1 [schnell], Apache 2.0, itération rapide, qualité livrable
Concept art : SD 3.5 Large avec des LoRA pour le contrôle du style
Assets 3D : Hunyuan3D 2.1 ou TRELLIS.2 pour des maillages texturés, SAM 3D quand vous partez d'une photo, puis Blender pour le nettoyage
Auto-rigging : UniRig ou NVIDIA SOMA-X pour squeletter et pondérer les maillages générés (tous deux ouverts) au lieu de dépendre de Mixamo
Effets sonores : le modèle Small-SFX ouvert de Stable Audio, tourne localement, licence commerciale
Musique : ACE-Step pour les prototypes, puis faites appel à un compositeur pour la production finale
Voix : Qwen3-TTS pour le clonage et le dialogue ambiant (Apache 2.0), Chatterbox (MIT) quand une réplique a besoin d'une vraie émotion, des acteurs vocaux pour les répliques qui comptent
Dialogue de PNJ : Qwen3.6-35B-A3B, Gemma 4 26B-A4B, ou Muse Glimmer 30B en local, ou un LLM cloud auto-hébergeable (GLM-5.2, DeepSeek-V4, ou Kimi K3) pour le raisonnement complexe et l'usage d'outils
Vidéo (cinématiques) : Mochi 1 ou Wan 2.2 5B en local, LTX-2.5 ou HunyuanVideo-1.5 sur le cloud quand vous avez besoin de la qualité finale
Voici le fond du problème avec tout ça : l'erreur courante est d'essayer d'utiliser l'IA pour tout. Ce sont des outils, pas des remplacements. Ils compressent les parties fastidieuses comme l'itération, les variations, et les assets provisoires, afin que vous puissiez consacrer votre temps aux décisions créatives qui comptent vraiment. Les parties qui font que votre jeu vous ressemble.
Vérité sur le matériel nécessaire
Soyons honnêtes sur ce dont vous avez réellement besoin pour faire tourner tout ça :
8 Go de VRAM (RTX 3060, 4060) : SD 1.5/SDXL, Wan 2.1 petit, AudioGen, Fish Speech, petits LLM (7B quantifié). C'est le territoire des ordinateurs portables de gaming, et c'est suffisant pour se lancer.
12 Go de VRAM (RTX 3080, 4070) : SD 3.5, FLUX schnell, Mochi 1, MusicGen, TripoSR, Qwen 14B quantifié. C'est là que les choses deviennent confortables. La plupart des modèles utiles tournent ici.
24 Go de VRAM (RTX 3090, 4090) : la plupart des modèles en pleine précision, InstantMesh, des LLM plus grands, et le palier d'agent local 2026 : Qwen3.6-35B-A3B, Gemma 4 31B en 4-bit, Muse Glimmer 30B en 4-bit. Si vous êtes sérieux sur ce workflow, c'est le point idéal.
48-80 Go de VRAM (A100, H100) : HunyuanVideo, LTX-2, DeepSeek-V3, génération à l'échelle production. Matériel d'entreprise. Vous n'achetez pas ça, vous le louez.
Les instances cloud sur RunPod, Lambda Labs, ou Modal coûtent 2 à 4 $/heure pour des A100. Pour un usage occasionnel, c'est moins cher que le matériel. Lancez-les quand vous avez besoin de la qualité finale, éteignez-les quand vous avez terminé.
À propos des estimations de coûts dans ce guide : les coûts par génération supposent une inférence auto-hébergée sur des GPU cloud à environ 2-3 $/heure (A100) ou environ 0,40 $/heure (RTX 4090). Les coûts réels varient selon le matériel, l'optimisation, et les tailles de lots. Ce sont des chiffres approximatifs pour la planification, donc vos résultats peuvent varier.
Les nouveautés de 2026
Récemment sorti : LTX-2 et LTX-2.3 ont apporté l'audio-vidéo synchronisé ouvert avec 4K natif. TRELLIS.2 de Microsoft (décembre 2025) est devenu le leader ouvert de l'image-vers-3D, et SAM 3D de Meta (novembre 2025) a rendu praticable la reconstruction 3D à partir d'une seule photo. FLUX.2 a succédé à FLUX.1 pour la génération d'images, et le SOMA-X de NVIDIA a apporté l'auto-rigging et le retargeting ouverts. La première moitié de 2026 a maintenu le rythme : Qwen3-TTS (janvier) a donné au clonage vocal un vrai foyer Apache 2.0, GLM-5 de Zhipu (février) a livré un modèle de code et agentique ouvert de 744B sous MIT, Matrix-Game 3.0 de Skywork (mars) a mis un modèle de monde interactif en temps réel en poids ouverts, DeepSeek-V4 (avril) a poussé les LLM ouverts à un contexte de 1M de jetons sous MIT, Stable Audio 3.0 (mai) a livré trois modèles audio ouverts entraînés sur des données sous licence, et Ideogram a publié son premier modèle image à poids ouverts (juin). Puis en juillet, Moonshot a annoncé Kimi K3, un modèle à poids ouverts de 2,8 T de paramètres, dont les poids sont arrivés le 27 juillet sous la Kimi K3 License, le même mois où Tencent est passé au 295B Hy3 en Apache 2.0 et quelques semaines après que Z.ai a livré GLM-5.2 sous MIT (17 juin). Août a aussi été chargé côté ouvert : Alibaba a publié Qwen3.8 (un modèle phare 2,4T-A95B plus un modèle dense 27B, Apache 2.0), Meta a publié Muse Glimmer 30B sous Apache 2.0, MiniMax a ouvert les poids vidéo H3 de 33B, et Lightricks a livré LTX-2.5. Plus tôt dans l'année, Gemma 4 de Google (avril, Apache 2.0) et Mistral Small 4 (mars, Apache 2.0) ont redéfini le palier embarqué.
La tendance à surveiller : les meilleurs laboratoires gardent de plus en plus leurs modèles les plus récents en API uniquement, même quand les versions précédentes étaient ouvertes. Wan est passé fermé à partir de la 2.5 et l'est resté jusqu'à la 3.0 (août 2026), Qwen-Image est passé fermé à partir de la 2.0, et Hunyuan3D à partir de la 2.5. Le successeur de Llama chez Meta, Muse Spark, a été lancé fermé en avril 2026 avant que le plus petit Muse Glimmer ne revienne ouvert en août, Black Forest Labs livre FLUX 3 d'abord via son API avec un FLUX 3 Dev ouvert promis pour plus tard en 2026, et Skywork a annoncé SkyReels V4 en février sans publier les poids. L'écosystème ouvert reste vibrant et évolue rapidement, mais « la dernière version est ouverte » n'est plus une supposition sûre, donc vérifiez la disponibilité des poids avant de construire un pipeline autour d'un modèle.
La trajectoire est claire : chaque capacité qui existe dans les modèles fermés apparaît dans les modèles ouverts 6 à 12 mois plus tard. La question n'est pas de savoir si les modèles ouverts seront assez bons. Ils le sont déjà pour la plupart des usages. La question est de savoir à quelle vitesse ils deviennent la norme par défaut.
Et voici ce que cela signifie pour les créateurs : les outils qui nécessitaient auparavant des budgets d'entreprise ou des abonnements mensuels deviennent quelque chose que vous pouvez simplement... faire tourner. Sur votre propre matériel. Sans la permission de personne d'autre.
C'est ça, le changement. C'est vers ça que nous construisons.
Questions fréquentes
Quel est le meilleur modèle d'IA open source pour générer des assets de jeu ?
Cela dépend de l'asset. Pour les modèles 3D, Hunyuan3D est l'option ouverte la plus forte en 2026. Pour l'art 2D et les textures, FLUX mène en qualité. Pour les effets sonores et la musique, les modèles audio ouverts ont rattrapé leur retard rapidement. Il n'y a pas de « meilleur » modèle unique parce que les jeux ont besoin de nombreux types d'assets, donc la plupart des créateurs en enchaînent quelques-uns plutôt que de dépendre d'un seul.
Les modèles d'IA open source sont-ils assez bons pour remplacer les API fermées ?
Pour la plupart des travaux d'assets de jeu en 2026, oui. Les modèles ouverts égalent désormais les API fermées sur la génération d'image, de 3D et d'audio, et vous pouvez les faire tourner sur votre propre matériel sans frais par appel ni changements de prix surprises. Les modèles fermés dominent encore sur quelques tâches de pointe comme la vidéo longue durée, mais l'écart se comble généralement en 6 à 12 mois.
Puis-je faire tourner ces modèles d'IA générative sur mon propre GPU ?
Beaucoup d'entre eux, oui. Les modèles d'image et d'audio tournent confortablement sur un seul GPU grand public comme une RTX 4090. Les modèles vidéo et 3D plus grands veulent plus de VRAM et souvent un GPU cloud de classe A100. La section matériel ci-dessus liste ce dont chaque modèle a besoin pour que vous puissiez planifier avant de vous engager.
Quel est le meilleur modèle frontière open source en 2026 ?
En septembre 2026, la frontière ouverte est une course à quatre, et la réponse dépend de ce que vous pouvez faire tourner. Kimi K3 (2,8T MoE) est le plus grand et se rapproche le plus des leaders fermés, mais sa Kimi K3 License ajoute des conditions pour les grandes entreprises de model-as-a-service. DeepSeek-V4-Pro (1,6T, 49B actifs) et Qwen3.8-2.4T-A95B ont les licences les plus propres à cette échelle, MIT et Apache 2.0 respectivement. GLM-5.2 (753B, MIT) est le spécialiste du code et des agents. Aucun d'eux ne tient sur un seul GPU, donc pour tout ce que vous hébergez vous-même, le vrai « meilleur » est un cran en dessous : Qwen3.6-35B-A3B, Gemma 4 31B, ou Muse Glimmer 30B.
Quels sont les meilleurs modèles de génération d'images frontières, ouverts et fermés ?
Ouverts : FLUX.2 [klein] 4B (Apache 2.0, sub-seconde) pour de l'art de jeu utilisable commercialement en toute sécurité, Qwen-Image-2512 (Apache 2.0) quand il faut du texte lisible, et FLUX.2 [dev] ou Chroma1-HD pour la qualité maximale si la licence convient. Fermés : FLUX.2 [pro] et le Qwen-Image-2.0 disponible uniquement via API, plus les arrivées 2026 comme Kling IMAGE 3.0 (jusqu'à 10 images de référence selon le guide de Kling) et Grok Imagine Image 2.0 de xAI. Le modèle image de FLUX 3 reste pour l'instant derrière l'API de BFL, avec une version Dev ouverte promise plus tard en 2026. Pour le travail de jeu vidéo, le palier ouvert est déjà largement suffisant, donc les modèles fermés achètent surtout de la commodité.
Quels modèles vidéo à poids ouverts autorisent un déploiement commercial complet, et sous quelle licence ?
Si vous avez besoin d'un modèle vidéo ouvert déployable commercialement à l'échelle de l'entreprise sans plafond de revenus, les choix sûrs sont Wan 2.2 (Apache 2.0, y compris les variantes MoE 5B et 14B), Mochi 1 (Apache 2.0), Step-Video-T2V (MIT), et CogVideoX 2B (Apache 2.0). LTX-2 et LTX-2.5 sont gratuits en usage commercial en dessous de 10 M$ de revenus annuels et nécessitent un accord payant au-delà, ce qui est la formule « achat d'accès » réellement proposée par Lightricks. MiniMax H3 est ouvert sous la MiniMax H3 Community License mais demande aux utilisateurs des États-Unis, de l'UE, du Royaume-Uni et de Corée du Sud de faire une demande préalable, et HunyuanVideo porte la licence communautaire de Tencent avec des exceptions régionales, donc lisez bien les deux avant de vous engager. Wan 2.5 à 3.0, Veo, Kling et Seedance n'ont aucun poids public. Notre guide des modèles vidéo de référence compare les options hébergées.
Quelle IA générative utiliser pour les assets et environnements de jeu en 2026 ?
Enchaînez plutôt quelques spécialistes que de chercher un modèle unique. Pour les objets et personnages, faites passer un concept FLUX.2 klein ou Qwen-Image par Hunyuan3D 2.1 ou TRELLIS.2, puis riggez avec UniRig. Pour les environnements, générez un skybox ou un HDRI (notre générateur de skybox le fait directement dans le navigateur), construisez le terrain de façon procédurale ou avec une passe de diffusion comme dans notre guide de génération de terrain, et texturez avec un modèle d'image plus un extracteur PBR comme expliqué dans notre guide des générateurs de textures IA. L'audio vient de Stable Audio 3.0 Small-SFX et ACE-Step, les voix de Qwen3-TTS ou Chatterbox. Chaque modèle de cette chaîne est ouvert et utilisable commercialement en septembre 2026.
Quel est le meilleur LLM à faire tourner localement en 2026 ?
Choisissez d'abord selon la VRAM. Sur 8 Go, Qwen3.5-4B ou Gemma 4 E4B. Sur 16 Go, gpt-oss-20b (Apache 2.0, conçu pour 16 Go) ou Gemma 4 12B. Sur 24 Go, Qwen3.6-35B-A3B est le polyvalent que la plupart des gens devraient utiliser, avec Muse Glimmer 30B en 4 bits pour le travail agentique avec vision, et Gemma 4 31B quantifié quand on veut le modèle dense le plus puissant. Au-delà, DeepSeek-V4-Flash (284B, 13B actifs) est le moyen le plus léger d'obtenir un contexte de 1M de tokens sur une station de travail. Tous ces modèles sont sous Apache 2.0 ou MIT, et Ollama ou LM Studio les fait tourner chacun avec une seule commande.
Est-il légal d'utiliser des assets générés par IA dans un jeu commercial ?
En général oui pour les modèles open source que vous faites tourner vous-même, mais cela dépend de la licence du modèle et des hypothèses sur les données d'entraînement. Vérifiez toujours la licence spécifique du modèle, et signalez le contenu généré par IA lorsque votre plateforme l'exige. Consultez notre politique sur le contenu généré par IA pour savoir comment nous gérons cela.
Pour aller plus loin
- Controverse IA, confiance et économie post-IA : notre position sur l'IA dans les jeux
- Politique sur le contenu généré par IA : comment nous gérons la divulgation de l'IA
- Meilleurs modèles vidéo IA avec support d'image de référence : comparatif des modèles vidéo hébergés
- Meilleurs générateurs de modèles 3D IA : Meshy, Tripo et Rodin hébergés face aux modèles ouverts
- Stack technique des jeux web en 2026 : WebGL, WebGPU et Wasm pour les jeux
- Technologies de monde ouvert 3D dans le navigateur : utiliser des assets 3D générés par IA dans des mondes navigateur
- Génération de paysages pour mondes ouverts en navigateur : synthèse de terrain par diffusion
- Où trouver des assets de jeu gratuits : sources d'assets traditionnelles en complément de la génération par IA
- Outils de code IA agentiques : l'IA pour écrire du code de jeu, pas seulement générer des assets
Les modèles de génération sont plus amusants quand le résultat est jouable.