最佳开源游戏生成式 AI 模型(2026)
最后更新:2026 年 9 月。
生成式 AI 一直有个问题。多年来,最好的模型都藏在 API 密钥和难以预测的定价背后。你围绕某个工具建立工作流、逐渐用顺手了,却可能一觉醒来就收到一封通知涨价的邮件。更糟的是,这家公司可能彻底转型了。
这种情况在 2024 年底发生了变化。腾讯、阿里巴巴和 DeepSeek 开始发布真正可以下载的模型。这些模型足以与闭源替代方案抗衡。创作者也由此突然有了不依赖他人商业模式的选择。
如果你能用自己掌控的模型生成视频、3D 资产、音乐和语音,会怎么样?如今我们已经走到了这一步。本指南将介绍哪些技术已经真正可用、哪些效果不错,以及你今天就能开始使用哪些模型。
视频生成
多年来,视频生成就意味着 Runway 或 Pika:闭源平台、订阅费用,以及对输出内容用途的种种限制。现在呢?你可以在自己的硬件上运行效果相近的模型。
HunyuanVideo 文生视频示例,由领先的开源视频模型输出 720p 视频
| 模型 | 机构 | 参数量 | 规格 | 硬件 | 成本 |
|---|---|---|---|---|---|
| HunyuanVideo | 腾讯 | 13B | 720p,文本+图像 | 80GB | ~$0.20 |
| HunyuanVideo-1.5 | 腾讯 | 8.3B | 480p-1080p,文本+图像 | 14GB | ~$0.05 |
| Mochi 1 | Genmo | 10B | 480p@30fps | 12GB+ | ~$0.10 |
| LTX-Video | Lightricks | — | 768x512,实时 | 12GB | ~$0.02 |
| LTX-2 / LTX-2.5 | Lightricks | 19B (2) / 22B (2.5) | 4K、同步音频,2.5 支持多镜头 | 高端硬件 | ~$0.30 |
| Wan 2.1 | 阿里巴巴 | 1.3-14B | 480p-720p | 8GB+ | ~$0.03 |
| Wan 2.2 | 阿里巴巴 | 27B MoE(激活 14B) | 720p,MoE | 8GB+ | ~$0.03 |
| CogVideoX1.5-5B | 清华大学 | 5B | 1360x768@16fps,最长 10 秒 | 12GB | ~$0.04 |
| SkyReels-V3 | Skywork | 14-19B | 音频驱动、参考图生视频、视频转视频 | 高端硬件 | ~$0.10 |
| MiniMax H3 | MiniMax | 33B | 2K、4-15 秒、立体声音频,最多 9 张参考图 | 高端硬件 | 尚未评测 |
| Step-Video-T2V | StepFun | 30B | 最大的开源文生视频模型,204 帧 | 高端硬件 | ~$0.15 |
| Open-Sora 2.0 | HPC-AI | 11B | 集成 Flux | 高端硬件 | ~$0.20 |
权重:HunyuanVideo ↗ · Mochi 1 ↗ · Wan 2.1 ↗ · Open-Sora ↗
查看示例: HunyuanVideo 图库 ↗ · Mochi 示例 ↗ · CogVideoX 示例 ↗
这对创作者意味着什么
HunyuanVideo 在专业评测中的表现优于 Runway Gen-3,而且完全开源。但问题是什么?你需要性能强劲的硬件,也就是拥有 80GB 显存的 A100 或 H100。对我们大多数人来说,这意味着需要时再租用云 GPU。
HunyuanVideo-1.5 改变了硬件成本的计算方式。腾讯于 2025 年 11 月发布了这款拥有 8.3B 参数的开源模型,它可以在 14GB 显存的消费级 GPU 上运行,支持 480p/720p 文生视频和图生视频,还可选择上采样至 1080p。全新的选择性滑动分块注意力(Selective and Sliding Tile Attention,SSTA)机制,使其推理速度大约达到初代 HunyuanVideo 的两倍。如果你想获得 HunyuanVideo 的画质,却无法接受购买 80GB 显存显卡的成本,这就是你真正能在家运行的版本。
Mochi 1 才是你真正能轻松运行的模型。12GB 显存即可,也就是 RTX 3060 这一级别的硬件。它的输出确实富有创意,并具有鲜明的艺术质感。保真度虽然还比不上 HunyuanVideo,但整个流程完全掌握在你自己手中。
LTX-2 对游戏开发而言就很有意思了。它是首个能够同时生成同步音频和视频的开源模型。想象一下,过场动画的声音就这样……自动对上了。无需后期同步。Lightricks 于 2026 年 1 月开源了完整权重、推理代码和训练代码,原生支持最高 50fps 的 4K 输出,以及最长 20 秒的同步音频。这里有一个许可限制需要注意:LTX-2 的开放权重可免费用于学术用途,但只有年营收低于 $10M 的公司才能免费用于商业用途,因此在基于它开展业务之前,请先确认是否低于这一门槛。截至 2026 年 9 月,最新检查点为 LTX-2.5。这是一个 22B 模型,新增了原生多镜头生成能力(使用同一角色和视觉风格生成数个连贯镜头),以扩散视频解码器取代普通 VAE 重建,并采用 Gemma 4 12B 文本编码器来处理更长的提示词。它仍采用 LTX-2.x Community License,维持相同的 $10M 营收界线,超过该门槛则需要签订付费协议。
SkyReels-V3(Skywork,2026 年 1 月)是值得关注的较新开源系列。它是一款统一的多模态模型,提供 14B 和 19B 两种版本,支持音频驱动视频、参考图生视频和视频转视频,因此尤其适合使用角色或参考图来引导镜头生成。Step-Video-T2V(StepFun)则是最大的开源文生视频模型,参数量达到 30B,并采用简洁宽松的 MIT 许可证。如果对你而言,宽松许可比在小型 GPU 上运行更重要,就值得了解它。
MiniMax H3(Hailuo 3.0)是最新加入的开源模型,也是制作参考素材驱动型过场动画时最值得关注的选择。MiniMax 于 2026 年 7 月 31 日先以 API 形式推出该模型,并于 8 月在 Hugging Face 上发布 33B 基础权重,其中包含两个检查点:用于首尾帧生成的 FL2VA,以及 Ref2VA。后者最多可接收 9 张参考图、3 段参考视频和 3 段音频(共 12 个文件),并生成 4 至 15 秒、最高 2K 分辨率且带原生立体声音频的视频。该模型采用 MiniMax H3 Community License,模型卡还要求美国、欧盟、英国和韩国的用户先提交申请表,因此它并非适合所有工作室的即用型方案。
Wan 2.1 可以在游戏本上运行。较小的变体只需要 8GB 显存。如果你一直想用视频生成技术制作原型,却无法接受硬件投入,这是很合适的入门路径。
Wan 2.2(阿里巴巴,2025 年 7 月)是首款采用混合专家架构的开源视频模型:总参数量为 27B,但每一步仅激活 14B。它提供文生视频(T2V-A14B)、图生视频(I2V-A14B),以及可在消费级 GPU 上运行的混合型 5B 变体。所有版本均采用允许商业使用的 Apache 2.0 许可证。
有一点需要注意:Wan 2.2 仍然是最后一个开源的 Wan 版本。更新的 Wan 2.5(2025 年 9 月)、2.6(2025 年 12 月)、2.7(2026 年 4 月),以及如今的 Wan 3.0(2026 年 8 月,根据 Alibaba Cloud Model Studio 的信息,可生成最长 30 秒、最高 1080p 的单镜头视频,并支持参考素材输入)加入了同步音频、1080p 和更精细的帧控制,但仅提供 API,没有公开权重。截至 2026 年 9 月,无论推广返佣网站声称什么,Wan-AI Hugging Face 组织页上的最高版本仍是 2.2。如果你看重自托管,2.2 就是上限。需要 4K 和同步音频时,应选择开放模型 LTX-2.5。
合理的工作流是:本地制作原型时使用 Mochi 1 或 Wan 2.1;需要最终成品质量时,则在云 GPU 上运行 HunyuanVideo-1.5 或 LTX-2.5。
图像生成
开源模型在这个领域已经赢了。你现在可以下载的模型确实足以与 Midjourney 竞争。不是“差不多一样好”,而是真正具有竞争力。
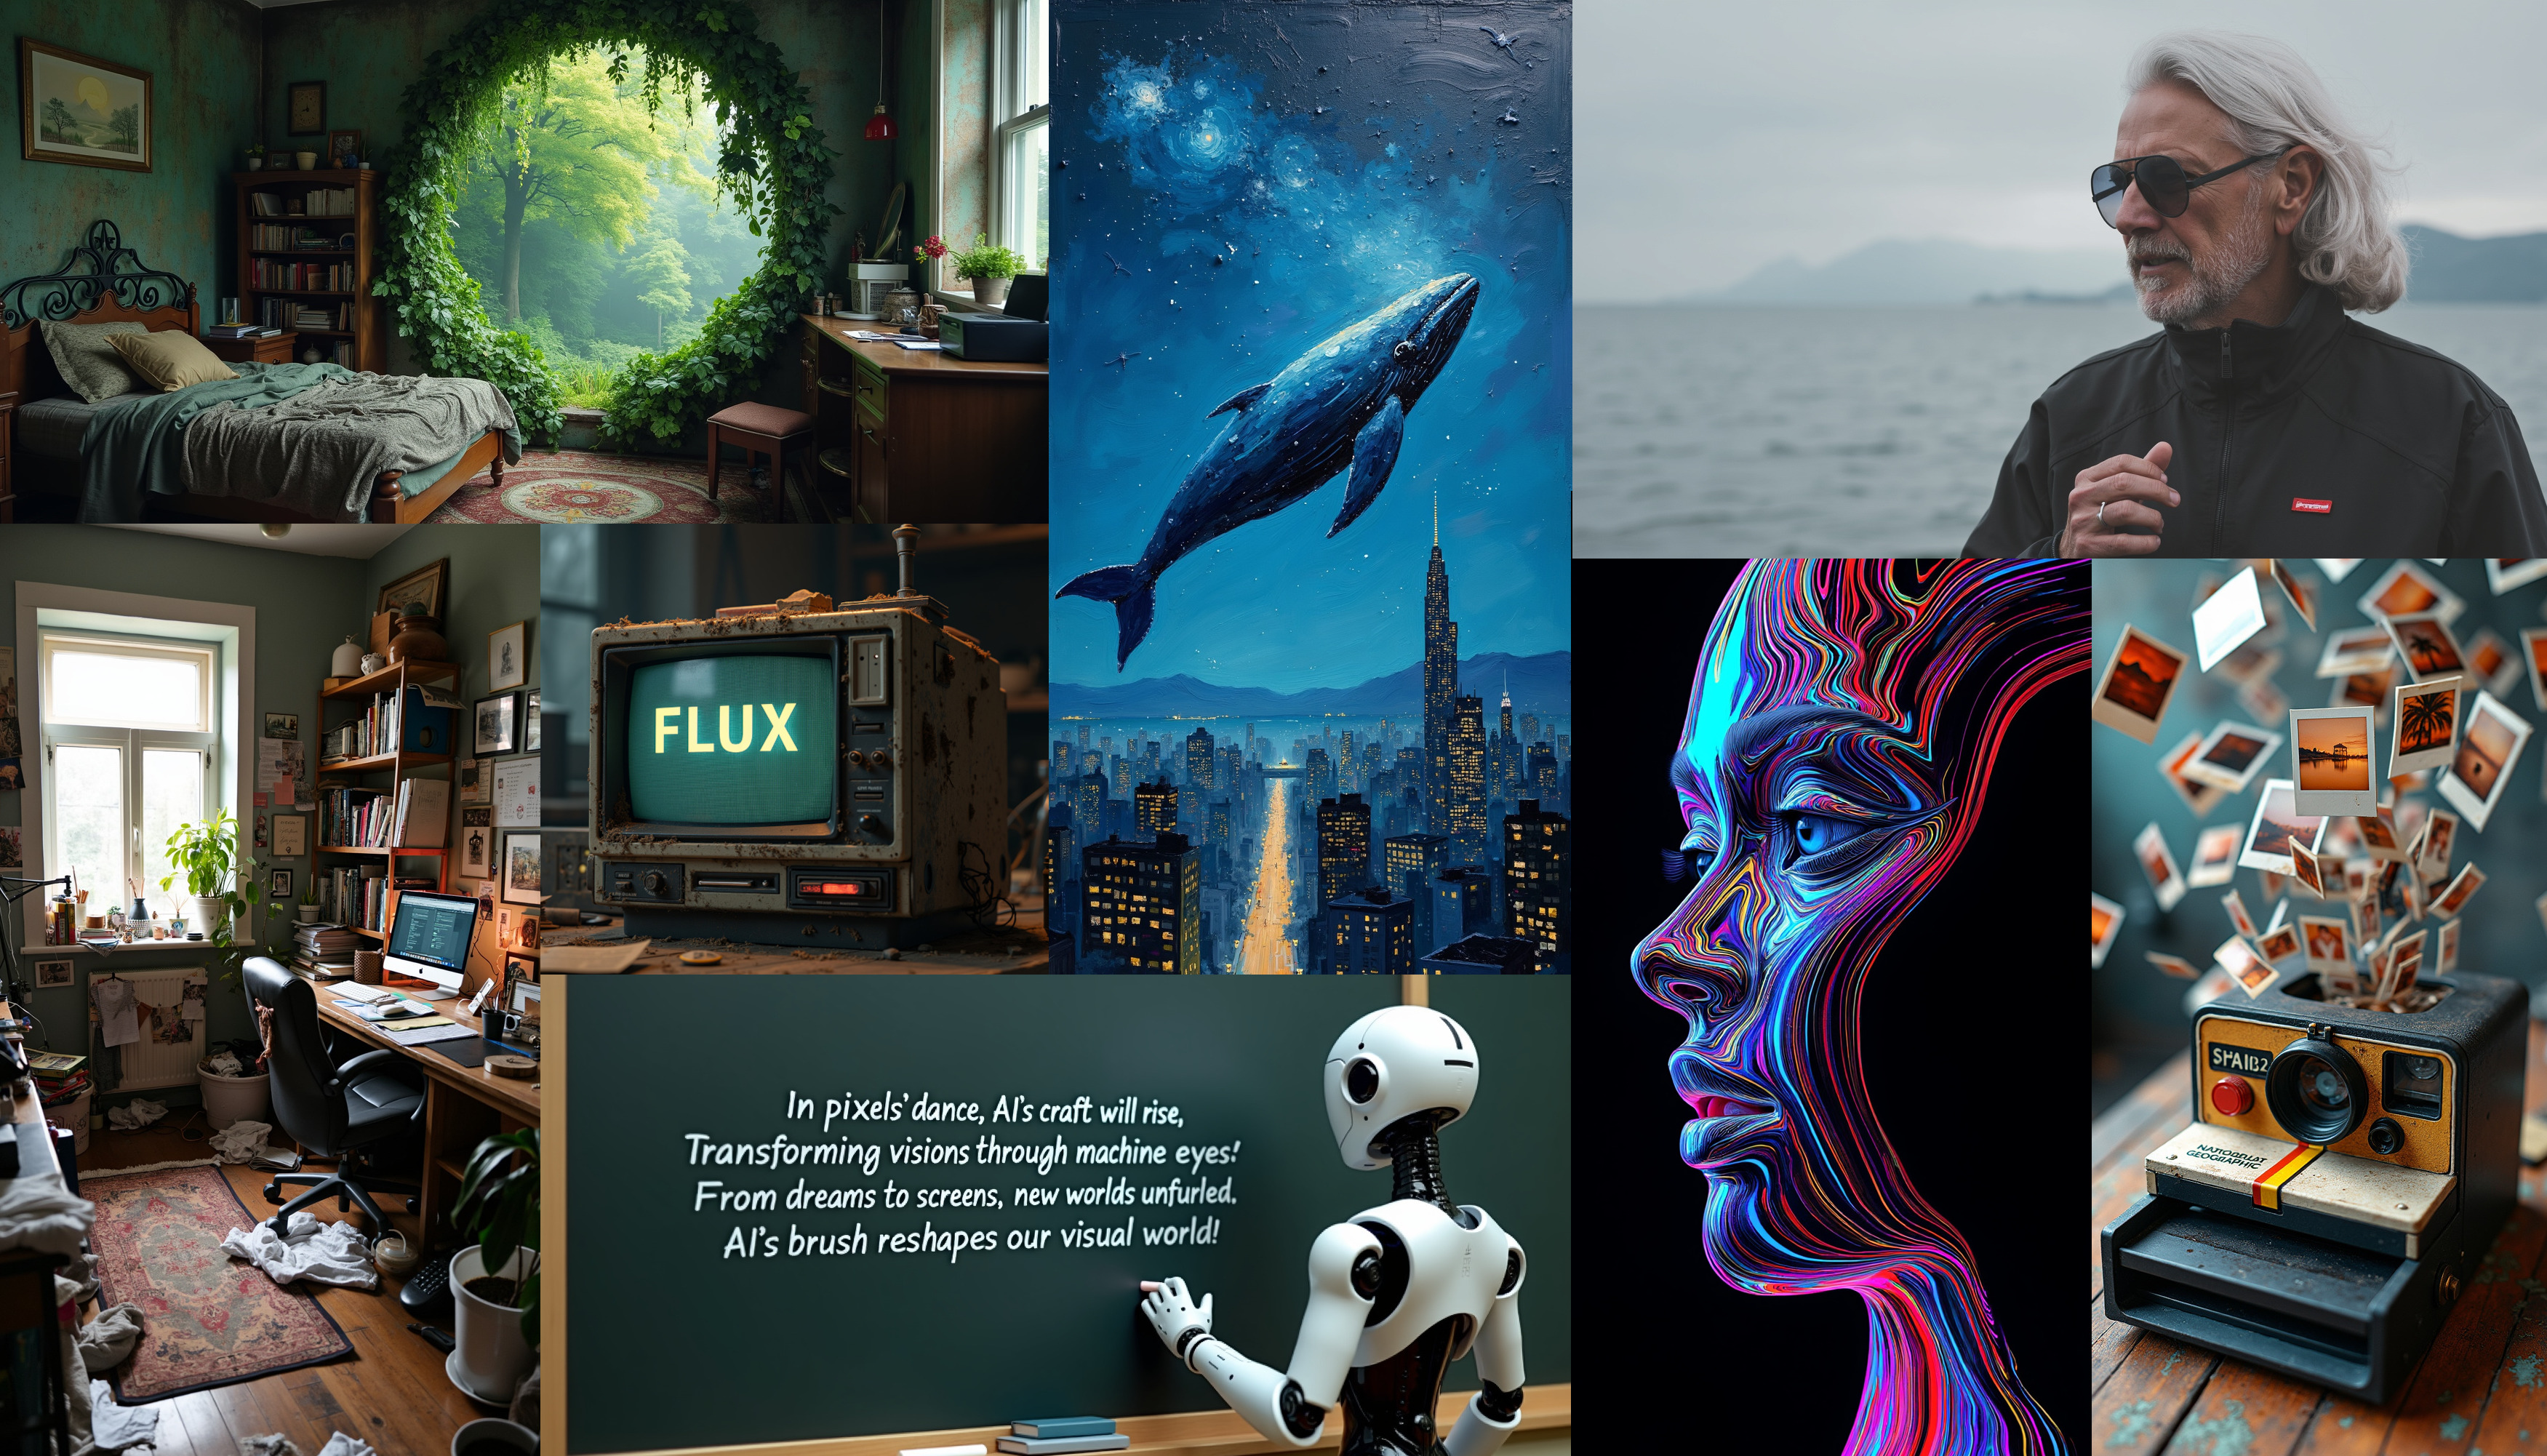 FLUX.1 示例:采用 Apache 2.0 许可模型生成的照片级写实画质
| 模型 | 机构 | 发布时间 | 参数量 | 主要特点 | 许可证 | 单张图像成本 |
|---|---|---|---|---|---|---|
| FLUX.1 [schnell] | Black Forest Labs | 2024 年 8 月 | 12B | 4 步生成,速度快 | Apache 2.0 | ~$0.001 |
| FLUX.1 [dev] | Black Forest Labs | 2024 年 8 月 | 12B | 质量接近 Pro | 非商业用途 | ~$0.002 |
| SD 3.5 Large | Stability AI | 2024 年 10 月 | 8B | 文字渲染,风格多样 | Stability 许可证 | ~$0.002 |
| SD 3.5 Large Turbo | Stability AI | 2024 年 10 月 | 8B | 4 步生成,速度快 | Stability 许可证 | ~$0.001 |
| HiDream-I1 | HiDream.ai | 2025 年 4 月 | 17B | 高质量,提供 Full/Dev/Fast 变体 | MIT | ~$0.002 |
| CogView4 | 清华大学 / 智谱 | 2025 年 3 月 | 6B | 原生中文文本,最高 2048px | Apache 2.0 | ~$0.002 |
| Qwen-Image | 阿里巴巴 | 2025 年 8 月 | 20B | 顶尖文字渲染与编辑能力 | Apache 2.0 | ~$0.002 |
| FLUX.2 | Black Forest Labs | 2025 年 11 月 | 32B | 文生图+编辑、4MP、多参考素材 | dev:非商业用途 / klein 4B:Apache 2.0 | ~$0.003 |
| Ideogram 4.0 | Ideogram | 2026 年 6 月 | 9.3B | 设计工作、文字渲染、JSON 布局控制 | 非商业用途 | ~$0.002 |
直接试用:FLUX.1 schnell 演示 ↗ · SD 3.5 Large 演示 ↗ · GitHub(FLUX)↗
查看示例: FLUX 图库 ↗ · FLUX LoRA 图库 ↗ · Replicate 示例 ↗
用于制作游戏资产
FLUX.1 [schnell] 是你最需要了解的模型。它采用 Apache 2.0 许可证,意味着你可以发布商业游戏,不必担心许可证方面的麻烦。它只需 4 步即可完成生成,因此可以快速迭代。描述你想要的内容、查看结果、调整,然后重复。
SD 3.5 Large 终于可以正确处理文字渲染了。之前的版本会把你想放入图像的任何文字都变成乱码。这对于 UI 原型、游戏内标牌、标题画面,以及任何需要图像中出现可读文字的场景都非常重要。
FLUX.2(Black Forest Labs,2025 年 11 月)是规模更大的后继版本:这款 32B 模型使用同一检查点处理文生图和图像编辑,在多参考素材下具有出色的角色与风格一致性,并可在最高 4 百万像素下可靠地渲染文字。采用开放权重的 FLUX.2 [dev] 使用非商业许可证,但经过规模蒸馏的 FLUX.2 [klein](2026 年 1 月)为其 4B 版本采用了 Apache 2.0 许可证,生成时间不到一秒,并且只需约 8GB 显存即可运行,因此发布游戏美术时仍有一个可安全商用的选择。请务必获取 4B klein:更大的 klein 9B 仍采用非商业用途的 FLUX 许可证。量化流水线可将 [dev] 的硬件要求降低至 18-24GB 显存。Black Forest Labs 的下一代产品 FLUX 3 是一款联合处理图像、视频和音频的模型,于 2026 年 7 月 23 日发布公告。截至 2026 年 9 月,它仍仅提供 API:带同步音频的视频功能已于 8 月 4 日上线预览,而根据 BFL 发布说明,开放权重的 FLUX 3 Dev“计划于 2026 年晚些时候推出”。在它正式发布之前,klein 4B 仍是可安全商用的 FLUX 版本。
还有两个值得了解的开源选择。Chroma1-HD(8.9B,Apache 2.0)是完全开放的 FLUX.1-schnell 衍生模型,因此无需受 [dev] 许可证限制,就能以可安全商用的方式获得 FLUX 系列的画质。OmniGen2(Apache 2.0)是一款统一模型,可在同一个模型中完成文生图和基于指令的编辑。当你要迭代现有资产(“让这把剑发出蓝光”),而不是从零开始生成时,它是最快的方案。
Qwen-Image(阿里巴巴,2025 年 8 月)是美术资产需要清晰可读文字时应优先选择的开源模型,例如标牌、UI、海报或物品标签。它是一款采用 Apache 2.0 许可证的 20B 模型,拥有顶尖的文字渲染能力和强大的指令式编辑变体,既可安全商用,又特别擅长处理大多数图像模型依然容易出错的任务。2025 年 12 月更新的 Qwen-Image-2512 改进了人物写实度和文字排版,并继续采用 Apache 2.0 许可证,因此如果你要自托管,请使用这个检查点。更新的 Qwen-Image-2.0(2026 年 2 月)仅提供 API;截至 2026 年 9 月,QwenLM 仓库仍将 Qwen-Image-2512 和 Qwen-Image-Edit-2511 列为拥有公开权重的最新检查点。 Ideogram 4.0(2026 年 6 月)是 Ideogram 首个开放权重版本:一个专为设计工作打造的 93 亿参数扩散 Transformer,具备出色的多语言文本渲染能力,并可通过结构化 JSON 提示词明确控制布局和颜色。不过,在基于它开发之前需要注意:推理代码采用 Apache 2.0 许可证,但权重使用非商业许可证,因此除非购买商业许可证,否则它只能用于研究和原型制作。
Stable Diffusion 周边生态依然无可匹敌。ControlNet 可精确控制构图,局部重绘可用于修复,LoRA 微调可创建自定义风格。FLUX 正在迎头赶上,但如果你现在需要深度定制,SD 成熟的工具生态能提供更多发挥空间。
我的建议是:制作纹理和精灵图,两者都可以。创作有特定风格要求的概念美术,选择搭配 LoRA 的 SD 3.5。追求可用于商业发行的纯粹质量,选择 FLUX schnell。
3D 生成
如果你曾花八小时制作一个在游戏里只出现三秒的道具模型,那么本节就是为你准备的。3D 生成早已从“有趣的研究”跨入真正的生产工具领域,到 2026 年,开放模型的表现已经相当出色。你可以在一分钟内将一张草图变成带纹理的网格。
本页介绍可自行托管的开放模型。如果你是在选择工具而非模型,我们的最佳 AI 3D 模型生成器指南将托管式选项(Meshy、Tripo、Rodin、Hi3D)与开放模型进行了比较,并列出了各自的价格和商业使用权。
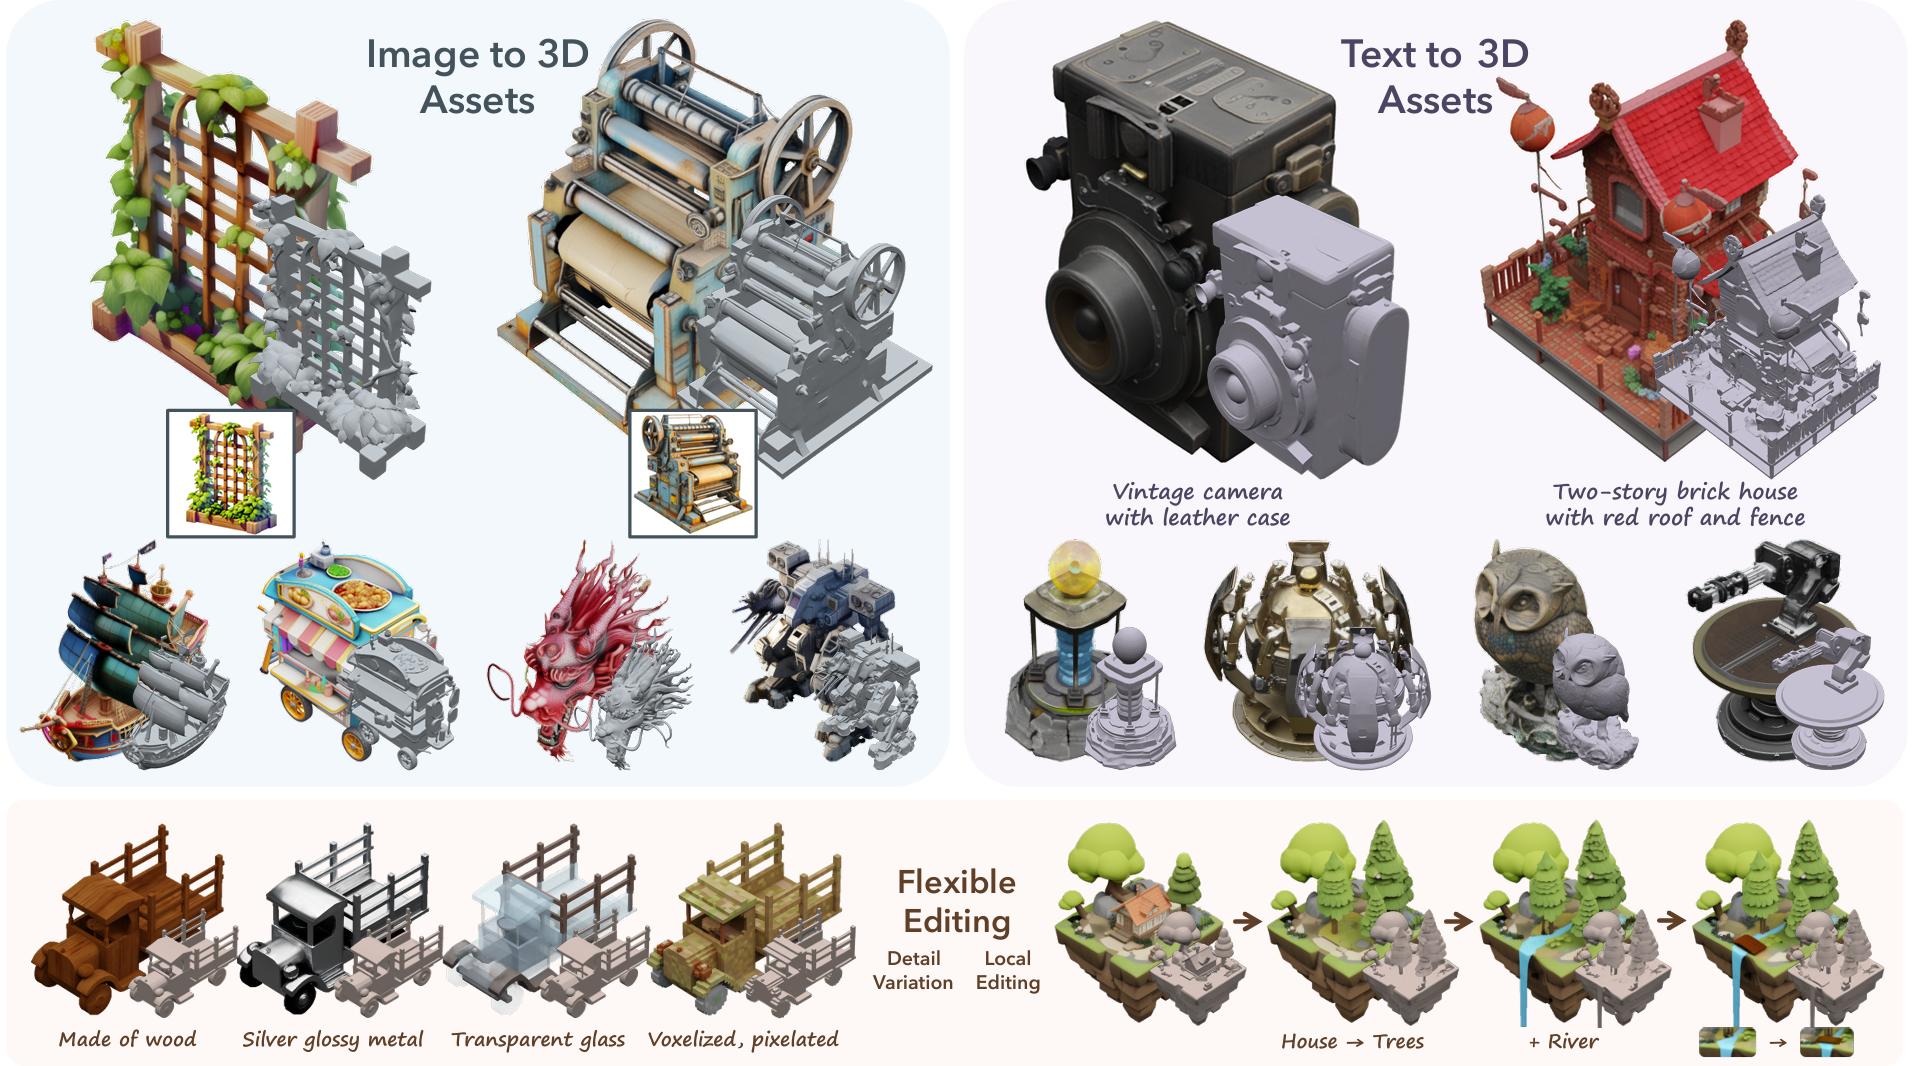 TRELLIS 可根据单张图像生成带有 PBR 材质的纹理化 3D 网格
| 模型 | 机构 | 发布时间 | 核心特性 | 输出 | 每个网格的成本 |
|---|---|---|---|---|---|
| TRELLIS.2-4B | Microsoft | 2025 年 12 月 | 40 亿参数、原生 PBR、最高 1536³ | 带法线的纹理化网格 | 约 $0.03 |
| Hunyuan3D 2.1 | Tencent | 2025 年 6 月 | 生产级 PBR、完整权重和训练代码 | 高保真纹理化网格 | 约 $0.05 |
| SAM 3D | Meta | 2025 年 11 月 | 单图生成 3D(物体和人体) | 从单张照片生成网格 | 约 $0.02 |
| Stable Fast 3D | Stability AI | 2024 年 8 月 | 约 0.5 秒内将单张图像转换为网格 | 快速纹理化网格 | 约 $0.001 |
| TripoSG | VAST-AI | 2025 年 3 月 | 15 亿参数的整流流形状生成 | 高质量网格 | 约 $0.01 |
| TripoSR | Stability / Tripo | 2024 | 快速单图重建 | 网格(无纹理) | 约 $0.001 |
| UniRig | Tsinghua / Tripo | 2025 | 自动绑定:骨骼和蒙皮权重 | 已绑定、可动画化的网格 | 约 $0.01 |
直接试用:TRELLIS.2 演示 ↗ · Hunyuan3D 演示 ↗ · InstantMesh 演示 ↗
查看示例:TRELLIS.2 项目页面 ↗ · 3D AI Studio 作品库 ↗
真正有效的工作流
目前最受创作者认可的方法,是将多个模型串联起来使用。先从一张图像开始,无论是生成的还是拍摄的都可以。通过 Stable Zero123 或 Wonder3D 生成多个视角,再将这些视图输入 InstantMesh 或 TripoSR 生成网格,最后用 TRELLIS.2 或 Hunyuan3D 制作合格的材质。
Microsoft 的 TRELLIS.2 是目前制作生产就绪资产的新标杆。它能够处理其他模型容易失败的几何结构:薄面、孔洞和复杂拓扑。其 40 亿参数版本输出的是带有真正 PBR 纹理的网格,而不是用顶点颜色假装成材质。
Stable Fast 3D 的核心优势是速度。从图像生成网格大约只需半秒。网格仍需清理和添加纹理,但如果是制作原型呢?如果你想在投入数小时之前先确认一个想法是否可行呢?它无可匹敌。如果希望从单张图像获得更干净的几何结构,TripoSG 则是更进一步的选择。
Hunyuan3D 2.1 是值得使用的腾讯开放模型:它提供完整权重和训练代码,并具备生产级 PBR 纹理能力。需要注意其命名,因为这很容易让人困惑。Hunyuan3D 2.5、3.0 和 3.1 虽然都已存在,但仅提供 API,没有公开权重。因此,在自行托管场景中,基础生成器的最高版本仍然是 2.1(截至 2026 年 9 月,向腾讯询问是否会开放 2.5 源代码的一个 GitHub 讨论串仍未得到回复)。如果你更想直接试用而不是自行托管,我们的 3D 生成器可直接在浏览器中运行 Hunyuan3D。腾讯确实开放了两个基于 2.1 构建的实用扩展:Hunyuan3D-Omni 增加了多条件控制(点云、体素、骨骼、边界框),Hunyuan3D-Part 则可将网格拆分为可编辑部件。其许可证还排除了欧盟、英国和韩国,因此在这些地区发行前请先核对条款。
SAM 3D(Meta,2025 年 11 月)是最新的入门方式:只需一张照片即可生成 3D 网格,并分别提供适用于物体和人体的模型。结合 Meta 的分割技术,你可以隔离图像中的某个物体,并只重建该物体。
UniRig(清华和 Tripo,MIT 许可证)填补了所有人在获得网格后立即遇到的缺口:骨骼绑定。它会为输入网格自动生成有效骨架和蒙皮权重,让生成的角色真正能够制作动画,而不是只能作为静态道具摆在那里。将它与 NVIDIA SOMA-X 的自动动画技术结合后,一个完全生成且完整绑定的角色就不再只是研究演示。
对于独立创作者,比较现实的流程是:用 FLUX 生成概念美术,通过 InstantMesh 创建几何体,然后在 Blender 中绘制纹理,或用 TRELLIS 自动生成 PBR 材质。每项资产的制作时间可从 4–8 小时降至 30–60 分钟。虽然并非完全不耗时间,但差异非常显著。
音频和音乐
音频生成尚未追上图像和视频,但现有技术已足以改变你的工作方式,尤其是在原型制作和音效方面。
AI 生成的音乐示例。描述你想要的氛围,即可获得与之契合的音乐
| 模型 | 机构 | 发布时间 | 功能 | 许可证 | 每 30 秒成本 |
|---|---|---|---|---|---|
| ACE-Step 1.5 | StepFun/ACE Studio | 2026 年 1 月 | 快速生成约 4 分钟音乐、支持 19 种语言和声音克隆 | MIT | 约 $0.02 |
| Stable Audio 3.0 | Stability AI | 2026 年 5 月 | 生成最长约 6 分钟的歌曲;开放 Small、Small-SFX 和 Medium 模型 | Stability Community | 约 $0.02 |
| YuE | MAP | 2025 年 1 月 | 根据歌词生成完整歌曲,包含人声和伴奏 | Apache 2.0 | 约 $0.05 |
| MusicGen | Meta | 2023 | 文本生成音乐、可控制 | 代码 MIT / 权重 CC-BY-NC | 约 $0.01 |
| DiffRhythm 2 | ASLP-lab | 2026 年 2 月 | 快速生成完整歌曲 | Apache 2.0 | 约 $0.02 |
| Magenta RealTime | 2025 年 6 月 | 可通过提示词实时引导的音乐 | 代码 Apache / 权重 CC-BY | 约 $0.02 |
直接试用:MusicGen 演示 ↗ · AudioCraft 体验场 ↗
查看示例:MusicGen 示例 ↗ · AudioGen 示例 ↗
真正能用于发行的选择
Meta 的 MusicGen 依然是制作游戏音频原型的实用选择。描述你想要的氛围,即可获得与之契合的音乐,而且它在 12GB 显存的 GPU 上也能顺畅运行。但许可证有一个陷阱:MusicGen 的代码采用 MIT 许可证,模型权重却采用 CC-BY-NC(非商业)许可证。因此,可以用它制作原型,但任何要正式发行的内容都应改用 ACE-Step 或 Stable Audio 等获得商业许可的模型。
**Stable Audio 的开放音效模型(Small-SFX)**可以处理脚步声、门轴吱呀声、环境风声和机械声,能够本地运行,并采用 Stability 的社区许可证。因此,当你需要真正可以商业使用的声音时,它是开放音效模型中的首选。之所以选择它,是因为其他开放音效模型都附带限制:Meta 的 AudioGen 采用 CC-BY-NC,TangoFlux 则采用 Stability 的非商业社区许可证,因此对于正式发行的游戏,两者都只能用于原型制作。
Magenta RealTime(Google)以一种非常出色的方式成为异类:它是唯一专为实时、持续通过提示词引导的音乐而设计的开放权重模型。它不是渲染一条完成的音轨,而是在播放过程中实时生成音乐,并允许你持续调整方向。这恰好符合自适应游戏配乐的需求——音乐会根据玩家正在进行的操作而变化。其代码采用 Apache 2.0,权重采用 CC-BY,两者都允许商业使用。
YuE 确实令人兴奋。它是首个能生成带人声完整歌曲的开放模型。主题曲、带真实歌声的背景音乐,它都能制作。虽然质量并不稳定,但远远领先于其他任何可以下载并自行运行的模型。
ACE-Step 是目前值得了解的开放音乐模型,而且进展极快:1.5 系列(2026 年 1 月发布,并提供更大的 5B XL 变体)取代了 2025 年 5 月发布的初始版本,目前采用 MIT 许可证。它可以快速生成数分钟的音乐,支持 19 种语言,并具备声音克隆、混音和歌词编辑功能。对于游戏原型制作,它弥补了 YuE 和 MusicGen 留下的许多空白。
Stable Audio 3.0(2026 年 5 月)是音频领域更重大的更新。它可以生成最长约六分钟的歌曲,而且 Stability 为四个变体中的三个开放了权重:Small 和专用音效模型 Small-SFX 均可在设备端运行,Medium 则提供更好的音乐结构和完整音轨时长。只有 Large 模型仍仅通过 API 提供。Small-SFX 目前是专门制作游戏音效的最强开放选择。这三个开放模型均采用 Stability AI Community License,允许你使用并出售它们生成的内容;根据 Stability 的公告,年收入超过 $1M 的公司则需要企业许可证。整个模型家族均使用获得授权的数据进行训练,因此相比那些仍面临未决诉讼的音乐生成器,其法律基础更加清晰。
坦率地说:开放模型与闭源模型(Suno、Udio)之间的差距正在缩小,但在完整人声歌曲方面依然真实存在,而且这些闭源工具同样面临尚未解决的训练数据诉讼。对于音效,开放模型——尤其是 Stable Audio 的 SFX 模型——确实具有竞争力。如果你要发行包含生成歌曲的作品,应做好大量迭代的准备,或者请音乐人完成最终制作,将这些工具用于其他环节。
语音与人声
语音生成现在早已超越了“足够用于游戏”的水平,这也改变了小型团队能够实现的内容。
AI 生成的游戏旁白,语音自然、节奏恰当且富有情感
| 模型 | 机构 | 发布时间 | 核心特性 | 许可证 | 每分钟成本 |
|---|---|---|---|---|---|
| Qwen3-TTS | Alibaba | 2026 年 1 月 | 3 秒声音克隆、声音设计、10 种语言 | Apache 2.0 | 约 $0.002 |
| Chatterbox | Resemble AI | 2025 | 情绪控制、通过约 5 秒音频克隆、23 种语言 | MIT | 约 $0.003 |
| CSM | Sesame AI | 2025 年 3 月 | 对话流畅、停顿自然 | Apache 2.0 | 约 $0.005 |
| Fish Speech 1.5 | Fish Audio | 2024 | 通过 10–30 秒音频进行零样本克隆 | 代码 Apache / 权重 CC-BY-NC-SA | 约 $0.002 |
| OpenVoice V2 | MyShell/MIT | 2024 年 4 月 | 情绪和口音控制 | MIT | 约 $0.003 |
| XTTS-v2 | Coqui(社区) | 2024 | 17 种语言、声音克隆 | CPML(非商业) | 约 $0.005 |
试听示例:Fish Audio 声音 ↗ · OpenVoice 演示 ↗
让 NPC 听起来像真人
Sesame 的 **CSM(Conversational Speech Model)**专为对话打造。它能生成自然的停顿、语调变化,以及真实交谈的节奏。大多数 TTS 听起来都像有人在照本宣科,而且你一听就能察觉。CSM 则像有人真的在说话。这种差异比想象中更重要。
Qwen3-TTS(Alibaba,2026 年 1 月)是商业项目的首选。整个模型家族均采用 Apache 2.0 许可证,只需约 3 秒参考音频即可克隆声音,支持 10 种语言,还支持基于描述的声音设计。因此,你可以直接用自然语言指定 NPC 的声音,而不必四处寻找参考录音。0.6B 和 1.7B 模型可在配置适中的硬件上运行。 Chatterbox(Resemble AI)是注重声音表现力时的首选,而且采用 MIT 许可证,可以直接用于发布。它只需约 5 秒音频即可克隆声音,延迟低于 200 毫秒,支持 23 种语言,还是首个提供情绪夸张程度控制的开放模型,因此 NPC 听起来真的可以愤怒或恐惧,而不是毫无感情。另外两个采用 Apache-2.0 许可证的选项则适合特定需求:Orpheus(Canopy)支持 <laugh> 和 <sigh> 等内联情绪标签,能够自然映射到 NPC 的短促语音,并提供适合低端硬件的 150M 版本;Dia(Nari Labs)专为多说话者对话而设计,可在单次生成中加入咳嗽、笑声等非语言声音。Mistral 的 Voxtral TTS(2026 年 3 月)是面向语音智能体的较新开放权重模型,详情见 Mistral 新闻页面,但在发布前请仔细阅读其许可证。
Fish Speech 和 OpenVoice 可用于声音克隆。录制配音演员 10~30 秒的声音,之后就能用该声音生成无限量对白。想想这意味着什么:你可以聘请配音人才录制关键台词,再扩展其表演,覆盖数百种变化和环境对白。关于 Fish Speech 的许可证需要注意:代码是开放的,但 1.5 版权重采用 CC-BY-NC-SA,因此它只适合作为原型开发工具。对于正式发布的游戏,请改用 OpenVoice(MIT)或 Qwen3-TTS(Apache 2.0)。
NVIDIA ACE(并非完全开放,但值得了解)现在支持使用 Qwen3-8B 在设备端部署 NPC。本地 LLM、本地 TTS 加口型同步,全部运行在消费级 GPU 上。对于不需要调用云端服务的实时 NPC 对话,这就是合适的技术栈。
对独立创作者而言,合理的做法是:为主要角色和最重要的台词聘请配音演员,再使用 Qwen3-TTS 或 OpenVoice 扩展环境对白、台词变化和其他零散台词的覆盖范围;否则这些内容要么只能保持沉默,要么成本高得令人望而却步。
世界模型与游戏模拟
这正是事情开始变得既真正奇异、又真正令人兴奋的地方。这些模型生成的不是静态素材,而是宛如游戏的体验。
🎮 体验 Oasis:AI 生成的 Minecraft无需游戏引擎,仅靠 AI 预测实时生成世界
| 模型 | 组织 | 发布时间 | 功能 | 状态 | 每帧成本 |
|---|---|---|---|---|---|
| DIAMOND | 研究项目 | 2024 | 扩散世界模型、Atari 模拟 | 开放权重 | ~$0.001 |
| Oasis | Decart/Etched | 2024 年 10 月 | 实时生成 Minecraft 世界 | 开放 500M 权重 | ~$0.002 |
| MineWorld | Microsoft | 2025 年 4 月 | 实时 Minecraft,Oasis 的开放替代方案 | MIT | ~$0.002 |
| Hunyuan-GameCraft | Tencent | 2025 年 8 月 | 交互式游戏视频、键盘与鼠标控制 | Tencent Community | ~$0.005 |
| GameGen-X | 研究项目 | 2024 | 开放世界视频生成 | 开放代码与数据集 | ~$0.005 |
| NVIDIA Cosmos | NVIDIA | 2025 年 10 月 | 物理 AI 模拟(Predict2.5) | NVIDIA Open Model License | ~$0.01 |
| Matrix-Game 3.0 | Skywork | 2026 年 3 月 | 实时 720p 交互式世界、长时记忆 | 开放权重 | ~$0.005 |
| Genie 2 | DeepMind | 2024 年 12 月 | 根据图像生成交互式 3D 世界 | 未发布 | 不适用 |
| Genie 3 | DeepMind | 2025 年 8 月 | 实时 720p 世界、可通过提示词触发事件 | 闭源(Project Genie) | 不适用 |
查看研究资料:DIAMOND 项目页面 ↗ · Cosmos 博客 ↗
亲自试用:Oasis 在线演示 ↗ · Genie 2 示例 ↗
为什么你应该关注这些模型
DIAMOND 证明了一件足以改变你对游戏 AI 看法的事:你可以完全在生成的世界中训练智能体,训练过程根本不需要真实的游戏引擎。AI 在扩散模型的想象中游玩,然后把学到的能力迁移到真实游戏中。这背后的意义十分重大。
Oasis 能够实时运行类似 Minecraft 的世界,一帧接一帧地生成。没有游戏引擎,没有纹理,也没有预先制作的素材,只有一个 Transformer 在预测接下来会发生什么。它目前只是概念验证,但不妨想象一下这项技术会走向何方。其 500M 参数版本已经开放。
GameGen-X 发布了规模最大的开放世界游戏视频数据集。如果你想训练自己的模型,或对现有模型进行微调以生成类似游戏的内容,它就是很好的起点。
NVIDIA Cosmos 原本为机器人和自动驾驶汽车而打造,但其中的世界基础模型同样适用于游戏。它们能够理解物理规律、物体恒存和空间关系。目前开放的产品线是 Cosmos-Predict2.5,于 2025 年 10 月发布,采用 NVIDIA Open Model License,允许商业使用和创建衍生作品。
Hunyuan-GameCraft(Tencent,2025 年 8 月)是形态最贴近游戏的开放世界模型。它基于 100 多款 AAA 游戏的一百多万段录像进行训练,并将键盘和鼠标输入统一到共享控制空间中,因此生成的是你真正能够操控、而不只是观看的交互式游戏视频。它采用与 Hunyuan3D 相同的 Tencent Community License,同样排除欧盟、英国和韩国,因此在这些地区发布前请检查条款。MineWorld(Microsoft,MIT)则是完全宽松授权的 Oasis 对应方案:一个无需游戏引擎、可以下载并运行的实时 Minecraft 世界模型。
Genie 3(DeepMind,2025 年 8 月公布)是值得关注的一次飞跃:它是首个支持实时交互的世界模型,能够以 24fps 生成可探索的 720p 世界,并在几分钟内保持一致性;它还支持“可提示的世界事件”,可根据指令改变天气或添加物体。2026 年 1 月,它以 Project Genie 的形式向美国的 Google AI Ultra 订阅者开放。其权重仍未开放,但已经展现了可游玩生成式世界的发展方向。
Matrix-Game 3.0(Skywork,2026 年 3 月)是对 Genie 的开放回应。它是一款带有记忆增强能力的交互式世界模型,能够以 40fps 实时输出 720p 画面,并在长达数分钟的序列中保持场景一致。其 5B 蒸馏版本可执行实时推理,更大的 2x14B MoE 版本则进一步提升质量;模型权重已通过 Hugging Face 发布并采用 Apache 2.0 许可证。如果你现在就想试验可游玩的生成式世界,而不是等待 DeepMind,那么这是你真正可以下载的选择。
就现阶段的实际游戏开发而言,这些仍然只是研究工具。但如果你正在从事 AI 驱动内容、程序化生成,或者只是思考这一切将走向何方,那么这里就是最前沿。
大语言模型
LLM 为对白、任务生成和游戏逻辑提供动力。如今,开放模型已能真正与 GPT-4 竞争,而两年前还不是这样。
| 模型 | 组织 | 发布时间 | 规模 | 最适合 | 许可证 | 每千 Token 成本 |
|---|---|---|---|---|---|---|
| DeepSeek-V3 | DeepSeek | 2024 年 12 月 | 671B MoE(激活 37B) | 推理、通用任务 | 宽松许可证 | ~$0.02 |
| DeepSeek-R1 | DeepSeek | 2025 年 1 月 | 基于 V3 | 思维链推理 | 宽松许可证 | ~$0.03 |
| DeepSeek-V3.2 | DeepSeek | 2025 年 12 月 | 稀疏注意力(DSA) | 推理与工具调用 | MIT | ~$0.02 |
| DeepSeek-V4 | DeepSeek | 2026 年 4 月 | 1.6T MoE(激活 49B) | 前沿推理、1M 上下文 | MIT | ~$0.02 |
| GLM-5 | Zhipu / Z.ai | 2026 年 2 月 | 744B MoE(激活 40B) | 编程、智能体、工具调用 | MIT | ~$0.02 |
| GLM-5.2 | Zhipu / Z.ai | 2026 年 6 月 | 753B MoE | 编程、智能体、1M 上下文 | MIT | ~$0.02 |
| GPT-OSS | OpenAI | 2025 年 8 月 | 120B / 20B MoE | 推理、工具调用、设备端运行 | Apache 2.0 | ~$0.01 |
| Kimi K2 | Moonshot | 2025 | 1T MoE(激活 32B) | 智能体、编程 | 修改版 MIT | ~$0.02 |
| Kimi K3 | Moonshot | 2026 年 7 月 | 2.8T MoE(896 个专家中激活 16 个) | 前沿智能体、编程、1M 上下文、视觉 | Kimi K3 License | ~$0.03 |
| Hy3 | Tencent | 2026 年 7 月 | 295B MoE(激活 21B) | 推理、智能体编程、256K 上下文 | Apache 2.0 | ~$0.02 |
| Gemma 3 | 2025 | 1B-27B | 设备端运行、140 种语言、视觉 | Gemma | ~$0.01 | |
| Gemma 4 | 2026 年 4 月 | E2B 至 31B(26B-A4B MoE) | 设备端运行、140 多种语言、视觉与音频、256K | Apache 2.0 | ~$0.01 | |
| Qwen3 | Alibaba | 2025 | 235B MoE(激活 22B) | 多语言、编程 | Apache 2.0 | ~$0.01 |
| Qwen3.5 / 3.6 / 3.8 | Alibaba | 2026 年 2 月至 8 月 | 0.8B 至 2.4T-A95B | 多模态、智能体、Qwen-Max 级开放旗舰模型 | Apache 2.0 | ~$0.02 |
| Mistral Small 4 | Mistral | 2026 年 3 月 | 119B MoE(激活 6B) | 推理、视觉、智能体编程、256K | Apache 2.0 | ~$0.01 |
| Qwen3-Coder | Alibaba | 2025 | 480B MoE(激活 35B) | 智能体编程、256K 上下文 | Apache 2.0 | ~$0.02 |
| Llama 4 | Meta | 2025 | 多种规模 | 智能体、最高 10M 上下文 | Llama Community | ~$0.01 |
| Muse Glimmer 30B | Meta | 2026 年 8 月 | 约 30B 稠密模型 | 设备端智能体、视觉、128K+ 上下文 | Apache 2.0 | ~$0.01 |
| Qwen3-VL | Alibaba | 2025 | 2B-235B | 视觉与语言 | Apache 2.0 | ~$0.02 |
| InternVL3 | Shanghai AI Lab | 2025 | 1B-78B | 视觉、OCR、UI 定位 | MIT | ~$0.02 |
开始使用:Hugging Face 上的 Qwen3-8B ↗ · Hugging Face 上的 DeepSeek-V3 ↗ · Hugging Face 上的 GLM-5 ↗
用于制作游戏
Qwen3 是大多数游戏用途中的实用选择。它采用 Apache 2.0 许可证,意味着集成成果归你所有。其多语言支持非常出色,如果你正在考虑本地化,这一点尤其重要。它也很擅长遵循结构化指令。7B 和 14B 版本可在消费级 GPU 上本地运行。
Qwen3.5、3.6 和 3.8 在 2026 年继续沿用 Apache 2.0 许可证。Qwen3.5(2026 年 2 月 16 日)率先推出 397B-A17B MoE,随后补充了稠密的 27B、9B 和 4B 版本。Qwen3.6(4 月)针对稳定性调整了同一模型家族,而其中的 35B-A3B 是本地运行的最佳平衡点:拥有 35B 参数承载的知识,但每个 Token 只激活 3B 参数,因此可在单张 24GB 显卡上高速运行。Qwen3.8(2026 年 8 月 12~14 日)则是其中的重磅版本;Qwen3.8 仓库称其为首个开放发布的 Qwen-Max 级模型,包括 2.4T-A95B 旗舰模型和一个 27B 稠密模型,两者均采用 Apache 2.0 许可证,并支持 262K 上下文。
DeepSeek-V3 在多数基准测试中达到或超过 GPT-4。其架构十分巧妙:总参数量达到 671B,但每个 Token 只激活 37B 参数。它需要强大的硬件(多 GPU),但无需依赖 API 即可获得前沿水平的质量。
DeepSeek-V3.2(2025 年 12 月)把推理与工具调用整合到同一模型中,并引入 DeepSeek Sparse Attention(DSA),以降低长上下文推理成本;此外还提供面向顶尖推理基准测试的高算力 Speciale 版本。对于游戏逻辑和对白而言,它是比 V3 更强、智能体能力更出色的直接替代方案。
DeepSeek-V4(2026 年 4 月)再次推进了开放模型的前沿。V4-Pro 是一个拥有 1.6T 参数的 MoE 模型,每个 Token 仅激活 49B 参数,具有 100 万 Token 的上下文窗口和可选推理模式,并完全采用 MIT 许可证。V4-Flash 版本(总计 284B 参数,激活 13B)则在无需完整 GPU 集群的模型规模下保留了 1M 上下文能力。如果你现在要为复杂的任务逻辑或超长游戏状态上下文选择开放模型,它代表了当前能力上限。
GLM-5(Zhipu AI,2026 年 2 月)是目前编程和智能体任务领域最具竞争力的开放模型,而 GLM-5.2 更新进一步提高了工具调用与长程规划得分,使其接近闭源前沿模型。它是一个 744B 参数的 MoE 模型,每个 Token 激活 40B 参数,支持 200K Token 上下文,并采用 MIT 许可证。GLM-5.2 于 2026 年 6 月 17 日发布,是一个拥有 1M Token 上下文的 753B MoE 模型,仍采用 MIT 许可证且没有地区限制;随后发布的 GLM-5.3 则是在相同基础模型上进行后训练更新的版本,其权重已上传至 Hugging Face,但改用 Z.ai 自有的 GLM-5.3 许可证,而非 MIT,因此如果要自行托管最新版本,请仔细检查许可证文本。Z.ai 是首家上市的基础模型公司,其托管 API 定价非常激进(每百万输入 Token 约 $1.40);如果更愿意自行托管,也可以从 Hugging Face 获取权重。如果你的游戏依赖 LLM 编写任务脚本、驱动工具调用智能体或构建代码驱动的系统,那么 GLM-5 是一个完全由你掌控的强大 OpenAI 替代方案。 GPT-OSS(OpenAI,2025 年 8 月)是 OpenAI 首次发布的开放权重模型,正好切合本指南的主题。gpt-oss-120b 模型可在单张 80GB GPU 上以大致相当于 o4-mini 的水平进行推理和调用工具,而 gpt-oss-20b 可在 16GB 消费级显卡上运行,两者均采用 Apache 2.0 许可证。如果你想要一个可自行托管、用于 NPC 逻辑或工具调用型智能体的西方实验室模型,它就是首选。
Kimi K2(Moonshot)是与 GLM-5 和 DeepSeek 并列的另一款开放式智能体重量级模型。它是一个总参数量达 1 万亿、激活参数量为 32B 的 MoE 模型,针对编程和工具使用进行了重点调优。其 Modified MIT 许可证仅对月活跃用户超过 1 亿的情况增加限制,因此对独立开发者而言,它实际上等同于 MIT。需要智能体进行多步骤规划时,可以选择它。
Kimi K3(Moonshot,2026 年 7 月)是有史以来公布的最大开放权重模型,比以往任何开放模型都更接近闭源前沿水平。它是一个总参数量达 2.8 万亿的 MoE 模型,每个 token 仅激活约 50B 参数(896 个专家中激活 16 个),拥有 100 万 token 上下文和原生视觉能力,并基于两种名为 Kimi Delta Attention 和 Attention Residuals 的全新注意力设计构建。Moonshot 7 月公布的基准测试显示,它在编程和智能体任务上击败了当时发布的 Claude Opus 和 GPT-5.5,仅落后于最顶尖的专有模型;此后,随着 Claude Fable 5.1 和 GPT-6 Astra 于 9 月发布,这些标杆又向前推进了。权重于 2026 年 7 月 27 日以 MXFP4 格式发布在 Hugging Face 上,采用 Kimi K3 License,而非 MIT。它对大多数用途都很宽松,但任何连续 12 个月内营收超过 2000 万美元的模型即服务业务,都需要与 Moonshot 另行签署协议;月活跃用户超过 1 亿或月营收超过 2000 万美元的产品,则必须在界面中展示“Kimi K3”。自行托管 2.8T 模型仍然意味着需要多节点 GPU 集群,因此大多数团队会通过 API 使用它,价格为每百万输入 token 3 美元、每百万输出 token 15 美元。对于真正能够自行运行的智能体,K2 仍然是 Moonshot 系列中更务实的选择,但 K3 重新定义了顶尖“开放”模型所能达到的高度。
Gemma 3(Google)最适合需要在玩家硬件上运行或进行广泛本地化的场景。它提供 1B、4B、12B 和 27B 四种规模,可从 8GB 显卡起步扩展,支持 140 种语言和函数调用;4B 及以上版本还可以理解图像,因此也能兼作小型视觉模型。Gemma 许可证允许商业使用。
Gemma 4(Google,2026 年 4 月 2 日)已成为新项目的替代选择,并彻底解决了许可证问题:根据其模型卡,整个系列均采用 Apache 2.0。它提供面向手机和笔记本电脑的 E2B 与 E4B、12B、激活参数不足 4B 的 26B-A4B MoE,以及稠密型 31B;小型模型拥有 128K 上下文,其余型号为 256K;所有规模均原生支持图像输入,小型型号还支持音频,并覆盖 140 多种语言。如果你需要一个能够查看截图的端侧 NPC 大脑,26B-A4B 是最佳选择。
**Meta 的 Llama 系列实际上已经暂停。**Llama 4(2025 年 4 月)仍是最后一代 Llama;2026 年 4 月,Meta Superintelligence Labs 推出了它的闭源继任者 Muse Spark。2026 年 8 月,Meta 又部分回归开放路线,发布了 Muse Glimmer 30B:这是一款约 30B 参数的稠密型多模态模型,采用 Apache 2.0 许可证,拥有 128K 以上上下文,并提供可装入 24GB 显卡的 4 位版本。它是一款强大的本地智能体模型,但如果你还在等待 Llama 5,就别再等了,直接从 Qwen、Gemma 4 或 Glimmer 中选择吧。
Hy3(Tencent,2026 年 7 月)是另一款采用 Apache 2.0 许可证的重要新模型。根据其模型卡,它是一个总参数量 295B、激活参数量 21B、上下文长度 256K 的 MoE 模型。7 月发布版取消了 4 月预览版中的地区限制,因此与腾讯的 Hunyuan3D 和 GameCraft 许可证不同,它可以在欧盟、英国和韩国使用。
Qwen3-Coder(Alibaba)是专门面向编程的开放模型,在大多数用途上取代了较旧的 DeepSeek-Coder 系列。它是一个总参数量 480B、激活参数量 35B 的 MoE 模型,原生上下文长度为 256K(可扩展至 1M),采用 Apache 2.0 许可证,并且在智能体编程基准测试中达到 Claude Sonnet 级别。如果你的游戏需要生成或运行代码,它就是开放模型所能达到的上限。欧洲的 Mistral 系列是可靠的可自行托管替代方案:Devstral 适合编程,而 Mistral Small 4(2026 年 3 月 16 日)则是一个总参数量 119B、激活参数量 6B 的 MoE 模型,将推理、视觉和智能体编程能力整合进一个拥有 256K 上下文、采用 Apache 2.0 许可证的模型中。
Qwen3-VL 增加了视觉理解能力,提供从 2B 到 235B 的稠密型和 MoE 版本,均采用 Apache 2.0 许可证。它适合需要分析截图、理解玩家绘制内容或处理摄像头输入的游戏。8B 版本可在单张 GPU 上运行。InternVL3(Shanghai AI Lab,MIT)是另一款强大的开放视觉语言模型,尤其擅长 OCR 和 UI 定位;如果你的工具需要读取游戏界面,这一点很重要。Mistral 的 Pixtral 12B(Apache 2.0)则是更轻量且可安全商用的选择。
对于端侧 NPC,也就是无需调用云端便能实时响应的角色,目前最实用的方案是通过 NVIDIA ACE 使用 Qwen3-8B。它可以在玩家硬件上与游戏同时运行。
实用模型
这些模型不会直接生成内容,但能让你的工作流顺利运转。
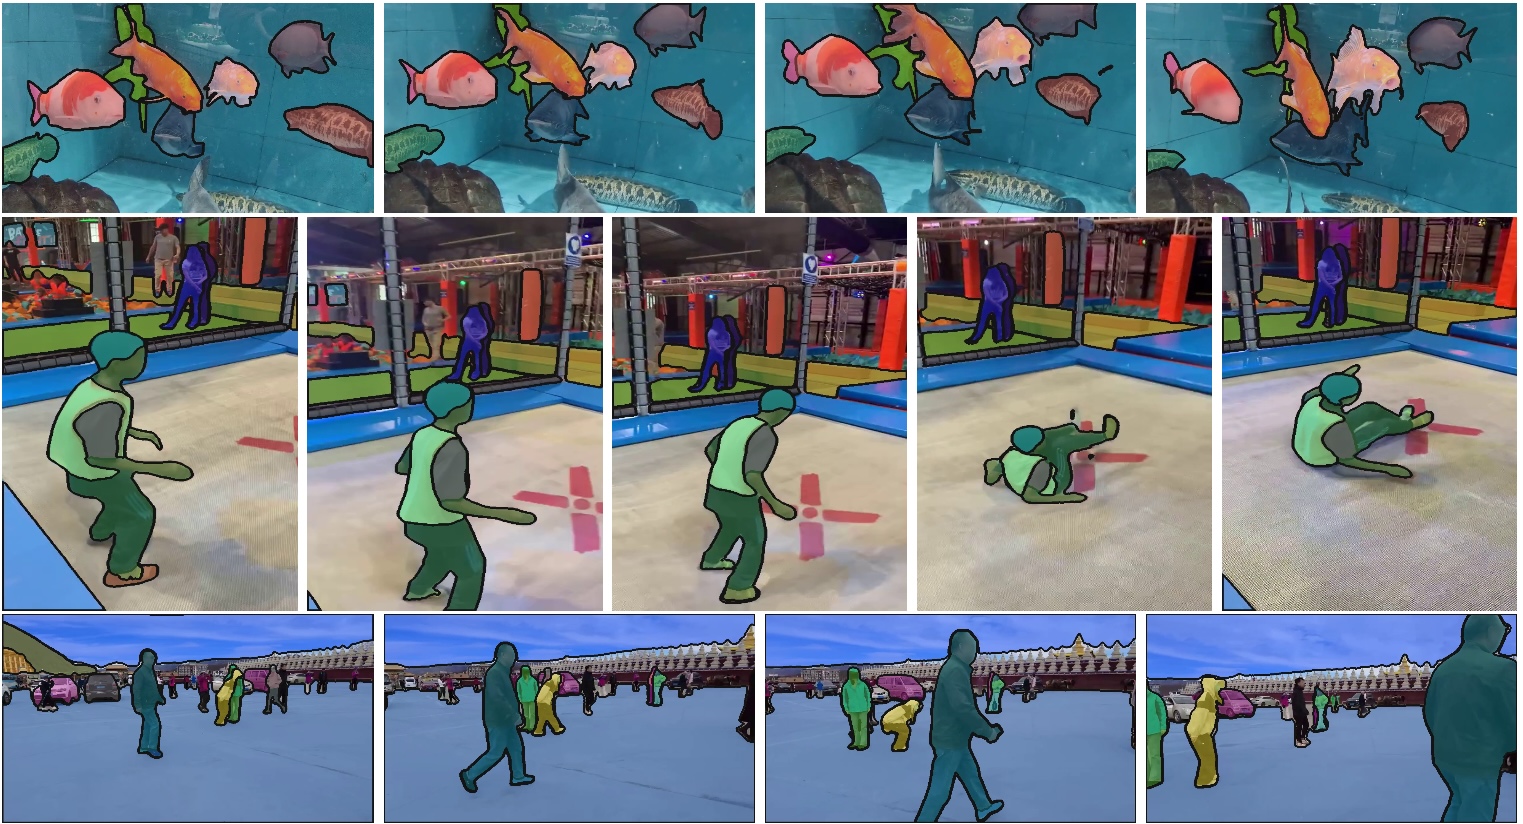 SAM 2 可以分割图像和视频中的任意对象。只需点击一次,即可获得完美蒙版
| 模型 | 组织 | 发布时间 | 功能 |
|---|---|---|---|
| SAM 2 | Meta | 2024 年 8 月 | 分割图像和视频中的任意对象 |
| Depth Pro | Apple | 2024 年 10 月 | 从单张图像生成公制深度 |
| gsplat | Nerfstudio | 2024 年起 | 使用 CUDA 加速的高斯泼溅 |
SAM 2 可以实时分割视频中的对象。点击某个对象,即可获得完美蒙版。它适用于转描、合成,或从影像中提取对象并用作游戏资产。试用 SAM 2 ↗
Apple 的 Depth Pro 能在不到一秒内从单张图像生成公制深度图。这带来了很多可能性:利用视差效果将 2D 美术转换为 2.5D、为 3D 重建生成深度数据,以及从平面图像创建法线贴图。HuggingFace 上的 Depth Pro ↗
gsplat 是高斯泼溅的高性能实现。如果你要为游戏采集真实环境,无论是进行摄影测量还是环境扫描,这个库都能让相关流程真正实用起来。
我实际会使用什么
如果你今天开始制作游戏,以下这套技术栈比较合理:
纹理和精灵图:FLUX.1 [schnell],Apache 2.0,迭代速度快,质量足以用于正式发布
概念美术:SD 3.5 Large,搭配 LoRA 控制风格
3D 资产:使用 Hunyuan3D 2.1 或 TRELLIS.2 生成带纹理的网格;从照片开始时使用 SAM 3D,然后在 Blender 中清理
自动绑定:使用 UniRig 或 NVIDIA SOMA-X 为生成的网格创建骨骼和蒙皮(两者均为开放模型),而不是依赖 Mixamo
音效:Stable Audio 的开放 Small-SFX 模型,可在本地运行,并获得商业许可
音乐:使用 ACE-Step 制作原型,最终制作阶段再聘请作曲家
语音:使用 Qwen3-TTS 进行声音克隆和生成环境对话(Apache 2.0);台词需要真实情感时使用 Chatterbox(MIT);重要台词则交给配音演员
NPC 对话:在本地运行 Qwen3.6-35B-A3B、Gemma 4 26B-A4B 或 Muse Glimmer 30B;复杂推理和工具调用则使用可自行托管的云端 LLM(GLM-5.2、DeepSeek-V4 或 Kimi K3)
视频(过场动画):本地使用 Mochi 1 或 Wan 2.2 5B;需要最终成片质量时,在云端使用 LTX-2.5 或 HunyuanVideo-1.5
关于这一切,有一点需要明确:常见的错误是试图让 AI 完成所有工作。这些是工具,而不是替代品。它们可以压缩迭代、制作变体和占位资产等繁琐环节,让你把时间花在真正重要的创意决策上,也就是那些让你的游戏独一无二的部分。
硬件现实检查
坦白说,运行这些模型实际需要的硬件如下:
8GB VRAM(RTX 3060、4060):SD 1.5/SDXL、Wan 2.1 小型版、AudioGen、Fish Speech、小型 LLM(7B 量化版)。这是游戏笔记本电脑级别,足以让你起步。
12GB VRAM(RTX 3080、4070):SD 3.5、FLUX schnell、Mochi 1、MusicGen、TripoSR、Qwen 14B 量化版。到了这个级别,使用体验会舒适很多。大多数实用模型都能在这里运行。
24GB VRAM(RTX 3090、4090):可全精度运行大多数模型,也能运行 InstantMesh、更大型的 LLM,以及 2026 年的本地智能体级模型:Qwen3.6-35B-A3B、4 位 Gemma 4 31B、4 位 Muse Glimmer 30B。如果你准备认真采用这套工作流,这是最理想的平衡点。
48-80GB VRAM(A100、H100):HunyuanVideo、LTX-2、DeepSeek-V3、生产规模的生成任务。这是企业级硬件。你不会购买,而会租用它。
RunPod、Lambda Labs 或 Modal 上的云实例,A100 每小时约需 2 至 4 美元。对于偶尔使用而言,这比购买硬件便宜。需要最终成片质量时启动实例,完成后关闭即可。
关于本指南中的成本估算:单次生成成本假定在云端 GPU 上自行托管推理,费用约为每小时 2 至 3 美元(A100)或每小时约 0.40 美元(RTX 4090)。实际成本会因硬件、优化方式和批量大小而异。这些只是用于规划的粗略数字,实际情况可能有所不同。
2026 年有哪些新变化
近期发布:LTX-2 和 LTX-2.3 带来了开放式同步音视频生成能力,并原生支持 4K。Microsoft 的 TRELLIS.2(2025 年 12 月)成为开放式图像转 3D 领域的领先者,Meta 的 SAM 3D(2025 年 11 月)则让单张照片的 3D 重建变得实用。FLUX.2 取代 FLUX.1 成为新一代图像生成模型,而 NVIDIA 的 SOMA-X 带来了开放式自动绑定和动作重定向能力。2026 年上半年仍保持着同样的速度:Qwen3-TTS(1 月)为声音克隆提供了真正采用 Apache 2.0 许可证的归宿;Zhipu 的 GLM-5(2 月)以 MIT 许可证发布了一款 744B 开放式编程与智能体模型;Skywork 的 Matrix-Game 3.0(3 月)以开放权重形式提供了实时交互式世界模型;DeepSeek-V4(4 月)以 MIT 许可证将开放 LLM 的上下文长度推至 100 万 token;Stable Audio 3.0(5 月)发布了三款使用授权数据训练的开放音频模型;Ideogram 则在 6 月发布了其首款开放权重图像模型。随后在 7 月,Moonshot 公布了总参数量达 2.8T 的开放权重模型 Kimi K3,其权重于 7 月 27 日以 Kimi K3 License 发布;同月,腾讯将 295B 的 Hy3 改为采用 Apache 2.0,而就在几周前,Z.ai 于 6 月 17 日以 MIT 许可证发布了 GLM-5.2。8 月的开放模型领域同样繁忙:Alibaba 发布了 Qwen3.8(包括一个 2.4T-A95B 旗舰模型和一个 27B 稠密型模型,均采用 Apache 2.0);Meta 以 Apache 2.0 发布了 Muse Glimmer 30B;MiniMax 开放了 33B 的 H3 视频模型权重;Lightricks 则发布了 LTX-2.5。更早些时候,Google 的 Gemma 4(4 月,Apache 2.0)和 Mistral Small 4(3 月,Apache 2.0)重新定义了端侧模型的水平。
值得关注的趋势:顶尖实验室越来越倾向于只通过 API 提供最新模型,即使较早版本曾经开放。Wan 从 2.5 开始转为闭源,并一直持续到 3.0(2026 年 8 月);Qwen-Image 从 2.0 开始闭源,Hunyuan3D 则从 2.5 开始闭源。Meta 的 Llama 继任者 Muse Spark 于 2026 年 4 月以闭源形式推出,随后较小的 Muse Glimmer 才在 8 月重新开放;Black Forest Labs 优先通过 API 提供 FLUX 3,并承诺稍后于 2026 年发布开放的 FLUX 3 Dev;Skywork 也在 2 月公布了 SkyReels V4,但没有发布权重。开放生态依然活跃且发展迅速,但“最新版本一定开放”已不再是安全的假设,因此在围绕某个模型构建工作流之前,请先确认其权重是否可用。
发展轨迹已经很清楚:闭源模型具备的每一种能力,都会在 6 至 12 个月后出现在开放模型中。问题不在于开放模型是否足够好。对于大多数用途,它们已经足够好了。真正的问题是,它们会以多快的速度成为默认选择。
而这对创作者意味着:过去需要企业级预算或按月订阅才能使用的工具,正在变成你可以直接……运行的东西。就在自己的硬件上。无需征得任何人的许可。
这就是转变。这就是我们正在迈向的未来。
常见问题
哪款开源 AI 模型最适合生成游戏资产?
这取决于资产类型。对于 3D 模型,Hunyuan3D 是 2026 年最强的开放选择。对于 2D 美术和纹理,FLUX 在质量上领先。对于音效和音乐,开放音频模型也迅速追了上来。不存在唯一“最佳”的模型,因为游戏需要多种类型的资产,所以大多数创作者会串联使用多个模型,而不是只依赖一个。
开源 AI 模型是否已足以取代闭源 API?
对于 2026 年的大多数游戏资产制作工作而言,是的。开放模型在图像、3D 和音频生成方面如今已能媲美闭源 API,而且可以在自己的硬件上运行,无需按调用付费,也不用担心突如其来的价格变动。闭源模型在少数前沿任务上仍然领先,例如长视频生成,但这一差距通常会在 6 至 12 个月内缩小。
我可以在自己的 GPU 上运行这些生成式 AI 模型吗?
其中许多都可以。图像和音频模型可以舒适地运行在 RTX 4090 之类的单张消费级 GPU 上。更大型的视频和 3D 模型需要更多 VRAM,通常需要使用 A100 级云端 GPU。上面的硬件章节列出了各类模型的需求,方便你在正式投入前做好规划。
2026 年最好的开源前沿模型是什么?
截至 2026 年 9 月,开源前沿模型呈现四强竞争格局,答案取决于你能够运行什么。Kimi K3(2.8T MoE)规模最大,评分也最接近闭源领先模型,但其 Kimi K3 License 对大型模型即服务企业附加了额外条件。DeepSeek-V4-Pro(1.6T,激活参数 49B)和 Qwen3.8-2.4T-A95B 在这一规模下拥有最清晰宽松的许可证,分别为 MIT 和 Apache 2.0。GLM-5.2(753B,MIT)专注于编程和智能体任务。它们都无法装入单张 GPU,因此对于任何自行托管的场景,真正的“最佳”选择要低一个档次:Qwen3.6-35B-A3B、Gemma 4 31B 或 Muse Glimmer 30B。
最好的开源和闭源前沿图像生成模型有哪些?
开源模型:适合商业安全游戏美术、生成时间不到一秒的 FLUX.2 [klein] 4B(Apache 2.0);需要生成清晰可读文字时使用 Qwen-Image-2512(Apache 2.0);如果许可证适用且追求最高质量,则选择 FLUX.2 [dev] 或 Chroma1-HD。闭源模型:FLUX.2 [pro] 和仅提供 API 的 Qwen-Image-2.0,以及 2026 年推出的 Kling IMAGE 3.0(根据 Kling 指南,最多支持 10 张参考图像)和 xAI 的 Grok Imagine Image 2.0。目前,FLUX 3 的图像模型只能通过 BFL 的 API 使用,其承诺会在 2026 年晚些时候推出开放的 Dev 版本。对于游戏制作,开源档位已经足够优秀,因此闭源模型带来的主要优势是便利性。
哪些开放权重视频模型允许完整的商业部署?采用什么许可证?
如果你需要一个能够在企业规模下进行商业部署且没有收入上限的开放视频模型,稳妥的选择包括 Wan 2.2(Apache 2.0,包括 5B 和 14B MoE 变体)、Mochi 1(Apache 2.0)、Step-Video-T2V(MIT)和 CogVideoX 2B(Apache 2.0)。LTX-2 和 LTX-2.5 允许年收入低于 $10M 的企业免费商用,超过该金额则需要签订付费协议;这正是 Lightricks 实际提供的“付费获取权限”方案。MiniMax H3 根据 MiniMax H3 Community License 开放,但要求美国、欧盟、英国和韩国的用户先提交申请;HunyuanVideo 则采用腾讯的社区许可证,并包含地区性例外条款,因此在决定采用之前应仔细阅读两者的许可证。Wan 2.5 至 3.0、Veo、Kling 和 Seedance 均未公开任何权重。我们的参考图像视频模型指南对比了各种托管选项。
2026 年应该使用哪些生成式 AI 来制作游戏资产和环境?
与其寻找一个万能模型,不如串联几个专用模型。对于道具和角色,可以先使用 FLUX.2 klein 或 Qwen-Image 生成概念图,再通过 Hunyuan3D 2.1 或 TRELLIS.2 创建模型,并使用 UniRig 绑定骨骼。对于环境,可生成天空盒或 HDRI(我们的天空盒生成器可直接在浏览器中完成),以程序化方式构建地形,或按照我们的地形生成指南使用扩散模型生成地形,然后使用图像模型和 PBR 提取器制作纹理,具体方法参见我们的 AI 纹理生成器指南。音频可使用 Stable Audio 3.0 Small-SFX 和 ACE-Step,语音可使用 Qwen3-TTS 或 Chatterbox。截至 2026 年 9 月,这条工作流中的所有模型均为开放模型,并允许商业使用。
2026 年最适合本地运行的 LLM 是什么?
首先根据显存容量选择。8GB 显存可选择 Qwen3.5-4B 或 Gemma 4 E4B。16GB 显存可选择 gpt-oss-20b(Apache 2.0,专为 16GB 显存设计)或 Gemma 4 12B。24GB 显存下,Qwen3.6-35B-A3B 是最适合大多数人的全能模型;需要具备视觉能力的智能体工作时,可使用 4 位量化的 Muse Glimmer 30B;想要最强的稠密模型时,则可使用量化版 Gemma 4 31B。显存更多时,DeepSeek-V4-Flash(284B,激活参数 13B)是在工作站上实现 100 万 Token 上下文的最小选择。所有这些模型均采用 Apache 2.0 或 MIT 许可证,并且都能通过 Ollama 或 LM Studio 使用一条命令运行。
在商业游戏中使用 AI 生成的资产是否合法?
一般而言,如果你自行运行开源模型,答案是肯定的,但具体取决于模型许可证,以及你对训练数据所作的假设。请务必检查具体模型的许可证,并在平台要求时披露 AI 生成内容。关于我们的处理方式,请参阅 AI 生成内容政策。
延伸阅读
- AI 争议、信任与后 AI 经济:我们对游戏中 AI 应用的立场
- AI 生成内容政策:我们如何处理 AI 内容披露
- 支持参考图像的最佳 AI 视频模型:托管视频模型对比
- 最佳 AI 3D 模型生成器:将托管的 Meshy、Tripo 和 Rodin 与开放模型进行对比
- 2026 年网页游戏技术栈:用于游戏的 WebGL、WebGPU 和 Wasm
- 浏览器 3D 开放世界技术:在浏览器世界中使用 AI 生成的 3D 资产
- 浏览器开放世界的地形生成:基于扩散模型的地形合成
- 去哪里寻找免费游戏资产:除 AI 生成之外的传统资产来源
- 智能体式 AI 编程工具:使用 AI 编写游戏代码,而不只是生成资产