Odyssey-3, 2시간 분량의 영상으로 GTA V를 학습한 뒤 Red Dead Redemption 2에서 말을 타다
Oliver Cameron과 Jeff Hawke가 2023년에 설립한 월드 모델 기업 Odyssey가 9월 15일 Odyssey-3를 공개했다. 핵심 구상은 물리적 세계가 어떻게 움직이는지 이해하는 하나의 사전 학습 모델에, 특정 몸을 제어하기 위한 소형 '액션 디코더'를 결합하는 것이다. 그 몸은 로봇 팔, 휴머노이드, 자동차, 드론 또는 비디오 게임 속 캐릭터일 수 있다. 그중에서도 우리의 눈길을 사로잡은 것은 게임 관련 결과였다. 약 2시간 분량의 GTA V 영상으로 학습한 이동 정책이 두 게임을 전혀 학습하지 않고도 Red Dead Redemption 2에서 말을 타고 Sleeping Dogs에서 오토바이를 몰았다. Odyssey의 발표.
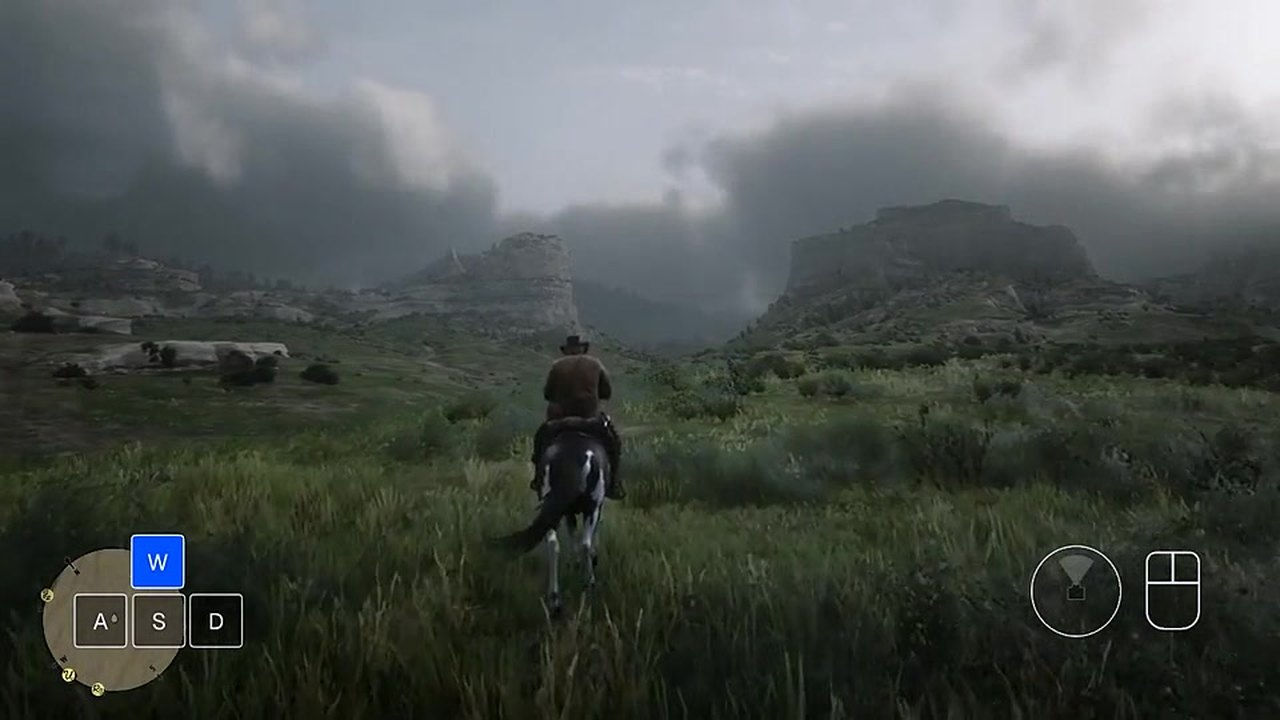
GTA V만으로 학습한 정책을 사용해 Red Dead Redemption 2에서 말을 타는 Odyssey-3. 오버레이에는 현재 누르고 있는 키가 표시된다. 이미지: Odyssey.
하나의 모델, 여러 몸
Odyssey-3는 회사가 방대한 시각 관찰 데이터 모음이라고 부르는 자료로 학습한 자기회귀 확산 트랜스포머다. 세계가 어떻게 움직이는지에 관한 범용적이고 인과적인 모델을 학습하는 것이 목표다. 이 모델은 동결된 상태로 유지된다. Odyssey는 각 신체 형태에 맞춰 관찰-행동 쌍으로 소형 액션 디코더를 학습하며, 디코더는 월드 모델의 내부 상태를 해당 몸에 필요한 제어 입력으로 변환한다.
Odyssey의 주장은 동결된 모델이 이해의 대부분을 담당하므로 디코더에는 극히 적은 데이터만 필요하다는 것이다. 로봇 팔은 수십 시간 분량의 시연으로 학습하며, 발표 영상에서는 물체 잡기에 실패한 뒤 스스로 복구하고 엉뚱한 방향으로 떨어진 물체를 집어 올리는 모습이 나온다. Flexion과 함께 진행한 휴머노이드 작업에서는 수십 시간 분량의 원격 조작 데이터로 학습한다. 드론은 수십 시간 분량의 시뮬레이션 비행을 통해 경유점까지 비행하는 법을 학습한다. 주행 관련 수치가 가장 구체적이다. 20시간의 시뮬레이션 주행으로 학습한 정책은 실제 영상으로 학습한 정책과 비교했을 때, 교통량이 많은 인도 도로에서 안전 운전자의 개입 사이에 약 77%만큼의 거리를 주행했다. 이 모든 결과는 업체가 제공한 데모에 기반한 업체의 주장으로, Odyssey 외부에서는 어느 것도 재현되지 않았다.
게임 에이전트는 픽셀을 보고 키를 누른다
게임용 디코더는 게임 플레이 녹화 영상과 해당 플레이를 만들어 낸 키보드 및 마우스 입력의 쌍으로 학습한다. 실행 시 정책은 최근 프레임을 보고 키 입력과 마우스 움직임을 출력한 다음 어떤 일이 벌어지는지 관찰한다. 게임 API나 게임 상태에는 접근하지 않는다. 노트북에서 사람이 플레이하는 것과 같은 방식으로 게임을 하기 때문에 데모 영상 한쪽 구석에는 작은 WASD 오버레이도 표시된다. 바로 에이전트가 누르고 있는 키다.
Odyssey는 GTA V에서 운전, 사격, 근접 전투를 포함한 장시간 플레이 세션을 수행했다고 밝혔다. 특히 인상적인 부분은 전이 결과다. 약 2시간 분량의 GTA 영상으로 학습한 이동 정책이 캐릭터와 이동 수단, 세계가 모두 다른 Red Dead Redemption 2에서 말을 탄 캐릭터를 움직였고 Sleeping Dogs에서는 오토바이를 몰았다. 2시간은 아무것도 아닌 수준이다. 이는 디코더가 'GTA' 자체를 학습한다기보다, 장소를 이동한다는 월드 모델의 개념을 네 개의 키와 마우스 입력에 연결하는 법을 학습한다는 의미다.
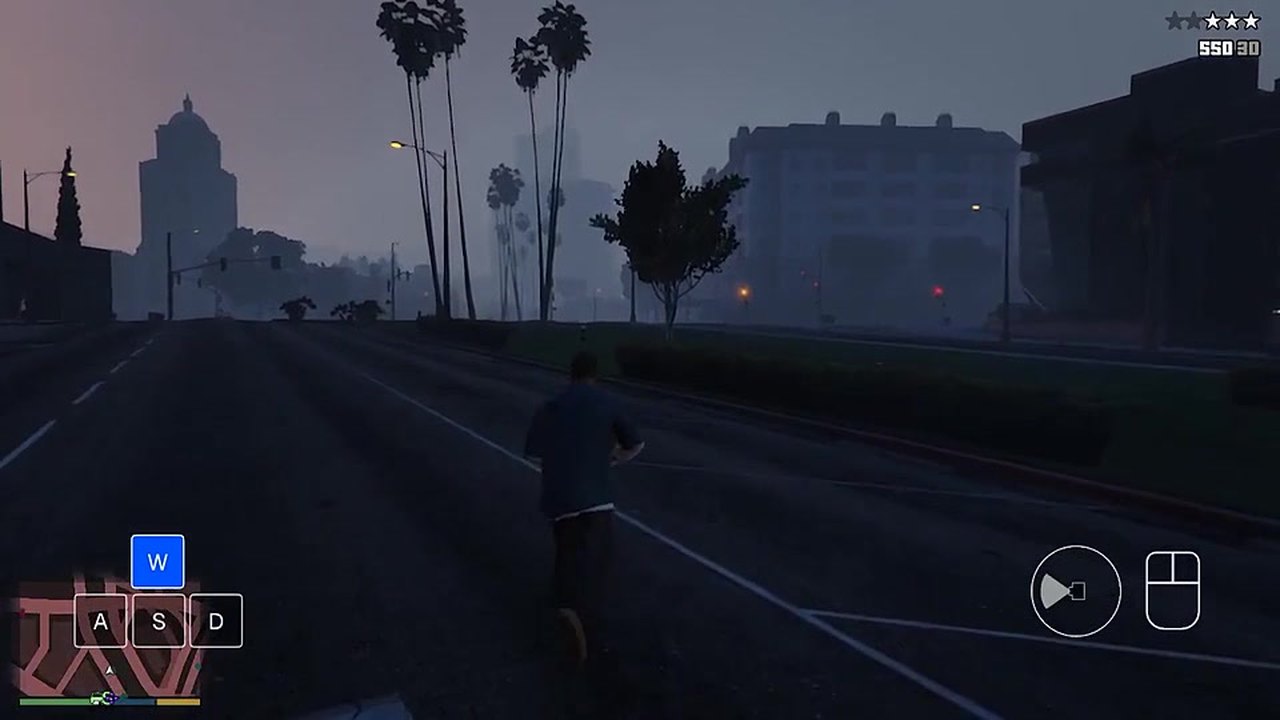
실제로 학습에 사용된 게임인 GTA V에서 작동하는 동일한 정책. 이미지: Odyssey.
발표에는 모델이 환경을 생성하고 에이전트가 그 안을 탐색하도록 하는 모습도 나온다. 충분히 좋은 시뮬레이터는 내부에서 작동하는 에이전트를 학습할 수 있으며, 에이전트의 실패는 시뮬레이터가 무엇을 잘못 구현했는지 보여 준다는 설명이다. 이 순환 구조가 실제 제품이다. 로봇, 자동차, 게임은 이 순환이 완성된다는 사실을 보여 주는 사례다. Odyssey는 어떤 형태로 공개할지는 밝히지 않은 채, 향후 몇 주 안에 모델을 대중에게 공개하겠다고 밝혔다.
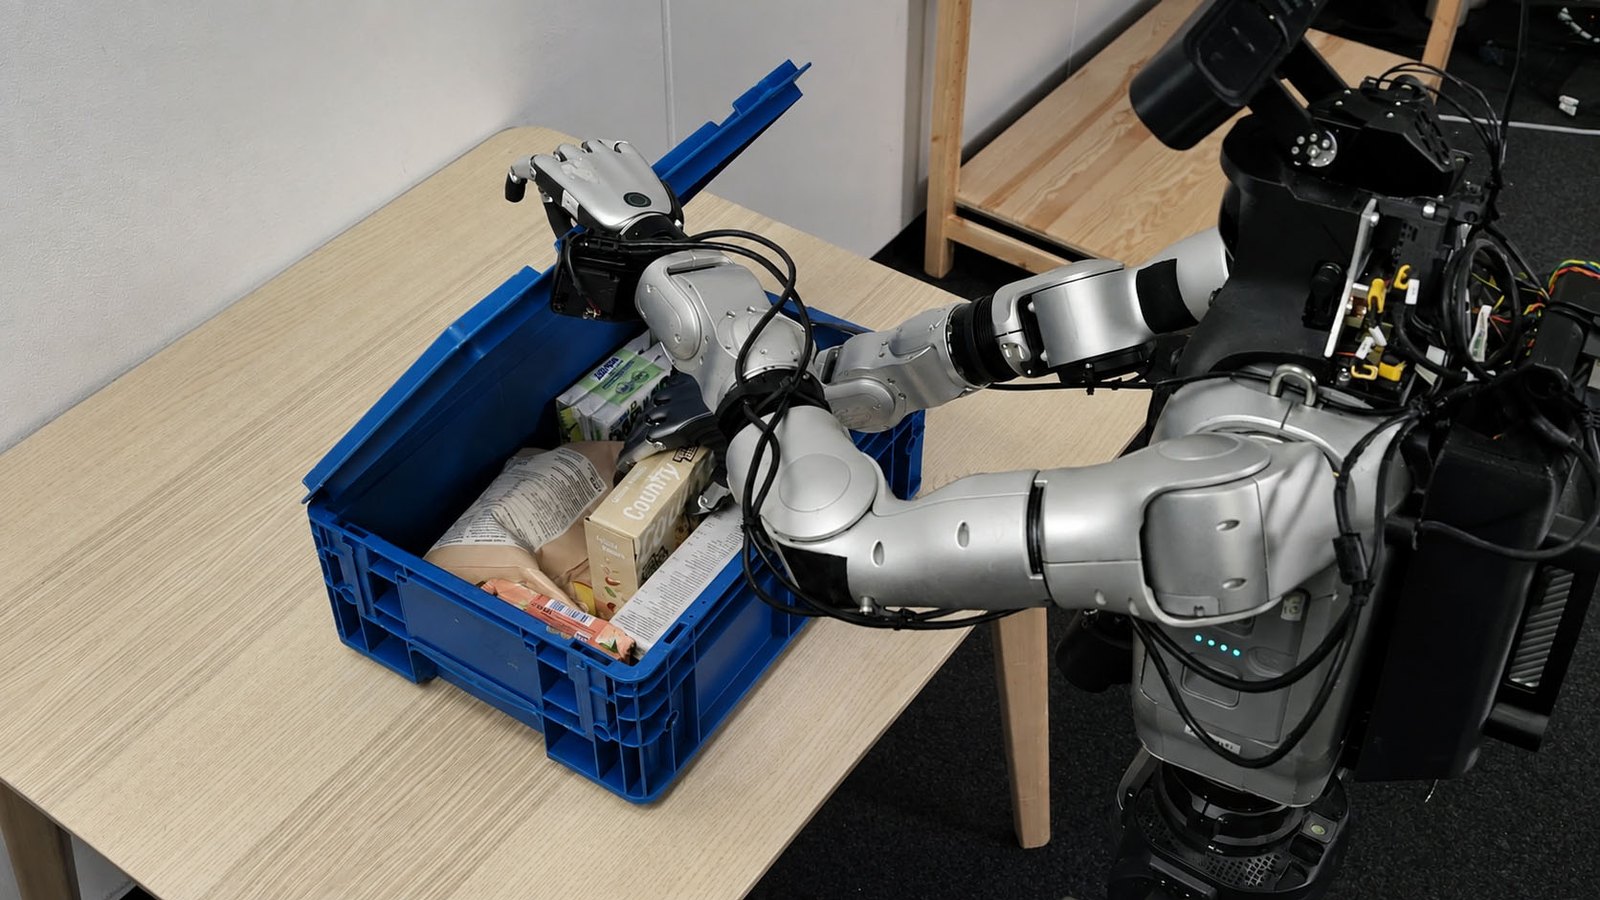
동일한 동결 모델이 양팔 로봇을 제어해 식료품 상자 작업을 수행하는 모습. 이미지: Odyssey.
이것이 우리에게 중요한 이유
우리는 올해 세 가지 월드 모델 소식을 다뤘으며, 각각은 서로 다른 방향을 가리킨다. MIRA는 게임 엔진을 대체하고 모델에서 곧바로 플레이 가능한 경기를 렌더링했다. World Labs의 Atlas는 세계 자체를 생성하고 재구성하며 시뮬레이션한다. Odyssey-3는 엔진을 그대로 둔 채 그 안에서 플레이한다. 세 가지 중 이미 만든 게임에 직접 영향을 주는 것은 이 방식이다.
우리의 게임 크리에이터로 만든 모든 게임은 브라우저에서 실행되며 키보드와 마우스 입력을 받는다. 바로 이 정책이 사용하는 인터페이스다. 2시간 분량의 영상만으로 GTA V를 돌아다닐 수 있는 에이전트라면 크리에이터가 만든 소규모 게임에서는 훨씬 적은 데이터로도 움직일 가능성이 크다. 그런 에이전트는 지루해하지 않고, 설명도 필요 없으며, 조작 방식이 자연스러운지 1분 안에 알려 주는 플레이테스터가 될 수 있다. 우리는 이미 이 문제에 많은 노력을 들이고 있다. 반전된 카메라와 반응하지 않는 점프는 새 게임이 외면받는 가장 흔한 이유이기 때문이다. 사람이 게임을 보기 전에 저렴한 에이전트가 '첫 번째 문을 통과할 수 없었어요'라고 알려 준다면 테스트 방식이 달라질 것이다.
반대 방향의 영향도 있다. 3D 세계를 이동하는 능력이 이처럼 쉽게 게임 간에 전이된다면, 게임 플레이 에이전트의 월드 모델 부분은 범용 상품에 가까워지고 있다. 결국 중요한 부분은 디코더가 될 것이다. 게임이 조작 체계를 어떻게 노출하는지, 피드백이 얼마나 명확한지, 에이전트가 올바른 행동을 했는지 판단할 수 있는지가 중요해진다. 이는 사람이 게임을 원활하게 플레이할 수 있도록 만드는 특성과도 같다. 에이전트를 위한 설계와 플레이어를 위한 설계가 결국 같은 작업으로 드러날 수도 있다.