Odyssey-3 aprende GTA V con dos horas de vídeo y luego monta a caballo en Red Dead Redemption 2
Odyssey, la empresa de modelos del mundo fundada en 2023 por Oliver Cameron y Jeff Hawke, presentó Odyssey-3 el 15 de septiembre. La propuesta consiste en un único modelo preentrenado que entiende cómo se comporta el mundo físico, al que se acoplan pequeños «decodificadores de acciones» para controlar un cuerpo concreto: un brazo robótico, un humanoide, un coche, un dron o un personaje de videojuego. El resultado en videojuegos es el que nos llamó la atención. Una política de movimiento entrenada con unas dos horas de vídeo de GTA V logró montar a caballo en Red Dead Redemption 2 y conducir una motocicleta en Sleeping Dogs, sin haber sido entrenada con ninguno de los dos juegos. Anuncio de Odyssey.
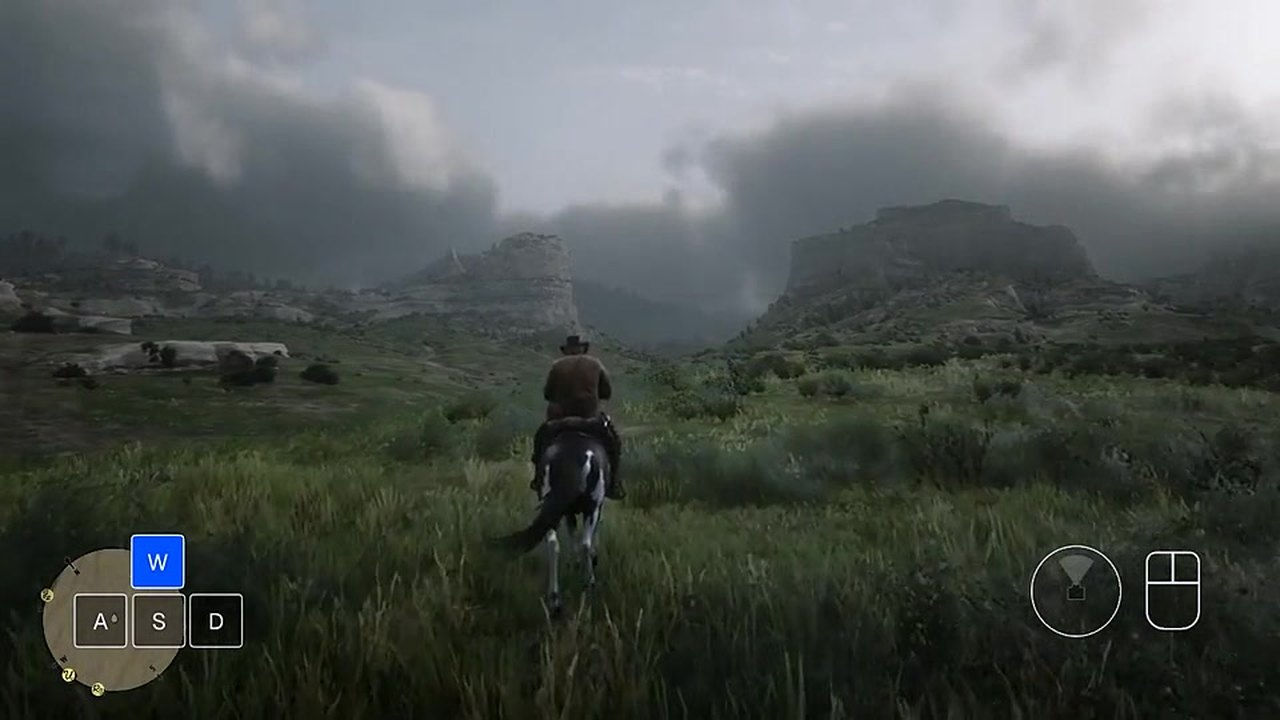
Odyssey-3 cabalgando en Red Dead Redemption 2 con una política entrenada únicamente con GTA V. La superposición muestra las teclas que pulsa. Imagen: Odyssey.
Un modelo, muchos cuerpos
Odyssey-3 es un transformador de difusión autorregresivo entrenado con lo que la empresa denomina una enorme colección de observaciones visuales, con el objetivo de aprender un modelo general y causal del comportamiento del mundo. Ese modelo permanece congelado. Para cada tipo de cuerpo, Odyssey entrena un pequeño decodificador de acciones con pares de observación y acción, cuya función es traducir el estado interno del modelo del mundo en los controles que necesita ese cuerpo.
La empresa sostiene que el modelo congelado contiene la mayor parte de la comprensión, por lo que los decodificadores necesitan muy pocos datos. Los brazos robóticos aprenden con decenas de horas de demostraciones, y el anuncio muestra a uno recuperándose tras fallar al agarrar un objeto y recogiendo el objeto, que había caído en una orientación poco habitual. Los humanoides, en colaboración con Flexion, aprenden con decenas de horas de teleoperación. Los drones aprenden a volar hasta puntos de ruta con decenas de horas de vuelo simulado. La cifra sobre conducción es la más concreta: una política entrenada con 20 horas de conducción simulada recorrió alrededor del 77 % de la distancia entre intervenciones del conductor de seguridad en transitadas carreteras de la India que una política entrenada con imágenes reales. Todas estas son afirmaciones del proveedor basadas en demostraciones propias, y ninguna ha sido reproducida fuera de Odyssey.
El agente de juego ve píxeles y pulsa teclas
El decodificador para videojuegos se entrena con grabaciones de partidas asociadas a las entradas de teclado y ratón que las produjeron. Durante la ejecución, la política observa los fotogramas recientes, genera pulsaciones de teclas y movimientos del ratón, y observa qué sucede a continuación. No utiliza ninguna API del juego ni tiene acceso a su estado. Juega igual que una persona con un portátil, lo que también explica por qué el vídeo de la demostración incluye una pequeña superposición de WASD en una esquina: esas son las teclas que pulsa.
Odyssey informa de sesiones prolongadas en GTA V que incluyen conducción, tiroteos y combates cuerpo a cuerpo. La transferencia es la parte más llamativa. Una política de movilidad entrenada con unas dos horas de vídeo de GTA desplazó a un personaje a caballo en Red Dead Redemption 2 —un juego diferente, con otro personaje, vehículo y mundo— y condujo una motocicleta en Sleeping Dogs. Dos horas no son nada. Esto significa que el decodificador no está aprendiendo tanto «GTA» como a trasladar la noción del modelo del mundo sobre cómo moverse por un lugar a cuatro teclas y un ratón.
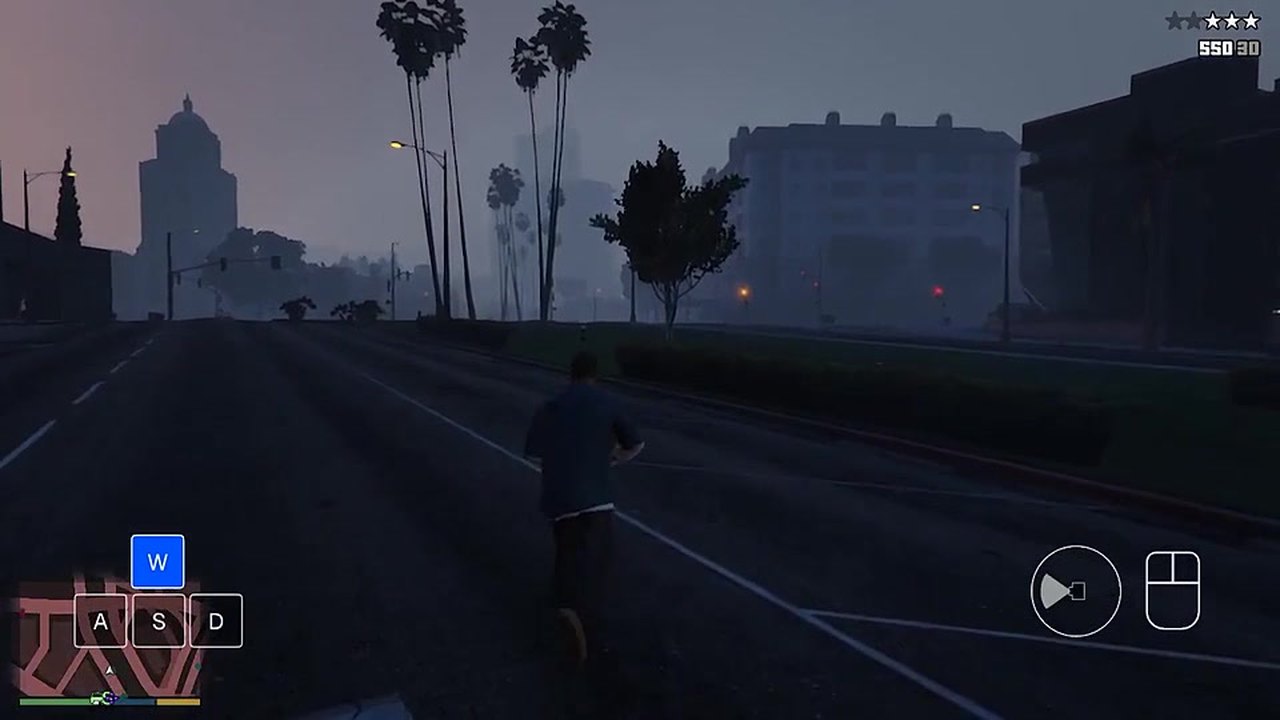
La misma política en GTA V, el juego con el que realmente fue entrenada. Imagen: Odyssey.
El anuncio también muestra al modelo generando entornos y permitiendo que los agentes los exploren, con el argumento de que un simulador suficientemente bueno puede entrenar a los agentes que operan en su interior, y que los fallos de estos señalan qué aspectos representa mal el simulador. Ese ciclo es el producto real. Los robots, coches y juegos son demostraciones de que el ciclo se cierra. Odyssey afirma que publicará el modelo en las próximas semanas, sin especificar en qué formato.
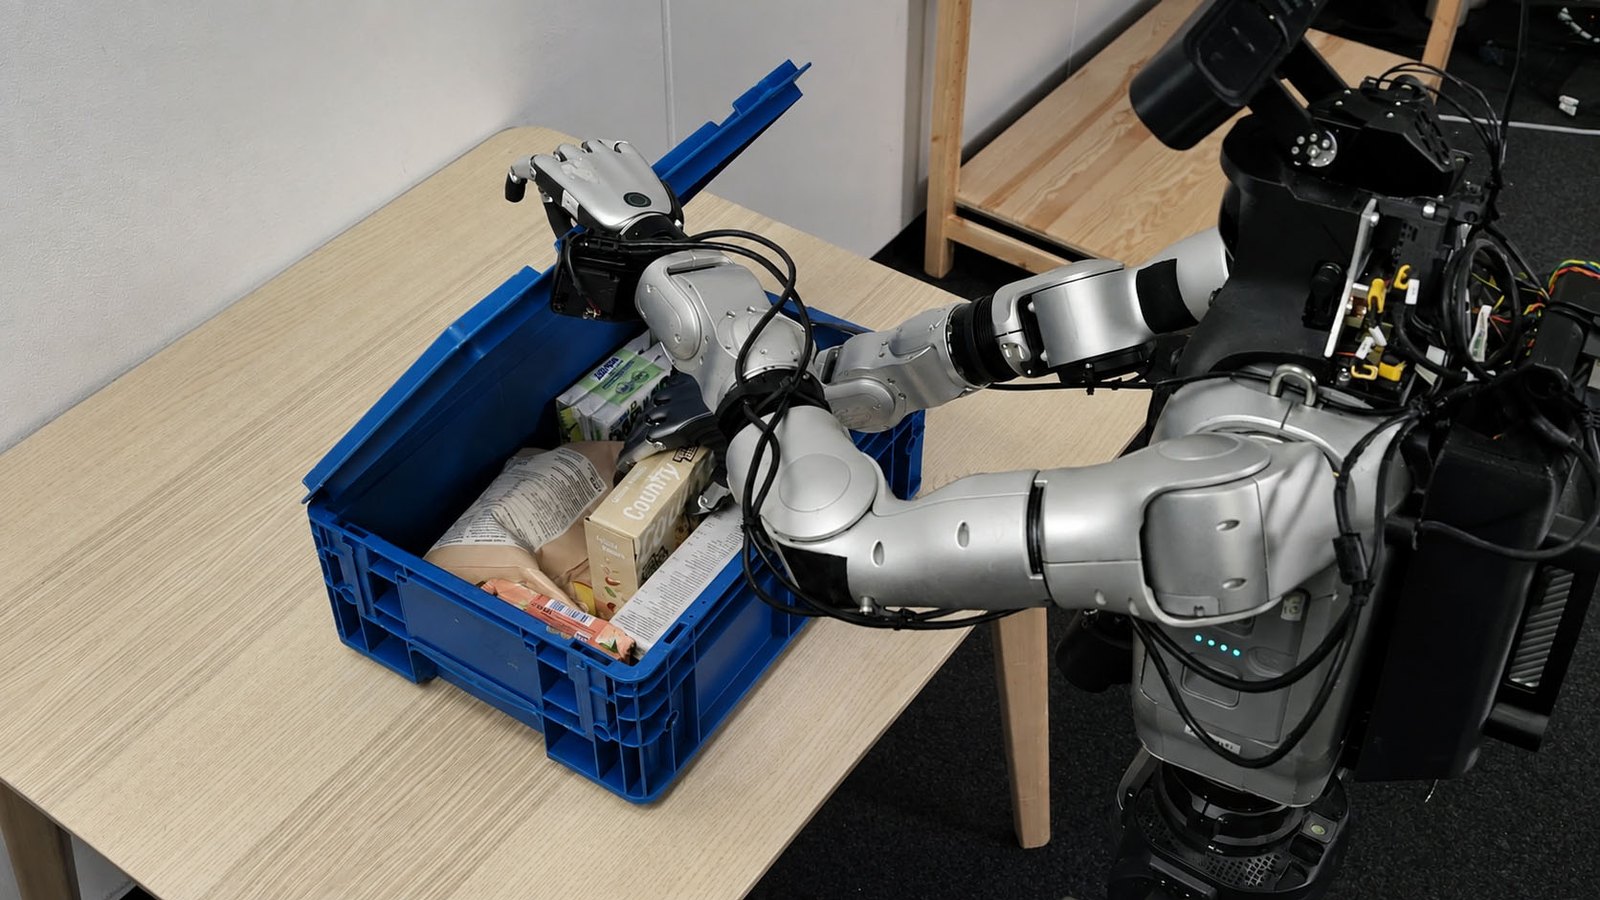
El mismo modelo congelado controlando un robot de dos brazos en una tarea con una caja de alimentos. Imagen: Odyssey.
Por qué esto nos afecta
Este año hemos cubierto tres historias sobre modelos del mundo, y cada una apunta en una dirección diferente. MIRA sustituyó el motor del juego y renderizó una partida jugable directamente desde el modelo. Atlas de World Labs genera, reconstruye y simula el propio mundo. Odyssey-3 no toca el motor y juega dentro de él. De los tres, este es el que puede aplicarse a un juego que ya hayas creado.
Todos los juegos creados en nuestro Creador de juegos se ejecutan en un navegador y reciben entradas de teclado y ratón, que es exactamente la interfaz que utiliza esta política. Un agente capaz de moverse por GTA V tras dos horas de vídeo probablemente pueda recorrer un pequeño juego creado por un usuario con aún menos material, y eso supone disponer de un probador que nunca se aburre, no necesita instrucciones y puede decirte en menos de un minuto si tus controles tienen sentido. Ya dedicamos mucho esfuerzo a esa cuestión, porque las cámaras invertidas y los saltos que no responden son los motivos más habituales por los que se abandona un juego nuevo. Un agente barato que avise «no pude pasar de la primera puerta» antes de que una persona llegue a ver el juego cambiaría nuestra forma de probarlo.
También tiene otra lectura. Si desplazarse por un mundo 3D se transfiere entre juegos con tanta facilidad, el modelo del mundo del agente que juega está cerca de convertirse en un producto básico, y la parte que importará será el decodificador: cómo expone un juego sus controles, hasta qué punto resulta clara su respuesta y si un agente puede saber que ha hecho lo correcto. Esas son las mismas propiedades que hacen que un juego resulte jugable para una persona. Diseñar para el agente y diseñar para el jugador podrían terminar siendo la misma tarea.