Odyssey-3 aprende GTA V com duas horas de vídeo e depois cavalga em Red Dead Redemption 2
A Odyssey, empresa de modelos de mundo fundada em 2023 por Oliver Cameron e Jeff Hawke, apresentou o Odyssey-3 em 15 de setembro. A proposta é um único modelo pré-treinado que entende como o mundo físico se comporta, com pequenos “decodificadores de ações” acoplados para controlar um corpo específico: um braço robótico, um humanoide, um carro, um drone ou um personagem de videogame. O resultado nos jogos foi o que nos chamou a atenção. Uma política de movimento treinada com cerca de duas horas de vídeo de GTA V conseguiu cavalgar em Red Dead Redemption 2 e pilotar uma motocicleta em Sleeping Dogs, sem ter sido treinada em nenhum dos dois jogos. Anúncio da Odyssey.
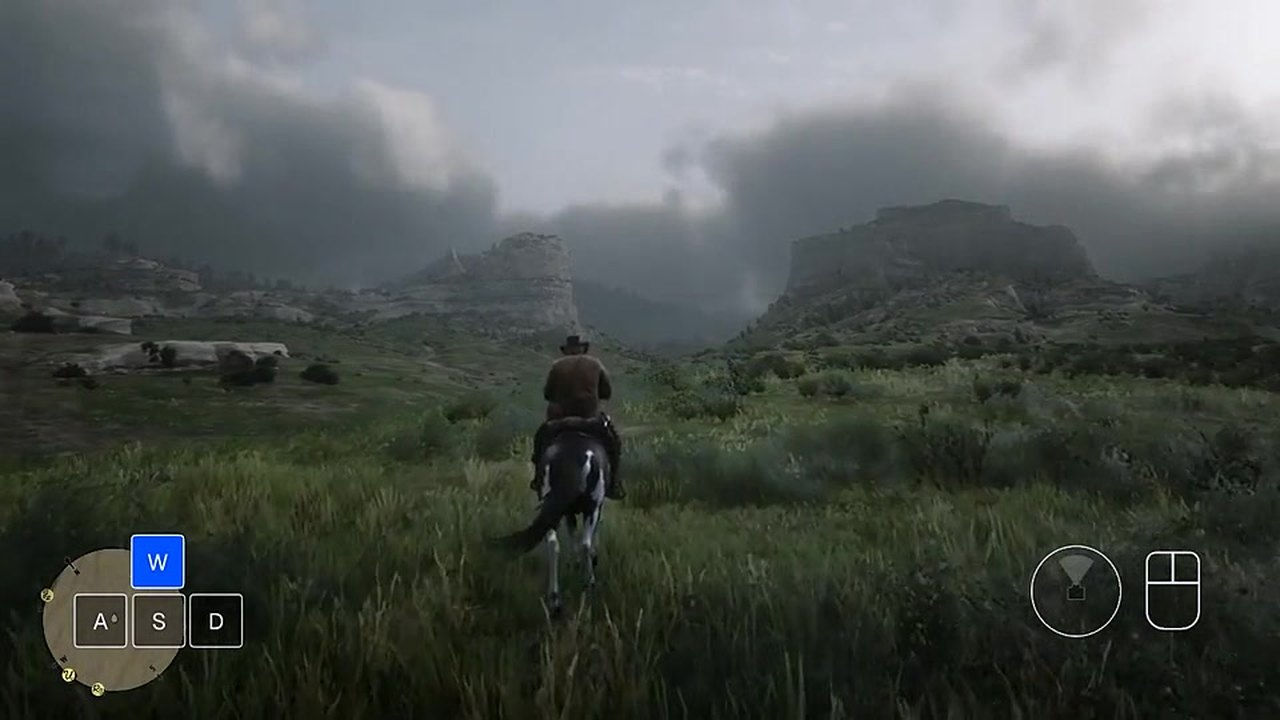
Odyssey-3 cavalgando em Red Dead Redemption 2 com uma política treinada apenas em GTA V. A sobreposição mostra as teclas que ela está pressionando. Imagem: Odyssey.
Um modelo, muitos corpos
O Odyssey-3 é um transformer de difusão autorregressivo treinado com o que a empresa chama de uma vasta coleção de observações visuais, com o objetivo de aprender um modelo geral e causal de como o mundo se comporta. Esse modelo permanece congelado. Para cada tipo de corpo, a Odyssey treina um pequeno decodificador de ações com pares de observação e ação, e a função do decodificador é traduzir o estado interno do modelo de mundo nos controles necessários para aquele corpo.
A alegação é que o modelo congelado concentra a maior parte da compreensão, portanto os decodificadores precisam de pouquíssimos dados. Braços robóticos aprendem com dezenas de horas de demonstrações, e o anúncio mostra um deles se recuperando após não conseguir agarrar um objeto e recuperando-o depois que ele caiu em uma orientação incomum. Humanoides, em um trabalho com a Flexion, aprendem com dezenas de horas de teleoperação. Drones aprendem a voar até pontos de referência com dezenas de horas de voo simulado. O número referente à direção é o mais concreto: uma política treinada com 20 horas de direção simulada percorreu cerca de 77% da distância entre intervenções do motorista de segurança em vias movimentadas da Índia em comparação com uma política treinada com imagens reais. Todas essas são alegações do fornecedor baseadas em demonstrações do próprio fornecedor, e nenhuma delas foi reproduzida fora da Odyssey.
O agente de jogo vê pixels e pressiona teclas
O decodificador para jogos é treinado com gravações de gameplay combinadas com os comandos de teclado e mouse que as produziram. Durante a execução, a política observa os quadros recentes, emite comandos de teclas e movimentos do mouse e acompanha o que acontece em seguida. Não há uma API conectada ao jogo nem acesso ao estado dele. Ela joga como uma pessoa joga em um notebook, e é também por isso que as imagens da demonstração exibem uma pequena sobreposição de WASD no canto: são as teclas que ela está pressionando.
A Odyssey relata sessões prolongadas em GTA V que incluem dirigir, atirar e lutar corpo a corpo. O resultado da transferência é a parte mais impressionante. Uma política de mobilidade treinada com cerca de duas horas de vídeo de GTA movimentou um personagem a cavalo em Red Dead Redemption 2 — um jogo diferente, com outro personagem, veículo e mundo — e pilotou uma motocicleta em Sleeping Dogs. Duas horas não são nada. Isso significa que o decodificador não está aprendendo exatamente “GTA”, mas sim a mapear a noção do modelo de mundo sobre como se deslocar por um lugar para quatro teclas e um mouse.
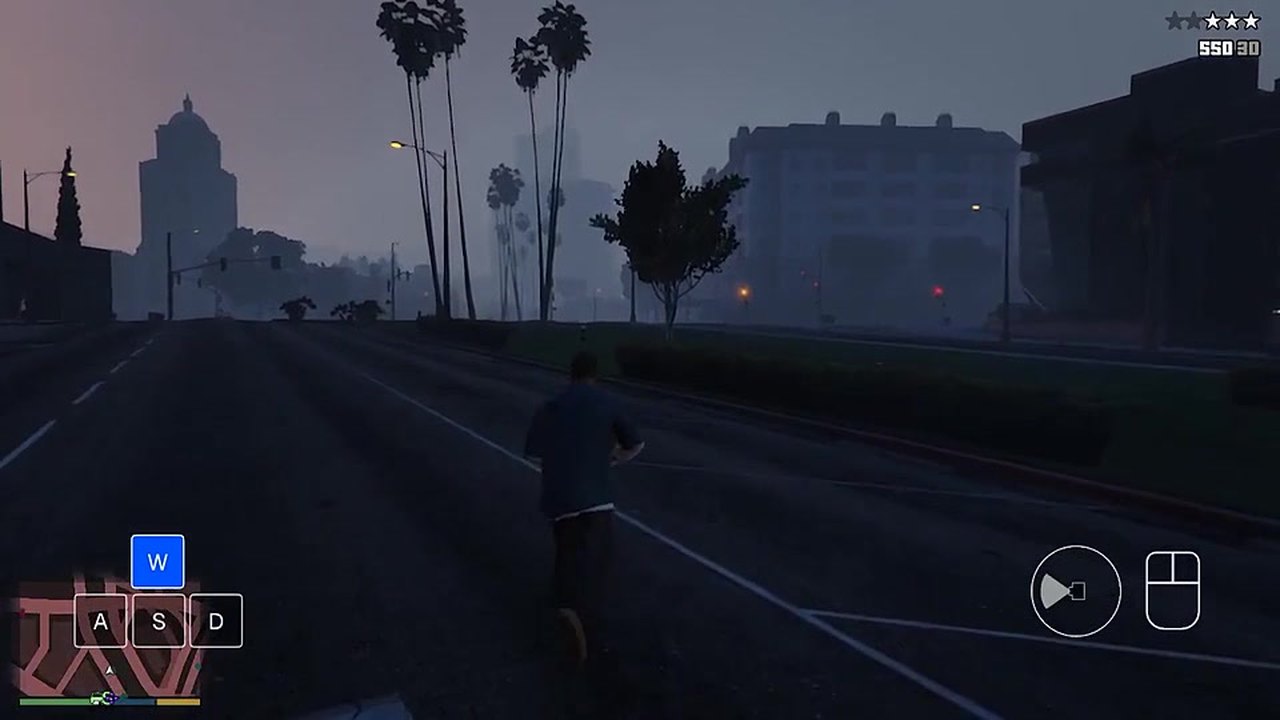
A mesma política em GTA V, o jogo no qual ela realmente foi treinada. Imagem: Odyssey.
O anúncio também mostra o modelo gerando ambientes e permitindo que agentes os explorem, com o argumento de que um simulador bom o bastante pode treinar os agentes que operam dentro dele, enquanto as falhas desses agentes indicam o que o simulador está representando de forma incorreta. Esse ciclo é o produto de fato. Os robôs, carros e jogos são demonstrações de que o ciclo se completa. A Odyssey afirma que disponibilizará o modelo publicamente nas próximas semanas, sem dizer em que formato.
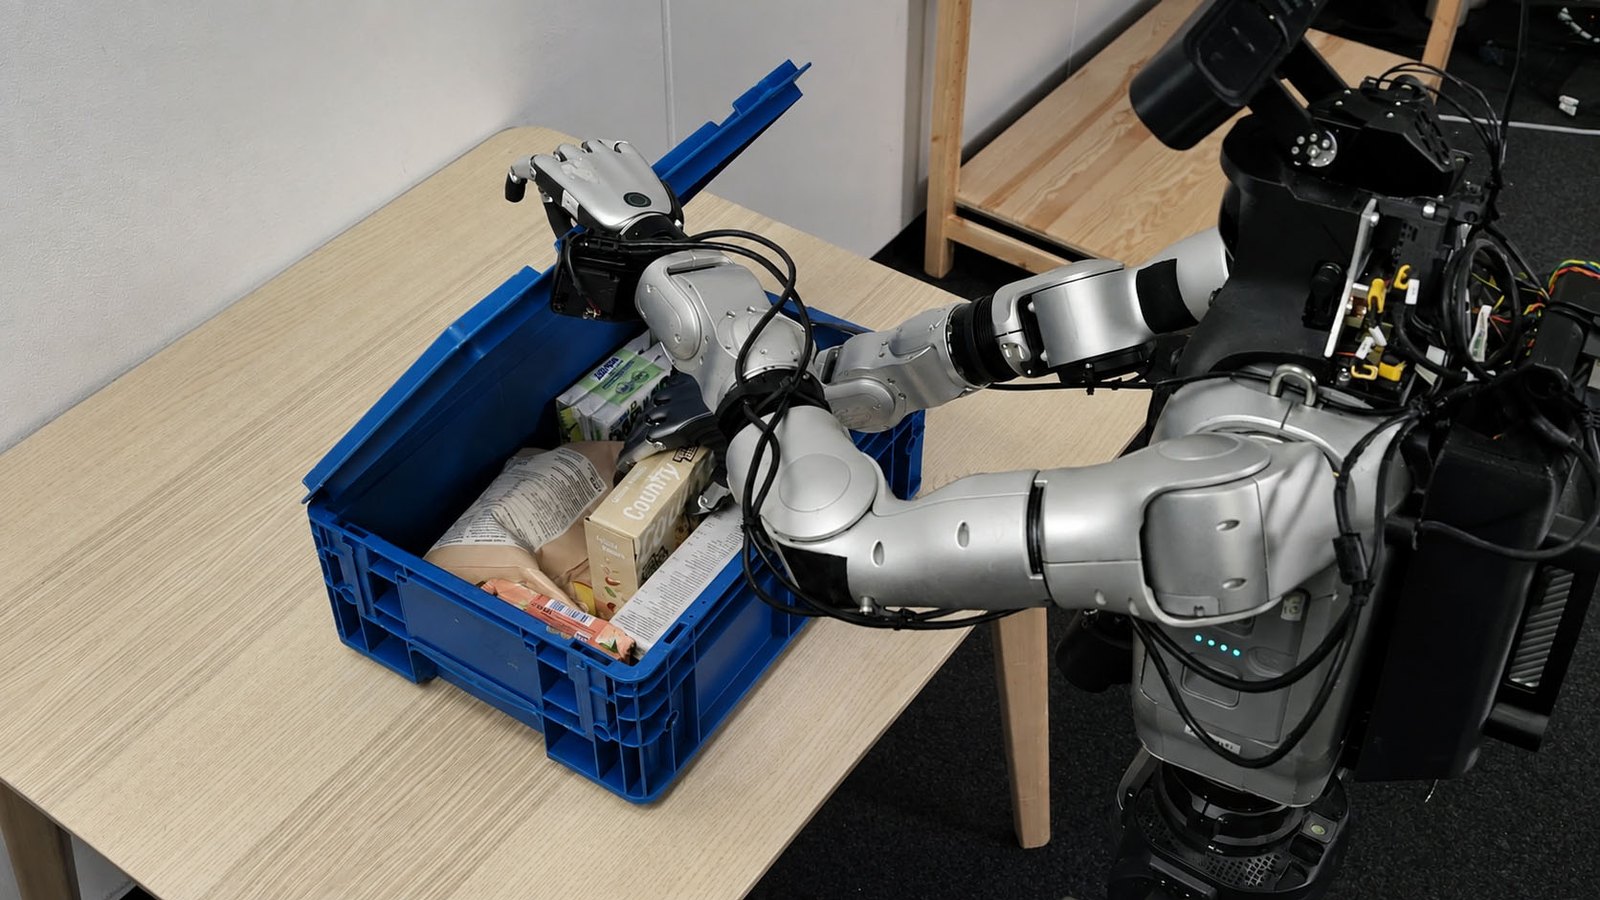
O mesmo modelo congelado controlando um robô de dois braços em uma tarefa com uma caixa de mantimentos. Imagem: Odyssey.
Por que isso nos interessa
Cobrimos três histórias sobre modelos de mundo neste ano, e elas apontam para direções diferentes. O MIRA substituiu o motor do jogo e renderizou uma partida jogável diretamente a partir do modelo. O Atlas da World Labs gera, reconstrói e simula o próprio mundo. O Odyssey-3 não mexe no motor e joga dentro dele. Dos três, esse é o que afeta um jogo que você já criou.
Todos os jogos feitos em nosso Criador de Jogos rodam no navegador e recebem comandos de teclado e mouse, exatamente a interface usada por essa política. Um agente capaz de se movimentar por GTA V com duas horas de vídeo provavelmente conseguiria percorrer um pequeno jogo criado por um usuário com ainda menos dados — e isso seria um testador que nunca fica entediado, não precisa de instruções e pode dizer em um minuto se os controles fazem sentido. Já dedicamos muito esforço a essa questão, porque câmeras invertidas e pulos que não respondem são os motivos mais comuns para o abandono de um jogo novo. Um agente barato que sinalizasse “não consegui passar pela primeira porta” antes mesmo de uma pessoa ver o jogo mudaria a forma como fazemos testes.
Isso também funciona no sentido oposto. Se o deslocamento por um mundo 3D pode ser transferido entre jogos com tanta facilidade, então o lado do modelo de mundo de um agente que joga está perto de se tornar uma commodity, e a parte que importará será o decodificador: como um jogo disponibiliza seus controles, quão legível é o feedback e se um agente consegue perceber que fez a coisa certa. Essas são as mesmas propriedades que tornam um jogo acessível para uma pessoa. Criar para o agente e criar para o jogador talvez acabem sendo o mesmo trabalho.