Löse die Oberfläche, nicht das Skelett
Von Oleg Sidorkin, CTO und Mitgründer von Cinevva
Teil 1 verglich vier Auto-Rigger anhand von zwölf CC0-Tieren mit von Künstlern erstellten Rigs und fand bei allen dieselbe Schwäche: Sie alle bauen Vierbeiner mit nahezu geraden Beinen. Am Ende stand der Plan, die Rigs zu reparieren, denn ein Bein ohne Beugung kann den Kniewinkel eines Künstlers nicht reproduzieren, egal wie gut das Retargeting ist.
Doch während wir über die Ergebnisse diskutierten, kam eine einfachere Frage auf. Warum übertragen wir Animationen überhaupt zwischen Skeletten?
Ein Skelett ist eine Maschine zur Verformung einer Oberfläche. Die Oberfläche ist das, was der Spieler sieht, und der Künstler-Clip zeigt uns bereits für jeden einzelnen Frame und Vertex exakt, wo sich diese Oberfläche befinden soll. Also lassen wir die Zuordnung von Skelett zu Skelett vollständig weg. Wir spielen den Künstler-Clip einmal ab, zeichnen das deformierte Mesh auf und lösen anschließend die Transformationen des automatisch geriggten Skeletts so, dass dessen eigenes Skinning diese Oberfläche so genau wie möglich reproduziert. Das Ergebnis ist ein Clip, der nativ im Raum des neuen Rigs existiert. Seine Bones können von uns aus bone_0 heißen.
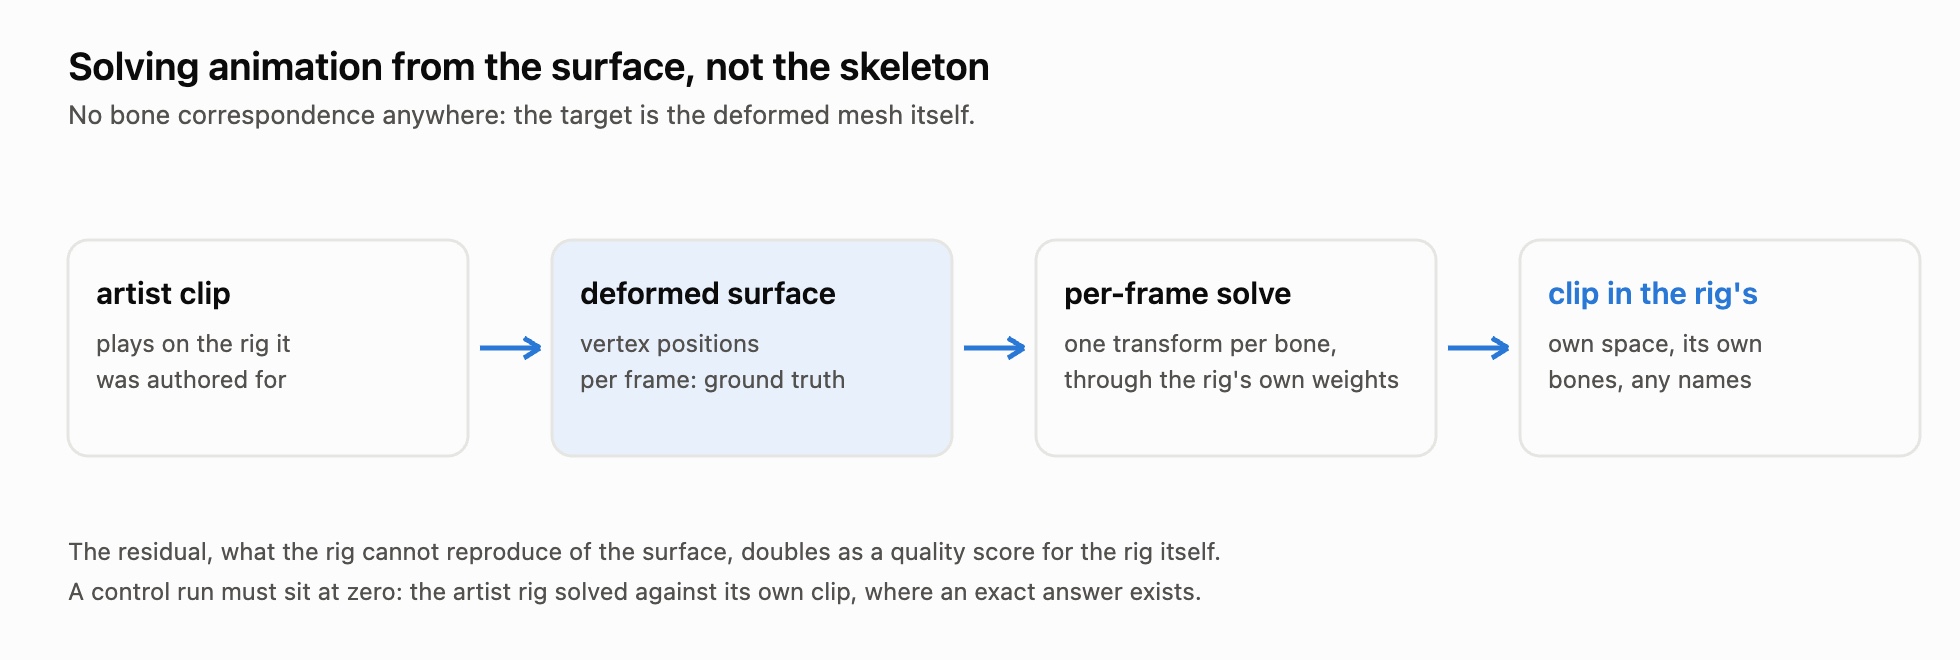
In der Fachliteratur ist das keine neue Idee. Es ist die Transformationshälfte der Skinning-Dekomposition, SSDR von Le und Deng aus dem Jahr 2012, und auf diese Weise passen Motion-Capture-Solver beliebige Rigs an dichte Markerfelder an. Unser Fall ist der einfache: Der Rigger hat Skelett und Gewichte bereits geliefert, sodass nur noch die Bone-Transformationen für jeden Frame unbekannt sind.
Die Methode und die Kontrolle, die sie ehrlich hält
Für jeden Frame suchen wir pro Bone eine Transformation, die den Abstand zwischen der geskinnten Oberfläche des Rigs und der Zieloberfläche minimiert. Bei festen Gewichten besitzt die beste Transformation jedes Bones eine geschlossene Lösung: eine gewichtete starre Anpassung nach Horns Quaternionenmethode. Beim Linear Blend Skinning sind Bones über gemeinsam beeinflusste Vertices miteinander gekoppelt. Deshalb durchlaufen wir die Bones nacheinander, wobei jede Lösung berücksichtigt, welchen Beitrag alle anderen Bones aktuell leisten, bis sich das Residuum nicht mehr verändert. Jeder Frame beginnt mit dem Ergebnis des vorherigen Frames.
Alles läuft im Bind-Raum, in dem die Skinning-Identität unabhängig von den beim Export der Datei verwendeten Konventionen exakt gilt. Die Korrespondenz zwischen dem Künstler-Mesh und dem vom Rigger neu verschweißten oder unterteilten Mesh wird anhand der nächsten Nachbarn in den ausgerichteten Ruheposen bestimmt. Das ist hier exakt, weil beide dasselbe Tier darstellen.
Die wichtigste Designregel: ein Kontrolllauf, der bei null landen muss. Wir lösen das Künstler-Rig gegen seinen eigenen Clip, für den konstruktionsbedingt eine perfekte Antwort existiert. Wenn der Solver sie nicht finden kann, ist alles andere, was er produziert, bedeutungslos. Die Kontrolle landet bei 0,008 % der Modelldiagonale, der einzelne schlechteste Vertex bei 0,08 %. Das ist die Untergrenze, an der alles andere gemessen wird.
Für eine verlässliche Null brauchten wir drei Anläufe
Der erste Kontrolllauf blieb bei 3 % hängen und bewegte sich auch mit dreißigmal mehr Iterationen nicht weiter. Es lohnt sich festzuhalten, warum, denn jede Ursache war von außen unsichtbar.
Das größte Problem war eine API-Falle. Neuere Versionen von three.js haben boneTransform in applyBoneTransform umbenannt und dabei stillschweigend das Verhalten geändert: Die neue Funktion übernimmt ihre Eingabeposition aus dem übergebenen Vektor und liest niemals die Geometrie. Übergibt man ihr einen wiederverwendeten temporären Vektor, berechnet sie jeden Vertex aus dem Ergebnis des vorherigen Vertex. Die resultierenden Ziele waren gleichmäßig plausibler Unsinn und stützten eine peinliche Stunde lang eine detaillierte Theorie über die Armature-Skalierung, die perfekt zu den Zahlen passte und vollständig erfunden war. Der richtige Einstiegspunkt ist getVertexPosition. Die Kontrolle deckte den Fehler auf – und genau das ist das entscheidende Argument für eine solche Kontrolle.
Die beiden anderen Probleme waren kleiner. Die Potenziteration auf Horns Matrix stagniert bei ungefähr einem Tausendstel Grad, weil die spektrale Verschiebung, die sie konvergieren lässt, zugleich die Lücke zusammendrückt, entlang derer sie konvergiert. Deshalb wechselten wir zu Jacobi-Rotationen, die für eine 4x4-Matrix exakt sind. Außerdem ließ ein früher Abbruchtest auf Basis des relativen Fortschritts die Durchläufe stoppen, obwohl sie noch immer langsam abwärts arbeiteten. Der Abbruch misst den absoluten Fortschritt deshalb nun relativ zur Größe des Modells.
Was jeder Rigger tatsächlich übertragen kann
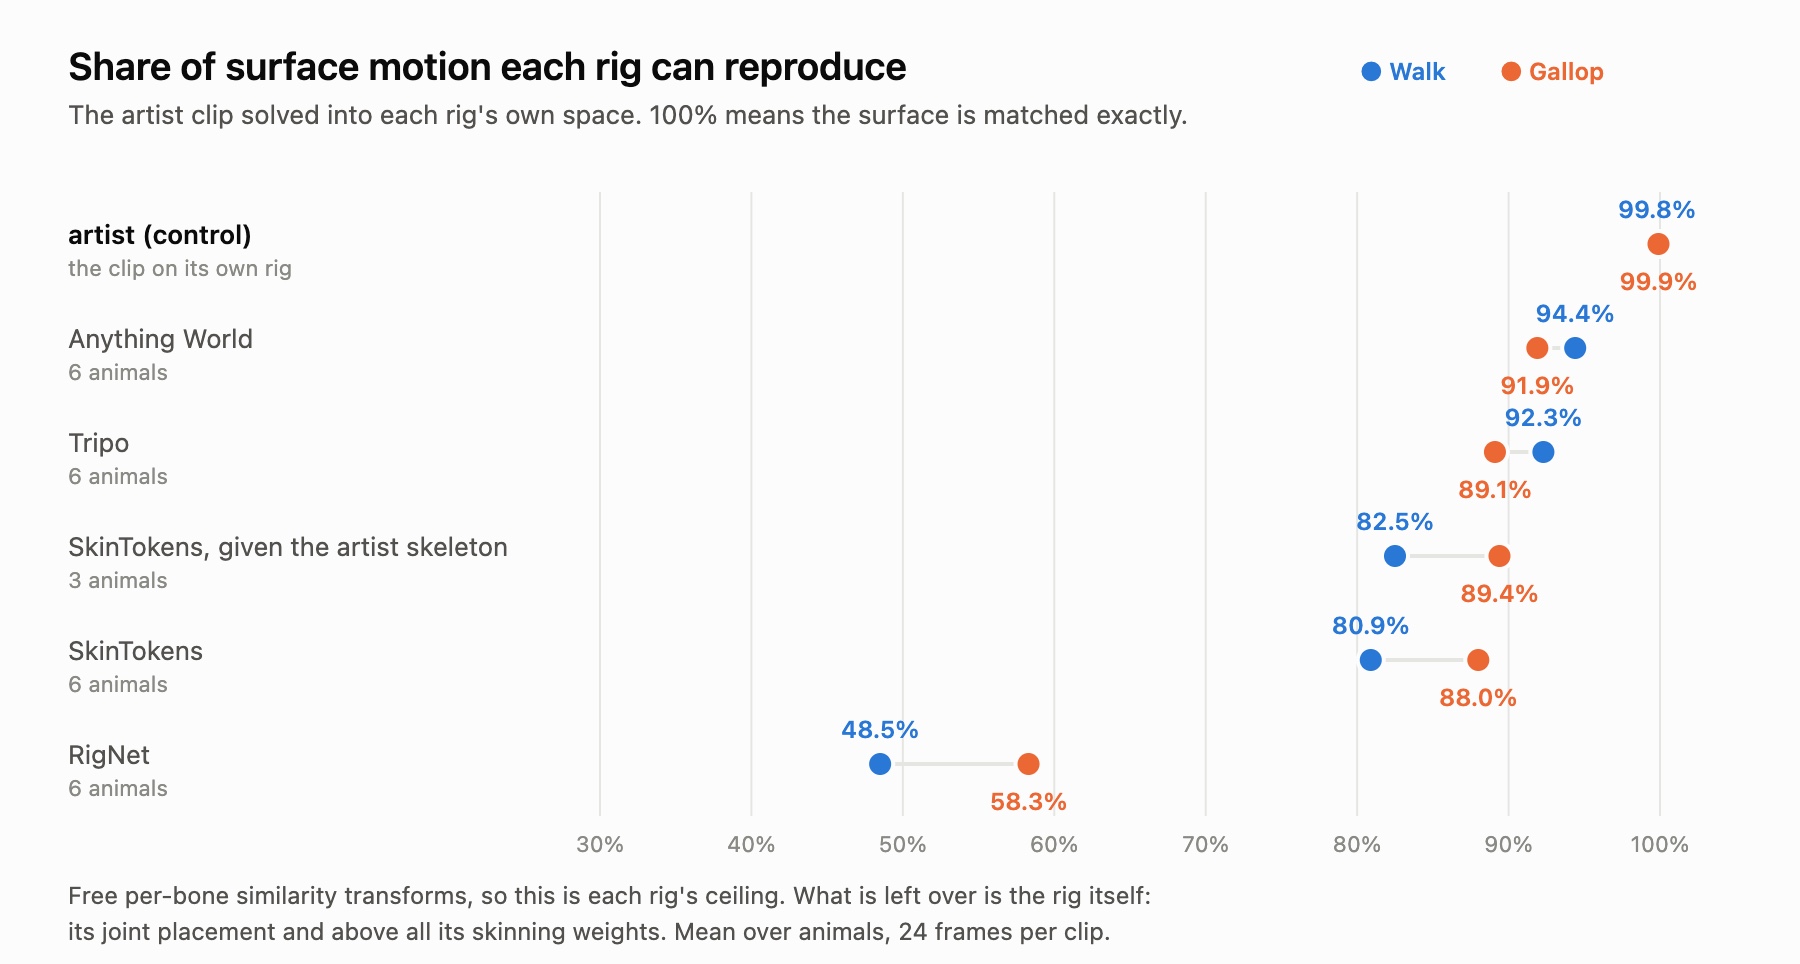
Nachdem der Solver validiert war, lösten wir zwei Künstler-Clips, Walk und Gallop, in jedes Rig für die sechs Tiere, die von allen Riggern unterstützt werden. Der Wert gibt den Anteil der Oberflächenbewegung an, den das Rig reproduziert. Inzwischen haben wir dafür einen Namen: Übertragungsqualität.
| Rig | Walk | Gallop |
|---|---|---|
| Künstler (Kontrolle) | 99,8 % | 99,9 % |
| Anything World | 94,4 % | 91,9 % |
| Tripo | 92,3 % | 89,1 % |
| SkinTokens, mit dem Künstler-Skelett | 82,5 % | 89,4 % |
| SkinTokens | 80,9 % | 88,0 % |
| RigNet | 48,5 % | 58,3 % |
Vergleichen wir das nun mit Teil 1, denn die Rangfolge kehrt sich um.
RigNet hatte von den vier Systemen die beste Beinbeugung und war der einzige Rigger, dessen Skelette bei allen zwölf Tieren unsere Eignungsprüfung bestanden. Hier verliert es die Hälfte des Walk-Clips. Seine schlechtesten Vertices liegen 20 bis 31 % der Modellgröße von der Stelle entfernt, an der sich die Oberfläche befinden sollte. Dieser Fehler tritt bei allen sechs Tieren konsistent auf: Die Qualität liegt bei jedem einzelnen zwischen 38 und 59 %. Tripo und Anything World hingegen – die beiden Rigs mit den geradesten Beinen in unserer Messung – übertragen Animationen am besten.
Die Erklärung ist einfach, sobald man sie ausspricht. Ein gelöster Clip darf Gelenke nicht nur rotieren, sondern auch verschieben, und Translationsspuren pro Gelenk sind ganz gewöhnliche, gültige Animationsdaten. Wenn Translationen erlaubt sind, kann selbst eine gerade Kette einer sich beugenden Oberfläche folgen. Die Beugung ist dann nicht mehr der begrenzende Faktor. Entscheidend ist stattdessen, ob die Skinning-Gewichte das Mesh in Bereiche aufteilen, die den Bones sauber folgen. Die Gewichte der kommerziellen Rigger sind gut. Die über unregelmäßige Ketten verteilten Gewichte von RigNet können der Oberfläche nicht folgen, unabhängig davon, wohin der Solver die Bones bewegt.
Die beiden Messungen beantworten also zwei unterschiedliche Fragen. Das Beugungsverhältnis bestimmt, welche Posen ein rotationsgesteuertes Laufzeit-Rig einnehmen kann – das war die Welt von Teil 1. Die Übertragungsqualität bestimmt, was ein gebackener, gelöster Clip ausdrücken kann – und darum geht es hier. In der Pipeline mit gelösten Clips ist der Rigger, den wir bereits ausliefern, ein 92-%-Rig statt des Schlusslichts.
Ein weiteres Ergebnis verbirgt sich in dieser Tabelle: SkinTokens das Skelett des Künstlers zu übergeben, verändert seinen Wert kaum. Seine Obergrenze wird durch die Gewichte bestimmt, nicht durch die Platzierung der Gelenke.
Anschauen statt einfach glauben
Erst die Zahlen, dann der visuelle Eindruck. Derselbe Solver steuert einen Live-Viewer, in dem das vollständige Mesh jedes Rigs mit den gelösten Transformationen geskinnt wird. Es wird über der Ground-Truth-Oberfläche des Künstlers als dunkle Silhouette dargestellt, und jeder Vertex wird entsprechend seines momentanen Fehlers eingefärbt. Blau bedeutet null. Rot bedeutet 3 % der Modelldiagonale oder mehr.
Das Bild und die Tabelle können nicht voneinander abweichen, denn der Viewer rendert mit exakt der Funktion, die auch die Metrik gemessen hat. Ein Panel braucht einen Hinweis: Beim SkinTokens-Hirsch wird keine Heatmap angezeigt. Sein Mesh besitzt 181.000 Vertices, und oberhalb von 60.000 überspringen wir die Korrespondenzberechnung für das vollständige Mesh. Dieses Panel lässt sich daher nur anhand der Silhouette beurteilen.
Was sich dadurch für uns ändert
Eine Lösung dauert pro Clip und Rig zwischen einer halben und wenigen Sekunden – in Browser-JavaScript und ohne GPU. Das ist günstig genug, um den gesamten Clip-Satz eines Vierbeiners in dem Moment zu backen, in dem das Rig erstellt wird. Gebackene Clips vereinfachen außerdem die Laufzeit: Für Tiere ist überhaupt kein Skelett-Retargeting mehr nötig, sondern nur noch die Wiedergabe des Clips im eigenen Raum des Rigs, ergänzt um unser vorhandenes Foot Locking für den Bodenkontakt.
Außerdem erhalten wir damit ein zweites Akzeptanzkriterium. Die geometrischen Prüfungen aus Teil 1 zeigen, ob ein Rig steuerbar ist. Die Übertragungsqualität zeigt, wie viel von einer echten Animation erhalten bleibt. Ein Rigger kann die erste Prüfung bestehen und an der zweiten scheitern – und genau das tut RigNet.
Grenzen, klar benannt
Der Wert ist die Obergrenze jedes Rigs, kein Versprechen. Der Solver darf Gelenke verschieben, sodass die Bone-Längen während der Bewegung nicht erhalten bleiben. Ein Rig, das sich stark auf Translationen stützt, könnte in Extrempositionen gummiartig wirken. Die schlechtesten Vertices des Gallop-Clips, die selbst bei den guten Rigs kurzzeitig 9 bis 20 % erreichen, treten genau in diesen Momenten auf. Eine ausschließlich auf Rotationen basierende Variante der Lösung würde dafür einen ehrlichen Preis angeben. Diese Zahl schulden wir noch: Sie würde zeigen, wie viel von dem Nachteil gerader Beine aus Teil 1 bestehen bleibt, wenn Translationen nicht zur Verfügung stehen.
Die Lücke zur Produktion ist die Korrespondenz. In diesem Benchmark hat der Rigger dasselbe Mesh geriggt, das der Künstler animiert hat, weshalb die Zuordnung der Vertices trivial ist. Das hochgeladene Tier eines Nutzers ist ein anderes Mesh, und die Oberflächenbewegung des Künstlers zunächst darauf zu übertragen, ist ein eigenes Problem. Dafür gibt es bekannte Ansätze, die wir jedoch noch nicht vermessen haben.
Und schließlich die Stichprobe: sechs Tiere, zwei Clips, 24 Frames pro Clip und auf dem dichtesten Mesh auf fünftausend Vertices reduzierte Constraints. Genug, um die Rigger verlässlich einzuordnen, aber nicht genug, um eine zweite Dezimalstelle anzugeben.
Die Tiere sind CC0-Modelle von Quaternius, die Methode besteht aus vierzig Jahre alter Anpassung mit geschlossener Lösung plus Geduld, und der Kontrolllauf ist der Teil, den wir allen empfehlen würden, die das reproduzieren möchten, zuerst zu bauen. Wenn du bereits Animationen in Rigs gelöst hast und auf dieselben Fallen gestoßen bist wie wir – oder auf andere –, würden wir uns gern in unserem Discord austauschen.