Resuelve la superficie, no el esqueleto
Por Oleg Sidorkin, CTO y cofundador de Cinevva
La parte 1 comparó cuatro sistemas de rigging automático con rigs de artistas en doce animales CC0 y encontró un defecto común: todos construyen cuadrúpedos con las patas casi rectas. Terminaba con un plan para reparar los rigs, porque una pata sin flexión no puede reproducir el ángulo de la rodilla definido por un artista, por muy buena que sea la transferencia de animación.
Entonces, mientras debatíamos los resultados, surgió una pregunta más sencilla. ¿Por qué estamos trasladando animaciones entre esqueletos?
Un esqueleto es una máquina para deformar una superficie. La superficie es lo que ve el jugador, y el clip del artista ya nos indica exactamente dónde debería estar esa superficie, vértice a vértice, en cada fotograma. Así que podemos omitir por completo el mapeo de esqueleto a esqueleto. Reproducimos una vez el clip del artista, registramos la malla deformada y después resolvemos las transformaciones del esqueleto generado automáticamente para que su propio skinning reproduzca esa superficie con la mayor fidelidad posible. El resultado es un clip que reside de forma nativa en el espacio del nuevo rig. Sus huesos podrían llamarse bone_0 y nos daría igual.
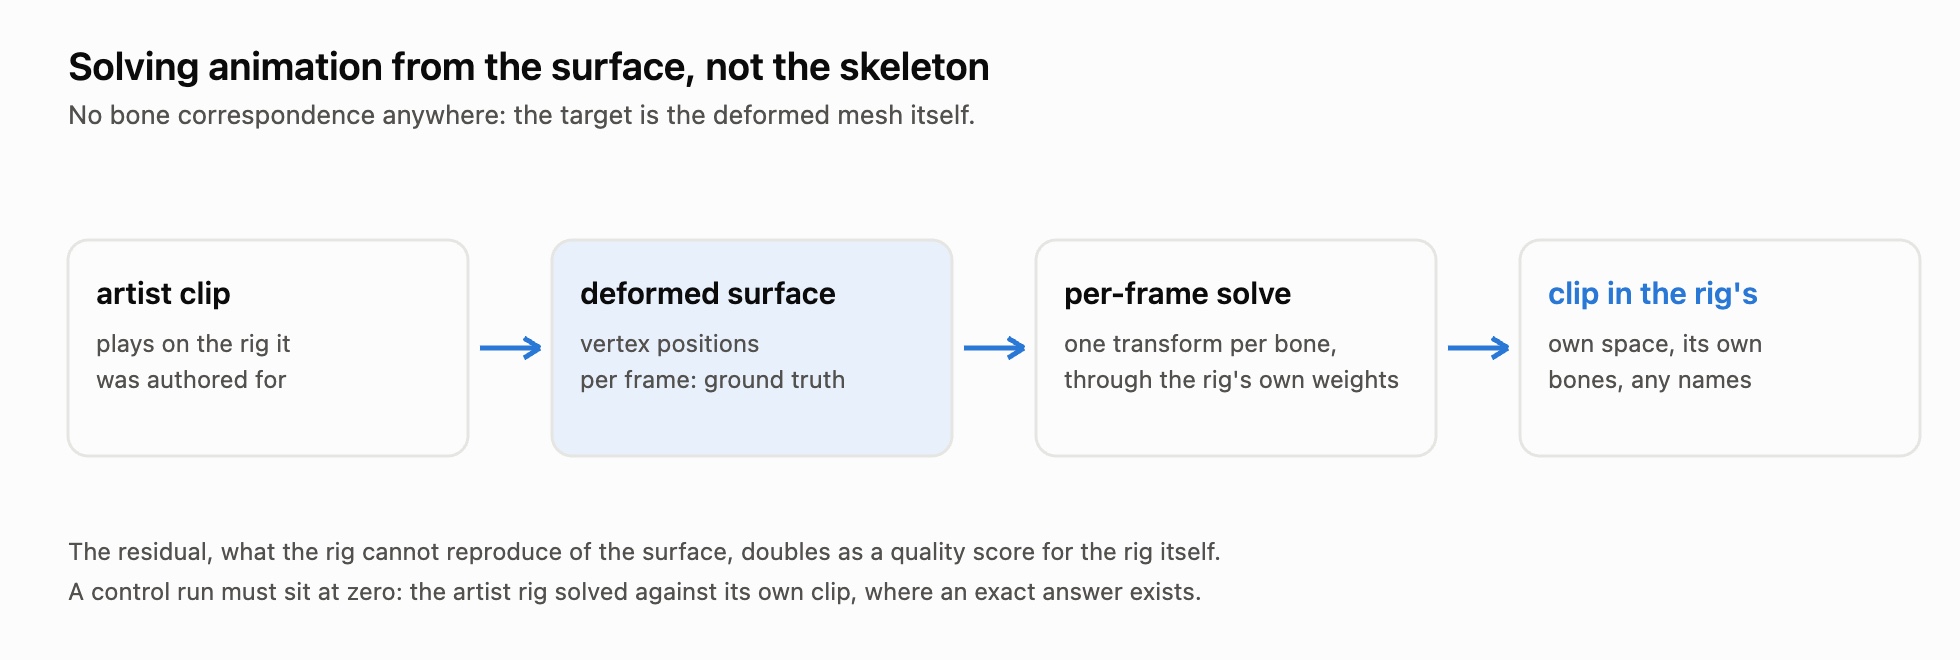
No es una idea nueva en la literatura. Es la mitad correspondiente a las transformaciones de la descomposición del skinning, el SSDR de Le y Deng de 2012, y es el método que emplean los sistemas de captura de movimiento para ajustar rigs arbitrarios a marcadores densos. Nuestro caso es el sencillo: el sistema de rigging ya ha proporcionado el esqueleto y los pesos, así que las únicas incógnitas son las transformaciones de los huesos en cada fotograma.
El método y el control que garantiza su fiabilidad
En cada fotograma buscamos una transformación por hueso que minimice la distancia entre la superficie deformada por el rig y la superficie objetivo. Con los pesos fijos, la mejor transformación de cada hueso tiene una solución de forma cerrada: un ajuste rígido ponderado mediante el método de cuaterniones de Horn. El skinning lineal combinado acopla los huesos a través de vértices compartidos, así que recorremos los huesos por turnos, haciendo que cada resolución tenga en cuenta la contribución actual de todos los demás huesos, hasta que el residuo deja de cambiar. Cada fotograma parte de la solución del anterior.
Todo se ejecuta en el espacio de la pose de enlace, donde la identidad del skinning se cumple exactamente, sean cuales sean las convenciones con las que se exportó el archivo. La correspondencia entre la malla del artista y la malla que el sistema de rigging ha vuelto a soldar o subdividir se obtiene mediante el vecino más cercano en las poses de reposo alineadas, algo exacto en este caso porque ambas representan al mismo animal.
La regla de diseño más importante fue esta: una ejecución de control que debe dar cero. Resolvemos el rig del artista contra su propio clip, donde existe por definición una solución perfecta. Si el solver no puede encontrarla, nada de lo que produzca tendrá valor. El control queda en un 0,008 % de la diagonal del modelo, con el peor vértice individual en un 0,08 %. Ese es el valor base con el que se mide todo lo demás.
Conseguir un cero fiable requirió tres intentos
La primera ejecución de control se estancó en el 3 % y se negó a avanzar incluso con treinta veces más iteraciones. Conviene explicar por qué, porque ninguna de las causas resultaba visible desde fuera.
La principal fue una trampa de la API. Las versiones más recientes de three.js cambiaron el nombre de boneTransform a applyBoneTransform y modificaron discretamente su comportamiento: la nueva función toma la posición de entrada del vector que se le pasa y nunca lee la geometría. Si se le proporciona un vector temporal reutilizado, calcula cada vértice a partir de la salida del vértice anterior. Los objetivos resultantes eran basura de aspecto fluido y verosímil y, durante una hora bastante embarazosa, sirvieron para respaldar una teoría detallada sobre la escala de la armadura que encajaba perfectamente con los números y era pura ficción. El punto de entrada correcto es getVertexPosition. El control lo detectó, y ese es todo el argumento necesario para justificar su existencia.
Las otras dos causas eran menores. La iteración de potencias sobre la matriz de Horn se estanca aproximadamente en una milésima de grado porque el desplazamiento espectral que permite que converja también aplasta la brecha a lo largo de la que converge, así que pasamos a las rotaciones de Jacobi, que son exactas para una matriz de 4x4. Además, una prueba de salida anticipada basada en el progreso relativo detenía los barridos mientras todavía seguían reduciendo el error, por lo que ahora la salida mide el progreso absoluto con respecto a la escala del modelo.
Lo que realmente puede reproducir cada sistema de rigging
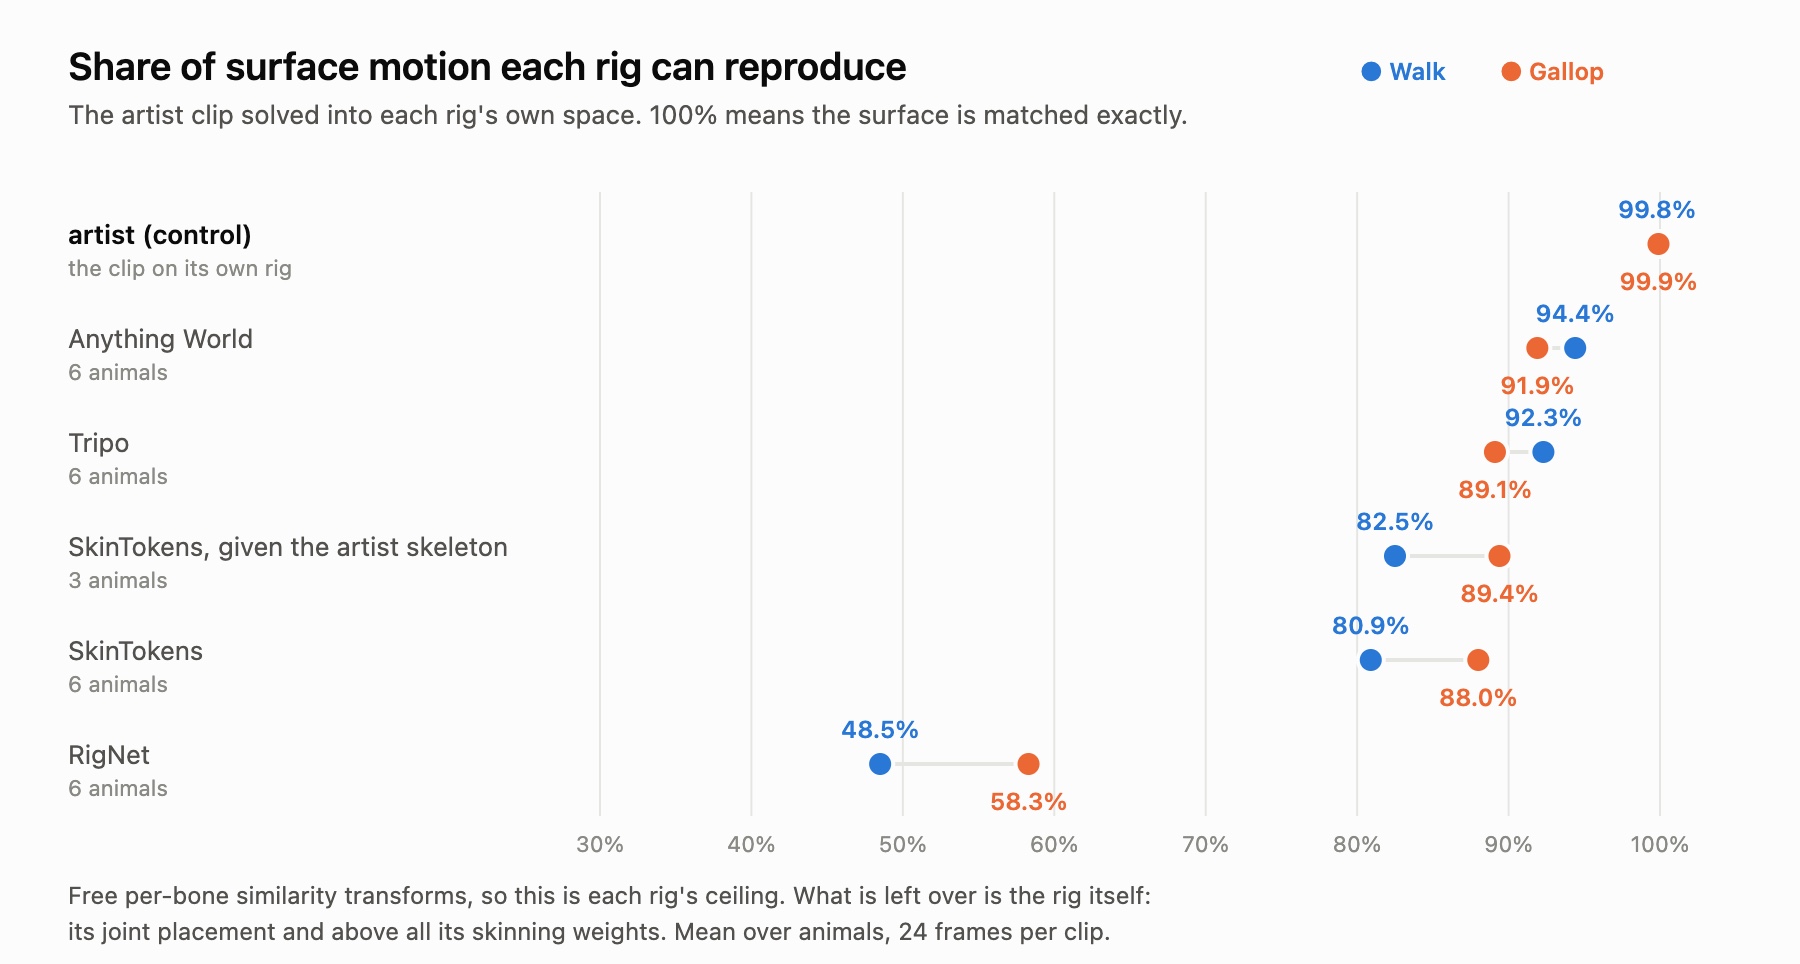
Una vez validado el solver, resolvimos dos clips del artista, Walk y Gallop, en cada rig para los seis animales compatibles con todos los sistemas de rigging. La puntuación representa la proporción del desplazamiento de la superficie durante el movimiento que el rig logra reproducir. Ya le hemos puesto un nombre: calidad de transferencia.
| rig | Walk | Gallop |
|---|---|---|
| artista (control) | 99,8 % | 99,9 % |
| Anything World | 94,4 % | 91,9 % |
| Tripo | 92,3 % | 89,1 % |
| SkinTokens, con el esqueleto del artista | 82,5 % | 89,4 % |
| SkinTokens | 80,9 % | 88,0 % |
| RigNet | 48,5 % | 58,3 % |
Ahora comparemos esto con la parte 1, porque la clasificación se invierte.
RigNet presentaba la mejor flexión de patas de los cuatro y era el único sistema cuyos esqueletos superaban nuestra prueba de controlabilidad en los doce animales. Aquí pierde la mitad del movimiento de caminar. Sus peores vértices quedan a una distancia de entre el 20 y el 31 % del modelo respecto al lugar donde debería estar la superficie, y el fallo es consistente en los seis animales: entre un 38 y un 59 % de calidad en todos ellos. Mientras tanto, Tripo y Anything World, los dos rigs con las patas más rectas que medimos, son los que mejor reproducen la animación.
La explicación es sencilla una vez formulada. Un clip resuelto puede trasladar articulaciones, no solo rotarlas, y las pistas de traslación por articulación son datos de animación normales y válidos. Cuando se permite la traslación, una cadena recta aún puede seguir una superficie que se pliega, por lo que la flexión deja de ser la restricción decisiva. Lo que limita el resultado pasa a ser si los pesos de skinning dividen la malla en partes que siguen limpiamente a los huesos. Los pesos de los sistemas comerciales son buenos. Los de RigNet, repartidos por sus cadenas irregulares, no pueden seguir la superficie por mucho que el solver mueva los huesos.
Por tanto, las dos mediciones responden a preguntas distintas. La proporción de flexión determina las poses que puede adoptar un rig de ejecución controlado mediante rotaciones, que es el ámbito de la parte 1. La calidad de transferencia determina lo que puede expresar un clip horneado y resuelto, que es el ámbito de este artículo. Con el proceso de clips resueltos, el sistema de rigging que ya utilizamos ofrece un rig del 92 % en lugar de quedar en último lugar.
Hay otro resultado oculto en esa tabla: proporcionar a SkinTokens el propio esqueleto del artista apenas cambia su puntuación. Su techo lo determinan sus pesos, no la colocación de sus articulaciones.
Verlo en lugar de limitarse a confiar en los datos
Primero los números, después la inspección visual. El mismo solver controla un visor en vivo donde la malla completa de cada rig se deforma mediante las transformaciones resueltas, superpuesta a la superficie de referencia del artista como una silueta oscura, y cada vértice se colorea según su error instantáneo. El azul representa cero. El rojo representa un 3 % de la diagonal del modelo o más.
La imagen y la tabla no pueden divergir, porque el visor renderiza con la misma función exacta que mide la métrica. Un panel requiere una aclaración: el ciervo de SkinTokens no muestra un mapa de calor. Su malla tiene 181.000 vértices y omitimos la correspondencia de la malla completa por encima de 60.000, así que ese panel solo demuestra el resultado mediante la silueta.
Qué cambia esto para nosotros
Una resolución tarda entre medio segundo y unos pocos segundos por clip y por rig, en JavaScript dentro del navegador y sin usar la GPU. Es lo bastante barato como para hornear todo el conjunto de clips de un cuadrúpedo en el momento de crear el rig. Los clips horneados también simplifican la ejecución: no hay ninguna transferencia entre esqueletos para los animales, solo reproducción de clips en el espacio propio del rig, con nuestro bloqueo de pies actual aplicado por encima para mantener el contacto con el suelo.
También nos proporciona una segunda prueba de aceptación. Las comprobaciones geométricas de la parte 1 indican si un rig es controlable. La calidad de transferencia indica cuánto conservará de una animación real. Un sistema de rigging puede superar la primera y fallar la segunda, y eso es exactamente lo que ocurre con RigNet.
Limitaciones, expresadas con claridad
La puntuación representa el techo de cada rig, no una promesa. El solver puede trasladar articulaciones, por lo que las longitudes de los huesos no se conservan durante el movimiento, y un rig que dependa mucho de la traslación podría parecer gomoso en poses extremas. Los peores vértices del galope, con desviaciones momentáneas de entre el 9 y el 20 % incluso en los buenos rigs, aparecen precisamente en esos momentos. Una variante de la resolución que solo utilice rotaciones cuantificaría este coste con sinceridad, y es la cifra que aún debemos calcular: mostraría qué parte de la penalización por patas rectas de la parte 1 permanece cuando la traslación deja de estar disponible.
La brecha respecto a producción está en la correspondencia. En esta comparativa, el sistema aplicó el rig a la misma malla que animó el artista, por lo que emparejar los vértices es trivial. El animal subido por un usuario será una malla distinta, y transferir primero hasta ella el movimiento de la superficie del artista es un problema independiente, con soluciones conocidas que todavía no hemos medido.
Y después está la muestra: seis animales, dos clips, 24 fotogramas por clip y restricciones submuestreadas a cinco mil vértices en la malla más densa. Es suficiente para clasificar los sistemas de rigging con confianza, pero no para citar un segundo decimal.
Los animales son modelos CC0 de Quaternius, el método consiste en un ajuste de forma cerrada de hace cuarenta años más una buena dosis de paciencia, y la ejecución de control es la parte que recomendaríamos crear primero a cualquiera que intente reproducir este trabajo. Si ya has resuelto animaciones en rigs y te has encontrado con las mismas trampas que nosotros, o con otras distintas, nos gustaría comparar experiencias en nuestro Discord.